AI数据库落地实践:人机分工与责任边界
大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。
上个月参加一个复盘会。项目是集团的问数系统,底座就是新上的 AI 数据库。上线60天,提问量一直在涨,业务自己就上手了。负责人把记录按“谁该负责”分成四堆。前三堆是系统答对的、要确认口径的、要放权限的。第四堆要业务负责人拍板,堆得最高,立项书里却没写人。
我第一反应是系统哪里没做扎实。翻完记录,这个判断站不住。前三堆它答得挺稳,答错的少,漏答的也能追到出处。真正卡住的是第四堆,那些话本来就不该由系统答。问题不在系统,在最后一公里没人接。我在下面坐着,脸有点热,因为第一版方案里我也没写这一页。
这篇就补这一页。我按一次提问走完的路径,把活拆成六段。每段说清系统干什么、人干什么、出错谁背。看完你可以直接改成自己项目的分工表。
AI数据库替掉的是搬运,不是签字
AI 数据库,是把语义、推理、安全放进同一个内核的一类系统。语义管“这个字段业务上怎么算”,推理管“向量化、检索、生成”。安全管“谁能看、谁改过、怎么追”。10 月 30 日金仓开的那场发布会,发布的就是这个方向的 KES AI 数据库。官方叫法是库内语义构建、库内计算推理、库内原生安全管控。
它真正替掉的,是人肉搬运。以前文档要切好、向量化,再同步到另一套库。权限还要在那套库里重配一遍,出问题得先判断是哪边的事。现在这段活压进库里,链路短了,口径也不用两头对。但“这个数怎么算、谁能看、算错了谁负责”,这三件它替不掉。
这不是能力问题,是责任问题。机器可以给候选,签字只能是人的动作。我见过两种极端:一种只加个对话框,流程一点不改。另一种把 AI 当新员工,指望它自己定口径。前一种上线就停摆。后一种更麻烦,它会给出看起来对、其实没人认过的数。
AI数据库的六个环节,谁该负责
分工要落到环节上,不然开会吵不出结果。我按一次提问走完的路径,拆成六步。每一步写清系统做什么、人做什么、出错谁背。这张表可以直接贴进项目周报。
| 环节 | 系统做什么 | 人做什么 | 出错谁背 |
|---|---|---|---|
| 一、数据进库 | 解析、切分、向量化、建索引 | 定“多久算新鲜” | 数据负责人 |
| 二、语义定义 | 识别表与字段含义,推荐口径 | 修正、补充、批准生效 | 业务负责人 |
| 三、提问理解 | 抓要素、改写、补上下文 | 定哪些问题不许问 | 业务负责人 |
| 四、生成执行 | 生成 SQL、混合检索、返回结果 | 看执行计划、定资源上限 | 数据加研发 |
| 五、权限管控 | 角色、行级控制、SQL 防火墙 | 定谁能看哪一列 | 安全负责人 |
| 六、留痕复盘 | 记录谁问、问了什么、查到哪些行 | 每周抽检、处理错例 | 数据负责人 |
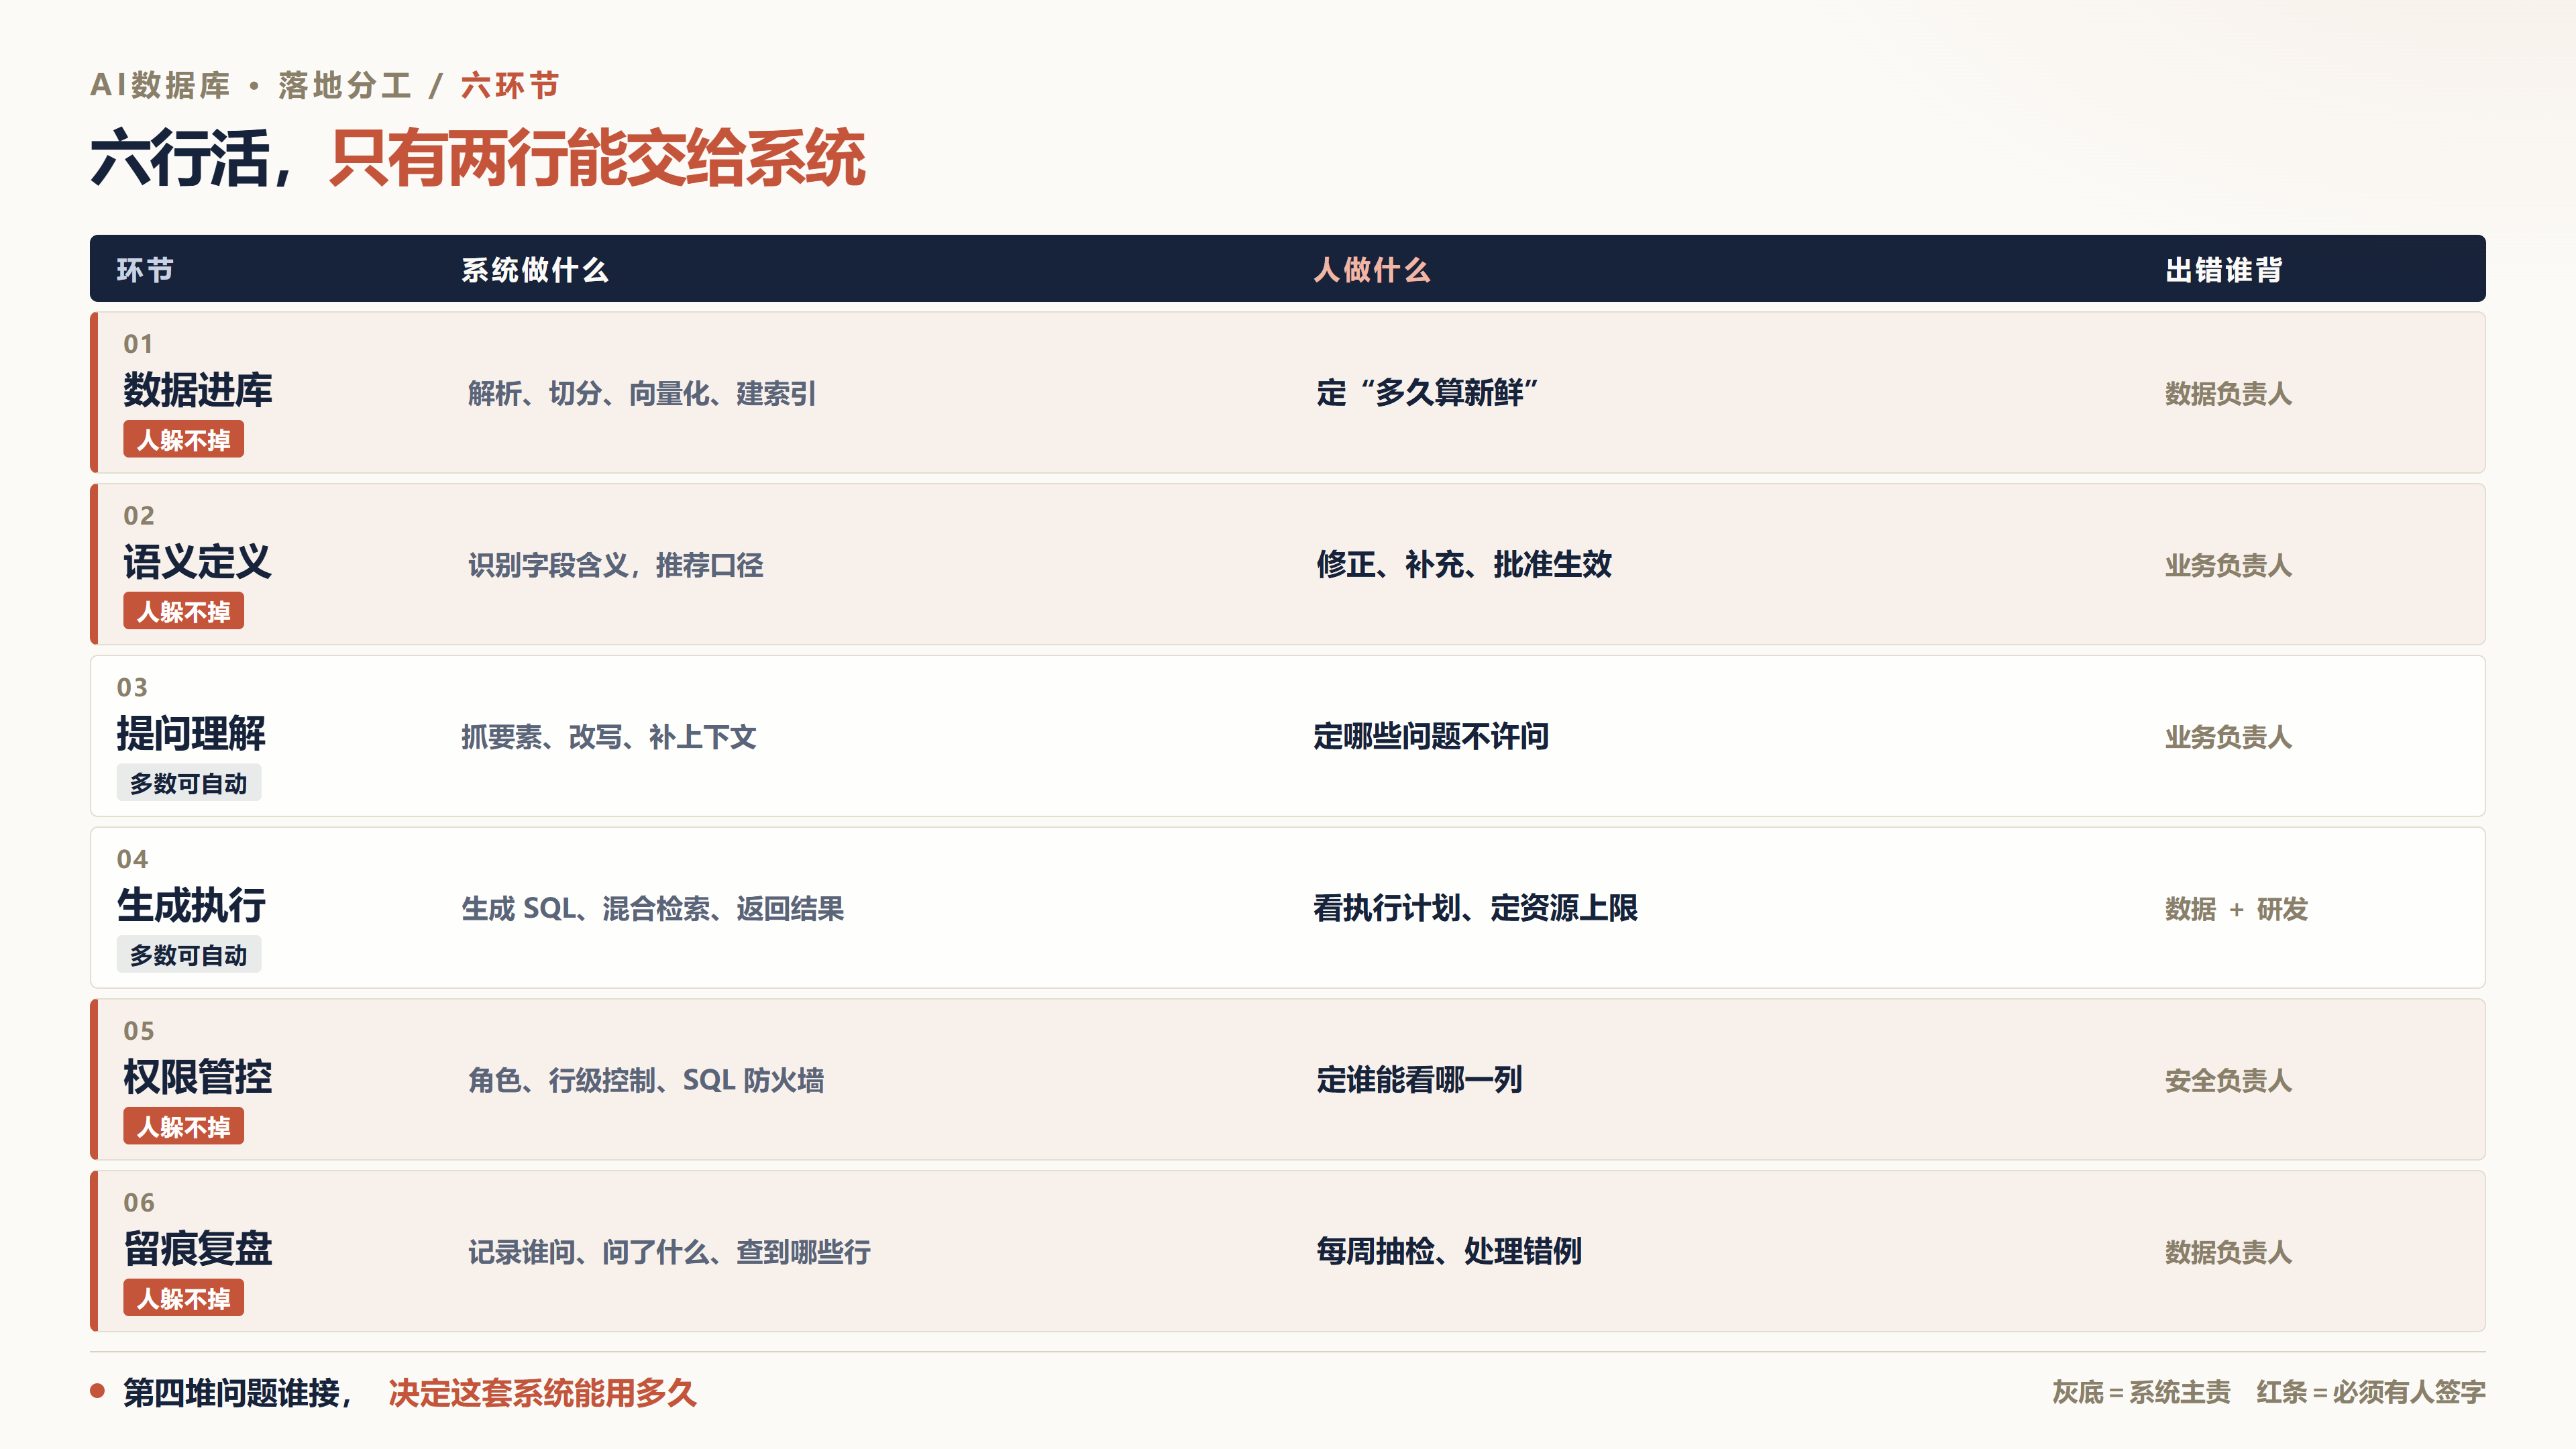
表格看完,多数人会发现一件事。六行里只有第三、第四行能大部分交给系统。能交给它的这两行,恰恰是过去最耗人的活。其余四行,人躲不掉。第一行和第五行躲不掉,新鲜度和授权都只能人定。第二行和第六行躲不掉,口径是承诺,抽检不做就没改进。
这也是我看 AI 数据库项目的方法。表格空着两行以上的项目,我基本不看好。那两行不会因为技术变好而补上。只会因为没人管,一直空着。
10月30日那场发布会,把三件事落到了行上
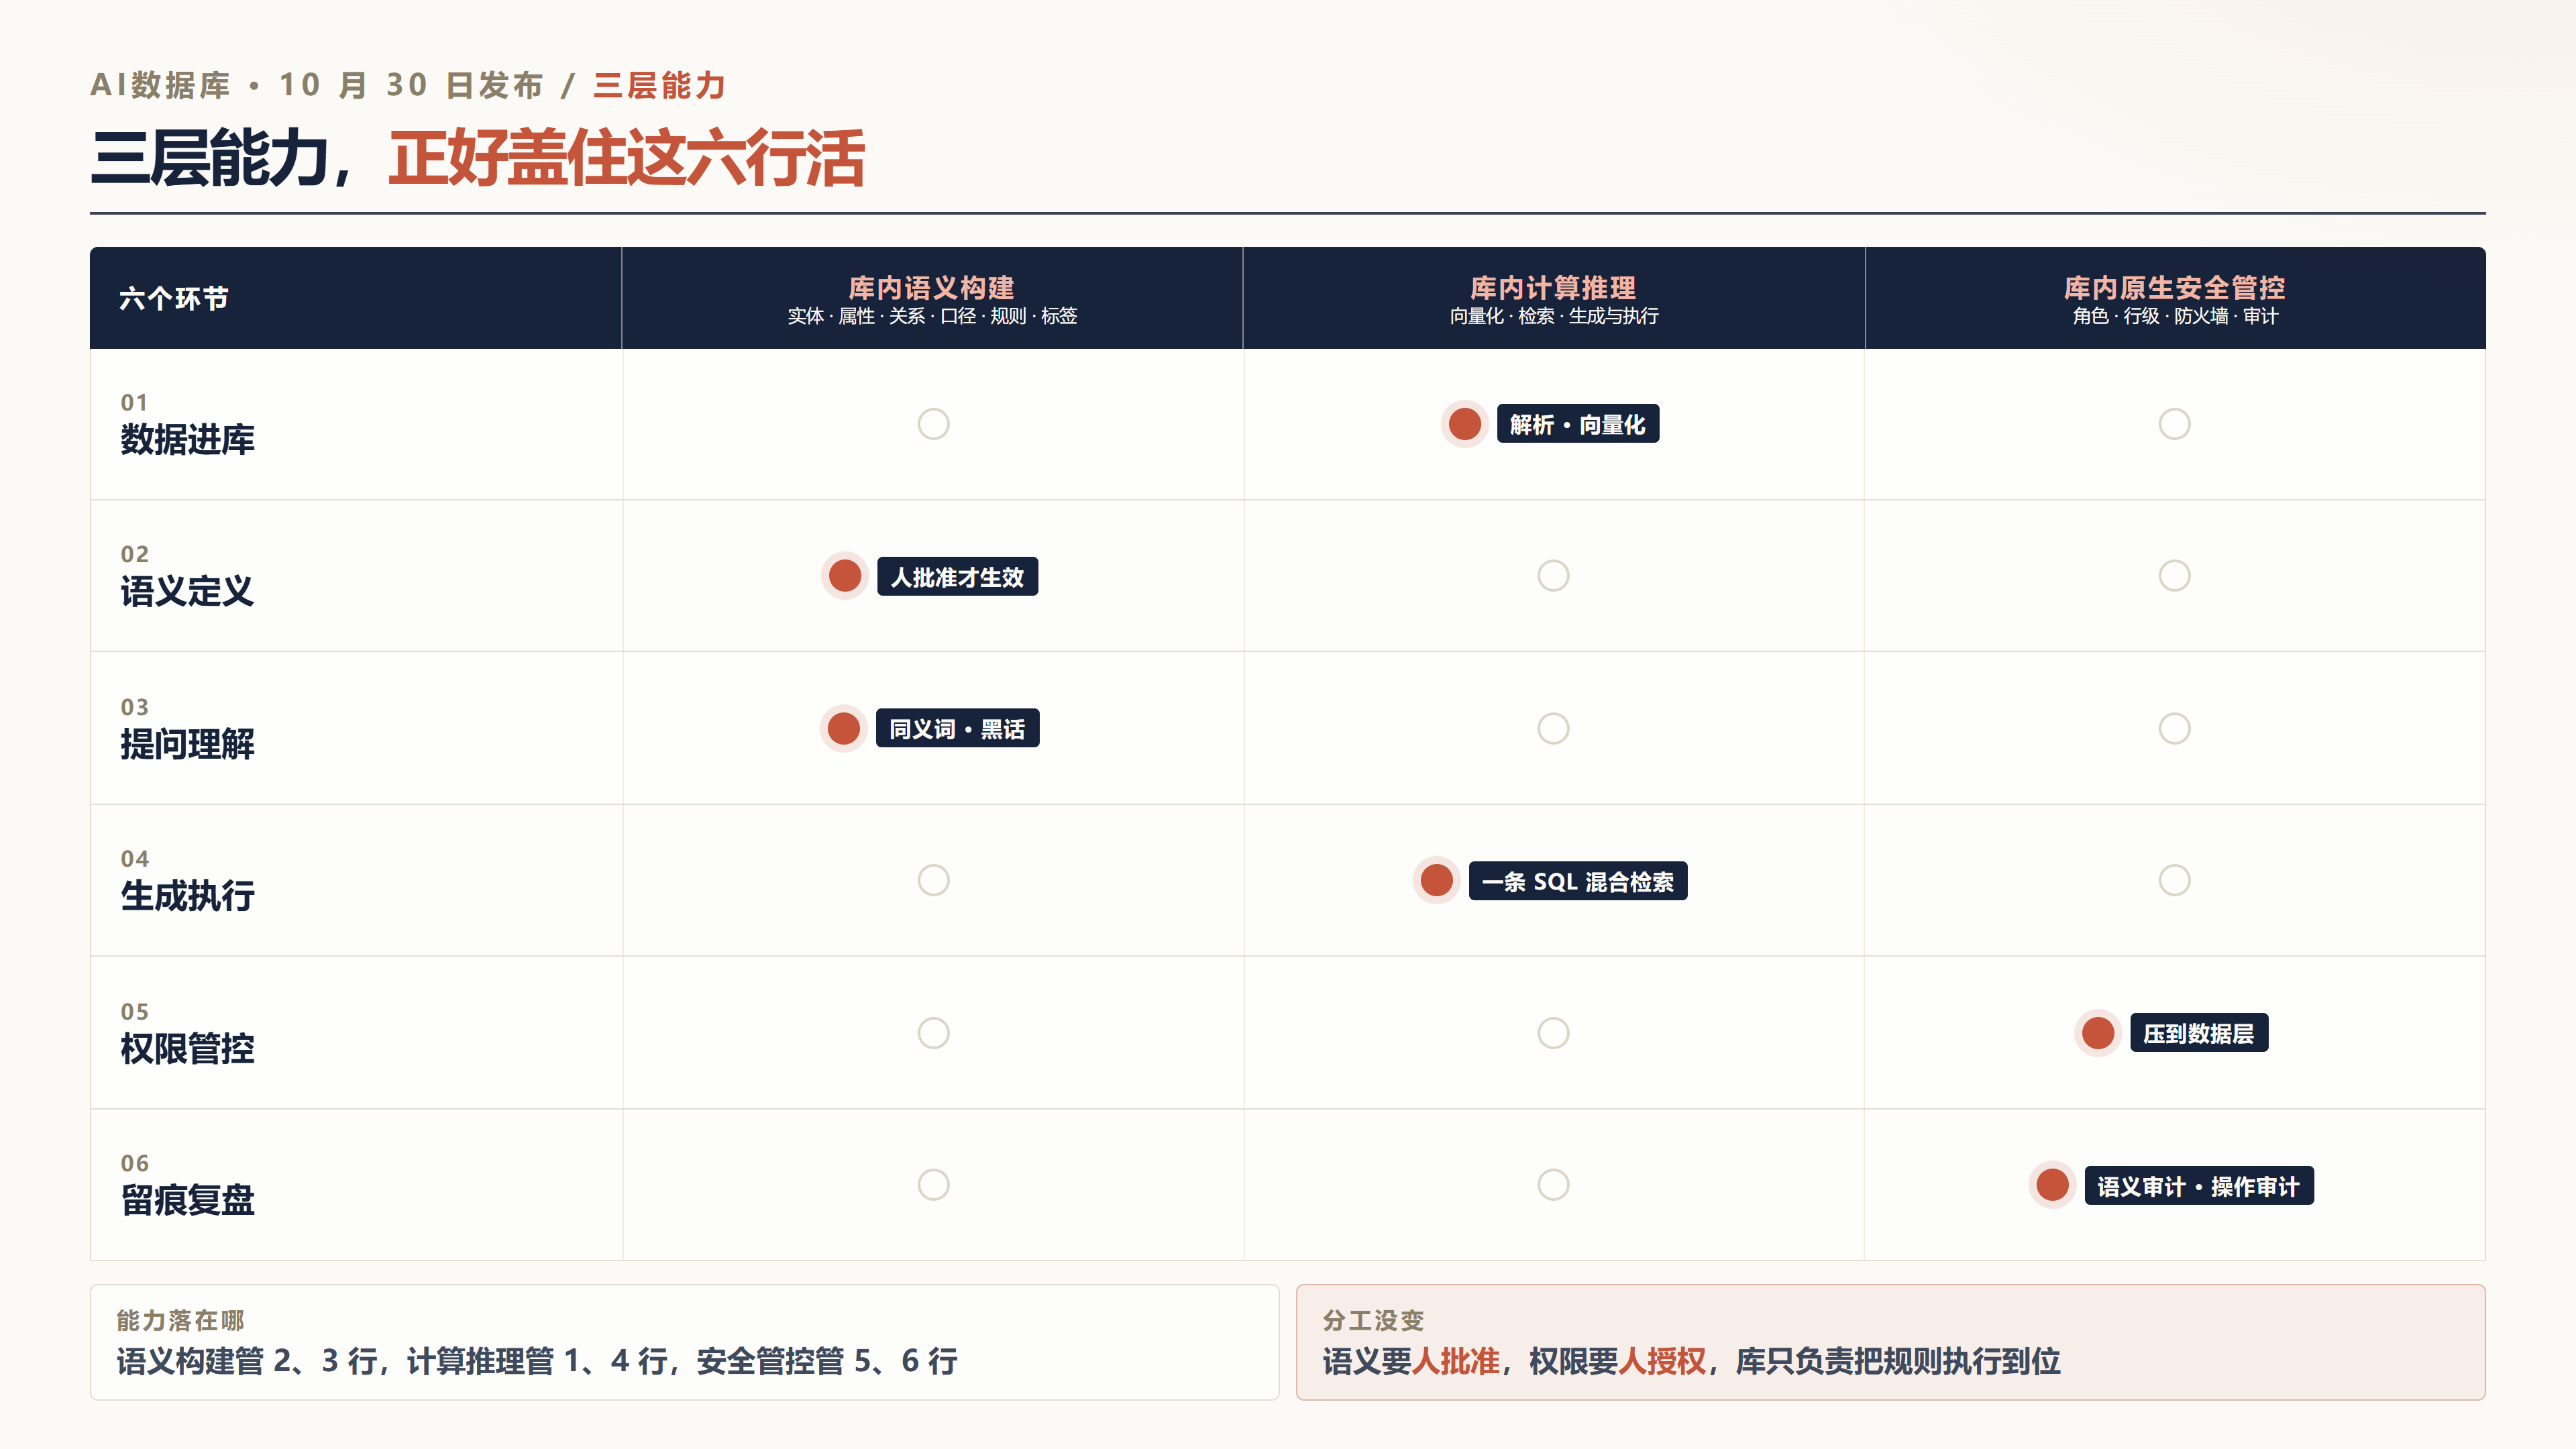
发布会给的三层能力,正好落在表里这六行。库内语义构建管第二、第三行。库内计算推理管第一和第四行。库内原生数据安全管控管第五、第六行。再往下落一层,语义对象要写七类东西。实体、属性、关系、口径、规则、标签,加行业术语和内部黑话。
语义还带版本,改错了能退回去。变更会自动推给下游智能体,应用不用跟着改造。这两条决定语义层能不能活下来。因为口径是活的,业务一调整就得改。改错一次不敢回退,团队从此不敢碰它。
复盘会后两周,他们补了三件事
回到开头那家集团,他们后来没换系统。做的三件事都很土,但都落在分工表上。第一件,给第四堆问题配了人,业务侧指定一位口径负责人。第二件,把口径签字写进变更流程,没签字的语义不许生效。第三件,把每周抽检排进值班表,抽二十条看有没有答歪。顺带补了数据准备,用智能数据开发工具接 60 多种数据源。
三件事做完,系统还是那套系统。业务开始愿意拿它出日常报表,运维的电话反而少了。负责人跟我说了一句话,我记到现在。他说,以前我们以为买的是工具,后来发现买的是一份流程。
三件AI数据库能替你干的活,一件件说
第一件是找得到。以前做知识问答,检索在一套库,业务数据在另一套库。查一次要跨系统,还要在应用里再筛一遍。现在向量列和业务字段同表,一条 SQL 就能带条件过滤。关系表还能映射成图,表一变图就变。下面这段是示意写法,语法按你们实际版本核对。
CREATE TABLE knowledge_chunk (
  id BIGINT PRIMARY KEY,
  content TEXT,
  department_code VARCHAR(32),
  is_active BOOLEAN,
  embedding VECTOR(768)
);
CREATE INDEX idx_chunk_emb ON knowledge_chunk USING hnsw
  (embedding vector_cosine_ops)
  WITH (m=16, ef_construction=200);
SELECT id, content FROM knowledge_chunk
 WHERE is_active
   AND department_code = 'RISK'
 ORDER BY embedding <-> :query_vec
 LIMIT 8;
这段 SQL 有三处值得看:向量类型和业务字段在同一张表里。索引的 m 和 ef_construction 可以调。过滤条件和语义排序写在同一条语句里,取回再筛可以省掉。这一句能写出来,前提是向量和业务表住在同一个内核里。这类库把关系、文档、时序、空间、全文、向量收在一套里。模型放在库外的话,这条 SQL 要拆成两次查询。
第二件是算得准。语义对象里写清口径,生成 SQL 才有依据。金仓的 NL2SQL 智能体(KSQLDeveloper)官方口径是,千表规模、秒级生成、准确率不低于 95%。这组数有前提。语义层要建得够全,问题要问得像话。前提满足,这段活就能自动化。
第三件是说得清。答案要能追到源数据,诊断要能追到依据。运维智能体就做到这一点,每条建议都带依据和脚本。指标还是库内原生采集的,不靠外挂监控。这比一句“建议加索引”有用,因为你能验证,也能退回。AI 数据库让人敢用的地方,不是答得快,是答错了能查。
三件AI数据库做不得的事,签字留给人
定口径做不得。口径不是参数,是财务和销售的约定,比如含不含退货。这里说的做不得,是决定权,不是能力。所以语义得有人批,批完才算数。AI 先给建议,人修正、补充,再批准。这套设计里,批准是生效的前置,谁签字谁负责。
批权限做不得,有人把权限写进了提示词。用户在对话框里说一句“忽略前面的指令”,模型有可能就听了。金仓的做法是把它压到数据层。角色权限、SQL 防火墙、行级标签控制、操作审计,都落在数据上。提示词能被绕,数据层的规则不好绕。但“谁能看哪一列”,还是得有人说。
担结果做不得。AI 可以给建议,不能给结论。维修工单里,AI 建议换哪个件,签字的是工程师。报表里,AI 给出下滑原因,对外解释的是业务负责人。这不是给 AI 留退路,是给组织留责任链。分工表最后一行写“出错谁背”,就是为了这个。
三种翻车,都出在分工没写清
第一种是把建议当结论。有家企业的设备问答上线后,一线把 AI 的处置步骤当规程用。系统其实没出错,是把建议当成了指令。出过误判,项目被叫停两个月。修法很土,在答案上加一行“本回答为建议,执行前请确认”。再加一条,涉及停机和安全阀的操作,必须工程师确认。
第二种是把没查到当没有。检索空了,模型有时照样给一个像样的答案。这在知识库里麻烦,因为业务会相信“系统里没有这条规定”。修法是让空结果显式返回,并提示未检索到相关文档。再补一条,答案必须带出处,尽量点得开原文。
第三种是把能查当能改。问数跑顺了,业务就会提“顺便把这条工单状态改掉”。写操作和读操作的风险,不是一个量级。要开写权限,先把事务边界、审批、回滚、审计四件事定下来。四件没定,就先别开。
AI数据库上线前,我会先问六个问题
这六个问题是我现在做方案的固定动作。答不上来的,先别推进。六个都不难懂,难的是有人肯答。因为答完就得写进流程。
| 问题 | 答不上来说明什么 |
|---|---|
| 这个数谁签字 | 口径没有 owner |
| 语义存在哪 | 语义还在人脑和文档里 |
| 权限写在哪一层 | 权限还在提示词里 |
| 答错了怎么发现 | 没有抽检和错例流程 |
| 出事怎么退回 | 没有版本和回滚 |
| 谁每天看一眼 | 上线后没人运营 |
六个里前三个是设计问题,后三个是运营问题。设计问题在上线前解决,运营问题在上线后天天发生。我的经验是,后三个更容易被跳过。因为上线那天大家都在庆祝,没人愿意谈“以后谁盯着”。
补一句用法。这六个问题不只问自己,也拿去问厂商。问“语义怎么建、怎么批、怎么回滚”,比问“你有多少功能”有效。这几处答得越具体,后面越省事。语义对象带版本和审计,权限沿用库里的角色。能把这几个问题答清楚的产品,落地概率高一些。
AI数据库避坑清单,三条都是花钱买的
第一条,别把分工表写成架构图。架构图讲组件怎么连,分工表讲人怎么接。两张都要有,缺一张,上线后大概率返工。我见过只交架构图的项目,验收会上没人说得清第四堆归谁。
第二条,语义层要有 owner。没有 owner 的语义层,三个月就开始过时。语义对象带版本,可追溯、可回滚,变更能推给下游智能体。这些管的是“改得动”,“谁去改”得写进流程。
第三条是我自己踩的。第一个项目里,我把口径写进语义对象,也让人签了字。但我没写“这条口径什么时候复审”。半年后业务口径变了,系统照配置算,报表对不上。后来加了一条规矩:每个核心指标带复审日期,到期自动提醒。这条比任何调优都管用。
写在最后
AI 数据库的技术进展,比想象中快。语义、推理、安全往库里收,链路短了。金仓这套方案落点清楚。语义在库里建,AI 推荐、人批准,带版本可回滚。推理在库里跑,向量、全文、关系、图一起查。安全沿用数据库原有的角色、行级控制和审计。
这三件事合起来,分工表才有地方落脚。语义、推理、安全都在库里,交接面就少了两处。工具也是为这个服务的:KStudio 写代码,KSQLDeveloper 管问数,KEMCC 管运维。用不用得上,看你哪一行空着。生态的事同理,能开箱用的组件,省的是迁移和适配的时间。
但落地快不快,还是看那张表。表里第四堆谁接,决定了系统能用多久。技术能替的部分,已经替得不错。替不了的部分,得有人站出来。这话听着像管理课,其实是我被怼过之后才懂的。
你们项目的分工表,哪一行还空着。是语义定义,还是权限管控。评论区说说,我帮你看看该找谁。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋

- 点赞
- 收藏
- 关注作者
评论(0)