MongoDB 迁移实践:协议兼容、索引重建与事务落地
大家好,我是数据库小学妹👋我踩过的坑,你别再踩。
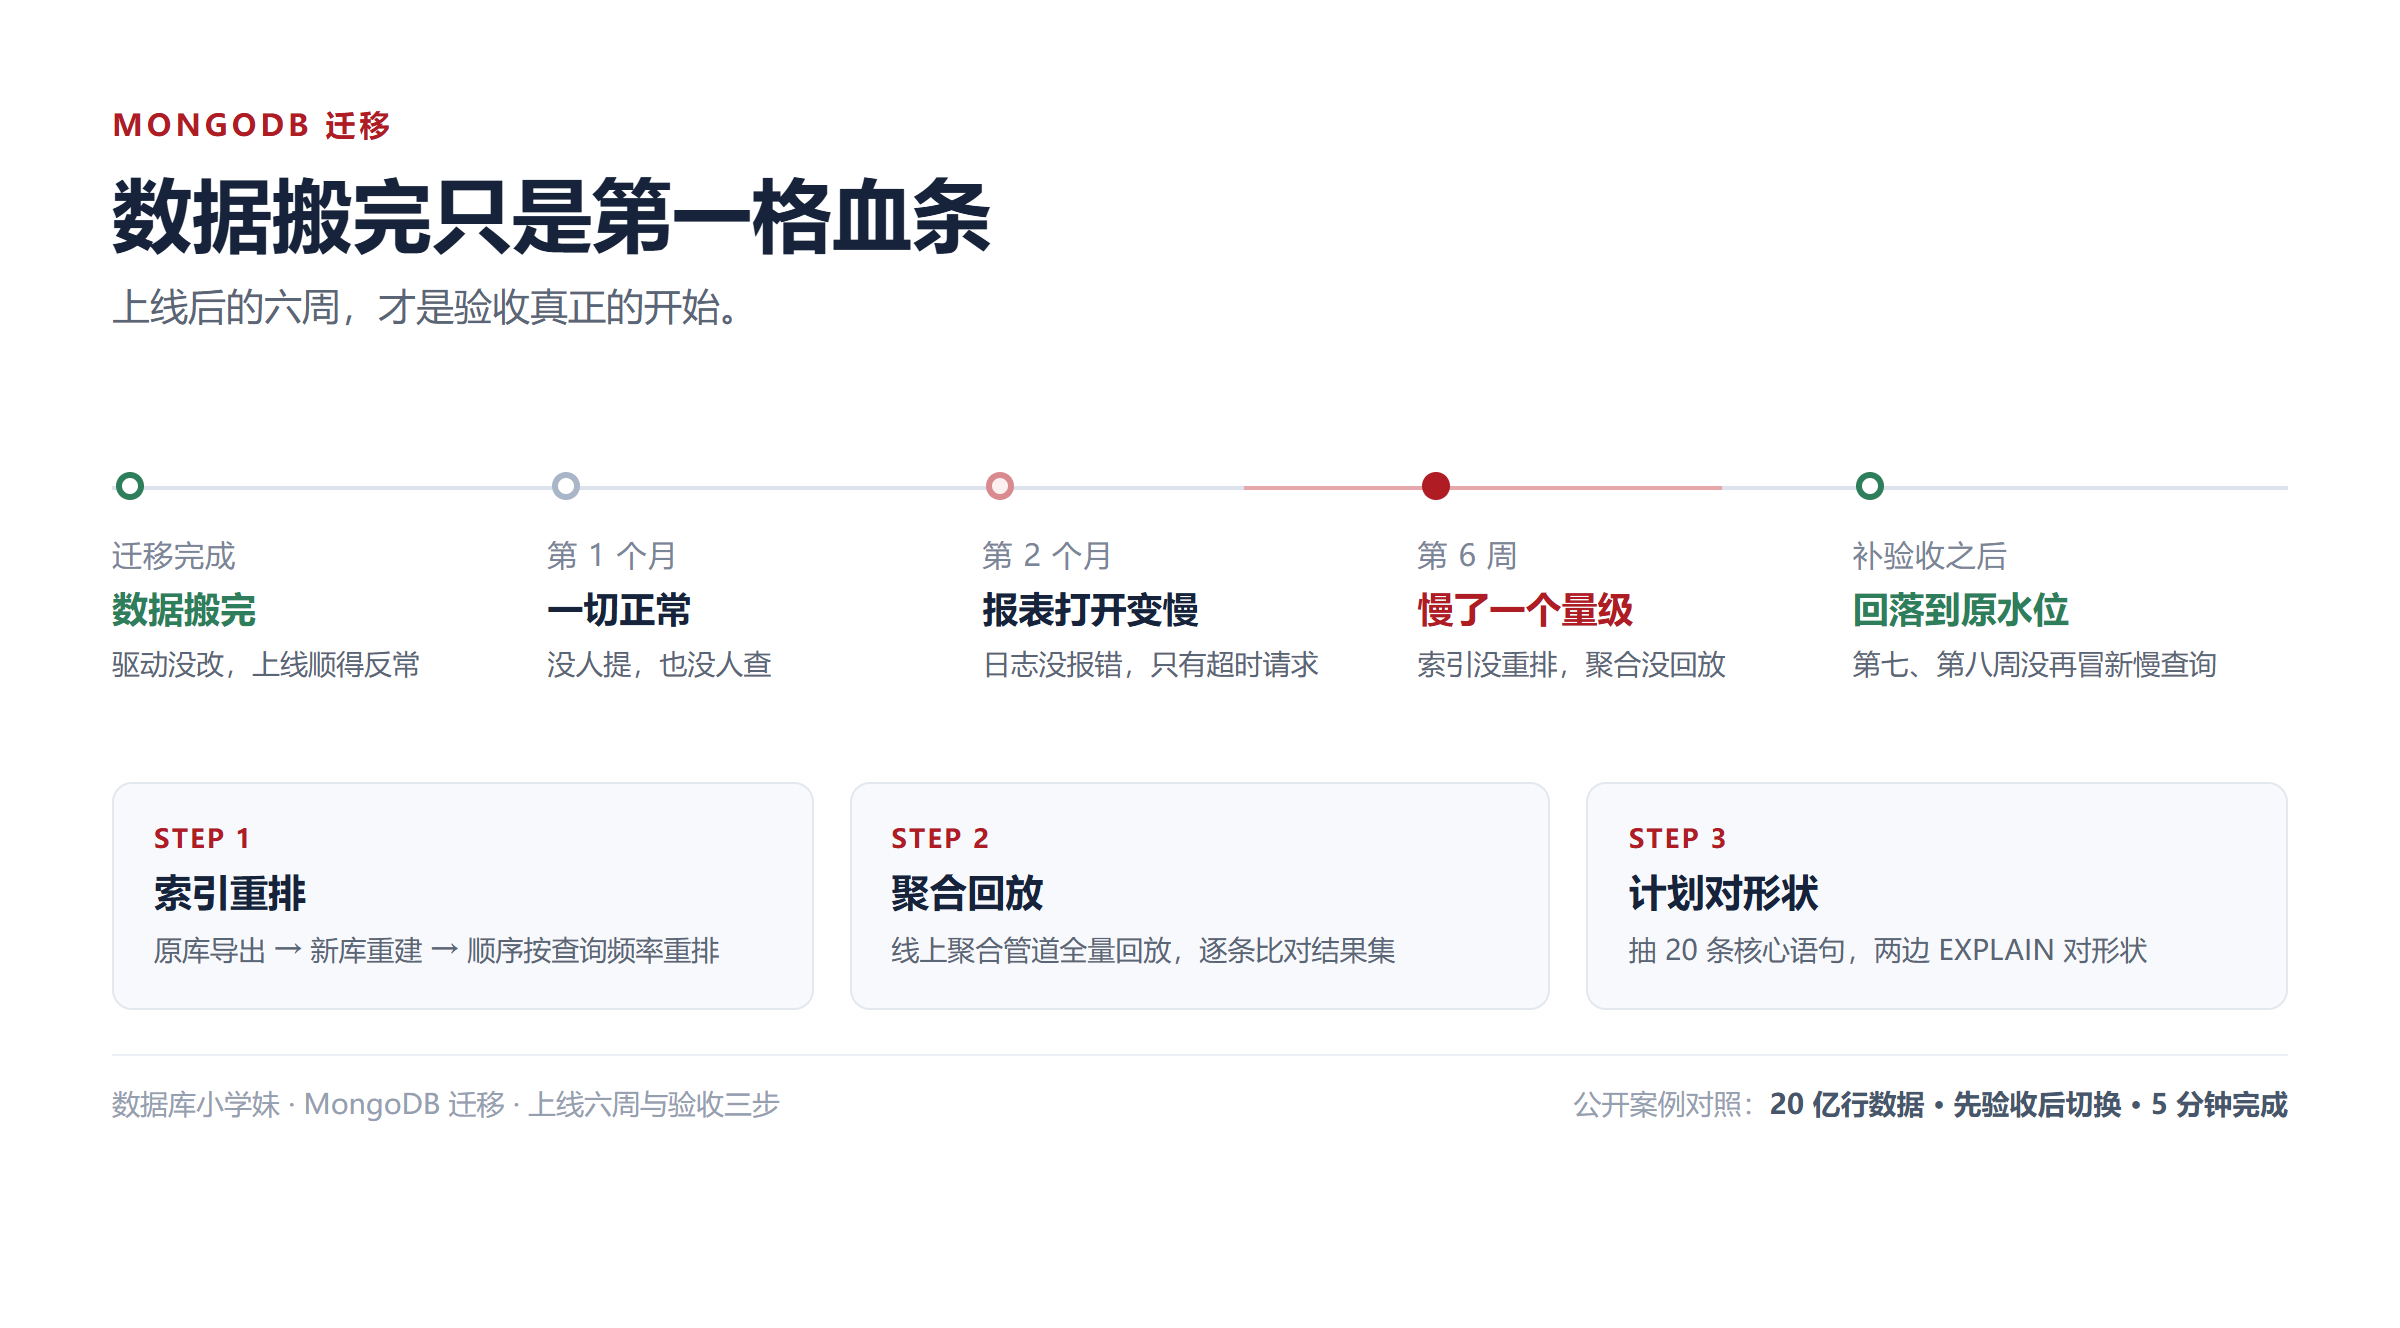
上周一个做在线教育的朋友来找我。他们那套 MongoDB 迁移做完快两个月,报表越跑越慢。数据搬了三天,驱动一行没改,上线头一个月风平浪静。第二个月开始退,到第六周慢了一个量级。我查了两周,结论跟换库没关系。
他来找我,说怀疑库不行。这种怀疑我理解。我先调了监控,CPU、内存、连接数都正常。卡住的是查询,不是库。
我没急着登库,先要了那份迁移方案,翻到最后一章。我问验收那节呢,他愣了两秒,说没单独写。数据条数对得上,就签了。栽跟头的地方,从来不在搬的那几天。
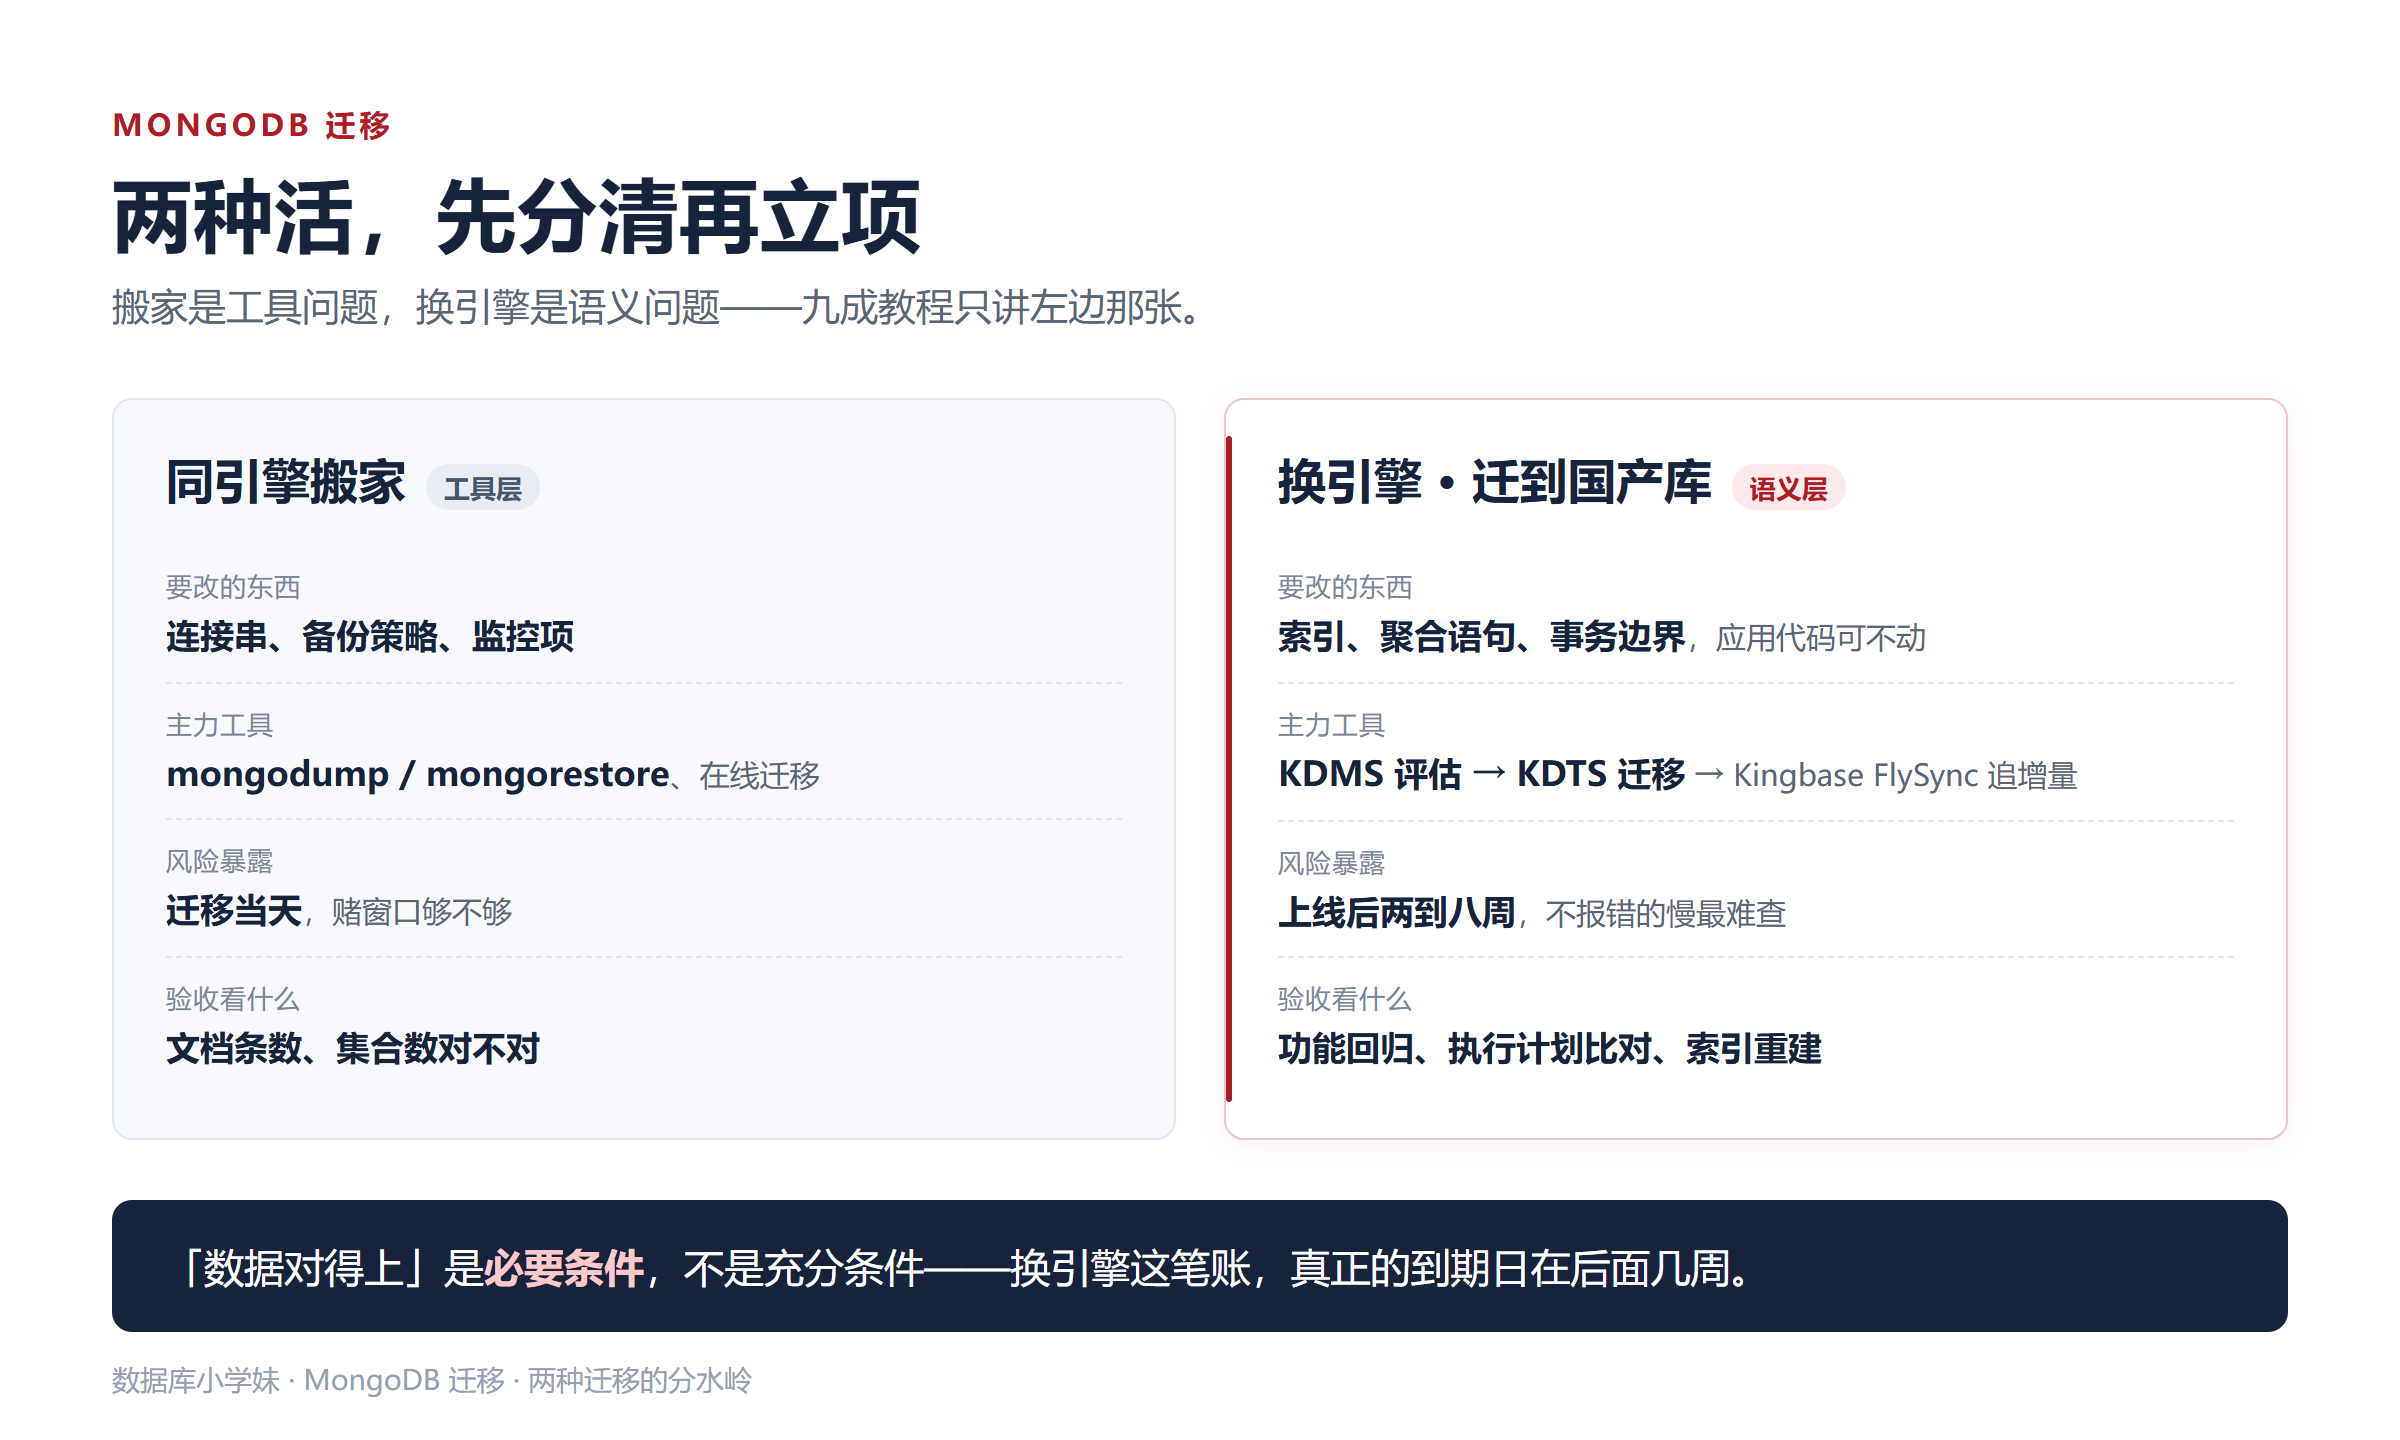
先把话说清楚,MongoDB 迁移有两种活。一种是同引擎搬家,换机器、换版本、上云。另一种是换引擎,把文档数据搬进另一个内核。搬家是工具问题,换引擎是语义问题。
一、MongoDB 迁移的两种活,先分清再立项
第一种活,工具够用就行。mongodump 配 mongorestore,导完再灌回去。数据量大就上在线迁移,边跑边追增量。它真正的风险只有一个,窗口够不够。
第二种活,工具只是入场券。应用还连着原来的驱动,写法也没变。但内核换了,很多东西跟着换。索引怎么建、聚合怎么算、事务管到哪,都得重新对一遍。这事没有标准答案,只有验收清单。差别见下表。
| 对比项 | 同引擎搬家 | 换引擎(MongoDB 迁移到国产库) |
|---|---|---|
| 要改的东西 | 连接串、备份策略、监控项 | 连接串、索引、聚合语句、事务边界 |
| 主力工具 | mongodump/mongorestore、在线迁移 | KDMS 评估、KDTS 迁移、Kingbase FlySync 增量 |
| 风险暴露时间 | 迁移当天 | 上线后两到八周 |
| 验收看什么 | 文档条数、集合数对不对 | 功能回归、执行计划比对、索引重建 |
| 最常听到的一句话 | “窗口不够” | “数据对得上,应该没问题” |
最后一行那句"应该没问题",我在项目里听过太多次。"数据对得上"是必要条件,不是充分条件。它只能证明搬过去了,证明不了跑得动。换引擎这笔账,真正的到期日在后面几周。
二、连接能通,只说明地址没写错
排查是从应用日志开始的。日志里没有报错,只有一条条超时的慢请求。不报错的慢才难查,报错反而好办。这种慢最耗人,什么线索都不给。
接着我登到库上看等待。原来在 MongoDB 上,我盯慢查询和连接数。换到金仓的 KES,视图名和口径都换了。这一步我一开始也搞错了。
能直接连上,是因为协议级兼容。MongoDB 的驱动不用换,客户端也不用改。pymongo、Java Driver、Node.js Driver 都没改代码。技术白皮书写得很明确,能直接替代 MongoDB 5.0 及以上版本。
我后来翻到一份技服同事的部署总结,才看懂这层。KES V9 内置 MongoDB-parser 组件。它在 27017 端口直接应答 Wire Protocol。BSON 被映射到存储引擎的读写路径上。所以兼容是分档的,对齐 4.4/5.0 协议规范,替代范围就是 5.0 及以上。
部署有三个检查点。一是 initdb 的 -m pg -Usystem 参数。二是 shared_preload_libraries 的加载顺序。三是 enable_protocol_compat 和 extension_protocol_port 两项。缺一处,27017 就不监听。
三、索引和聚合,是迁移后最先还债的两处
先说索引,文档库和关系库的索引不是一套逻辑。MongoDB 一个集合能有多个复合索引,字段顺序很讲究。迁过来之后索引要重建,顺序照原来的查询习惯来。最容易跳过的是那些"顺便建的"索引。
我给朋友做的第一件事,是把所有索引导出来对一遍。四十多个集合,索引加起来一百多条。其中17条是历史上临时加的,从来没删过。这些索引在原库上没出事,是写入压力还没到顶。导索引不用写复杂脚本,几行就够:
// 把每个集合的索引导出来,逐个对一遍
db.getCollectionNames().forEach(function (c) {
  var idx = db.getCollection(c).getIndexes();
  print(c + " -> " + idx.length + " 条");
  idx.forEach(function (i) { printjson(i.key); });
});
重建到 KES 上这一步,比我预想的省事。单字段、复合、全文、地理空间索引都能直接建。它还有自动索引管理,能看出哪些索引真被用上。这意味着不用为了迁就索引能力改业务写法。
再看聚合,这是换引擎时最容易翻车的地方。MongoDB 的聚合管道是分阶段流式处理的。$match 放前还是放后,性能差一个量级。迁过来之后,管道会翻译成另一套执行路径。
白皮书里写着,聚合阶段操作兼容 90% 以上。剩下那一小截,就是你要在验收里单独列出来的。我的做法是把线上聚合语句全部抓出来跑一遍。抓不到的,就等它上线以后来找你。
这两处对完,我的判断很清楚。问题不在库能不能扛,在我们的验收没做。索引没重排、聚合没回放,换哪一家的内核都会慢。这话我跟朋友说了,他也认。
四、事务边界变了,代码得跟着走
朋友那套系统里有个审批流。一个审批动作要同时写三条文档。在原库上这三条是分开写的,靠应用层补偿。补偿代码写了两百多行,注释比代码还长。
这类补偿逻辑,是迁移里最容易被忽略的存量债。它在原库上跑得好好的,谁也不觉得要改。可一旦新库支持多文档事务,这笔债就能直接销掉。那两百多行代码,可以删了。
他们那套 KES,单文档 ACID 和多文档事务都支持。更关键的一点,文档和关系表共用同一套事务引擎。一个事务里可以同时提交文档更新和关系表更新。原子性由数据库保证,不用应用层再去兜。
这件事我的理解是,它不是功能变多,是责任下移。原来应用层要保证的事,现在数据库层能保证。少一层兜底,就少一处出错。这种收益不在压测报告里,会出现在故障复盘。
五、文档和关系放一个内核,很多跨库活就没了
那家教育平台还有个老问题。订单和课程在关系库,用户行为和题库在 MongoDB。两张报表要两边一起用,做法是 ETL 到中间表。中间表每天跑一次,对不上就重跑,一重跑多等两小时。
这类活的成本不在开发,在每天的等待和对账上。更难的是数据口径,中间表一多,谁都不确定哪个数准。这套做法别的项目也普遍。本质是给两个库打补丁。
换成 KES 之后,数据模型都收进一个内核。关系、文档、时序、向量、GIS、文本,统一存储。混合访问和模型间转换,都在库内完成。原来要跨库拼的查询,现在一条语句就能下去。中间表那套可以退场。
规模再往上走,它还有个分布式形态,叫 KES Sharding。他们的资料里有一张和 MongoDB 的能力对照表。线性扩展、故障隔离、文档存储,两边都列了。它也额外列了多主复制和跨分片查询。
六、复盘:20 亿行数据,5 分钟切完
2026 年 9 月,金仓讲过一个石化行业的落地案例。茂名石化的自控平稳率系统,原来用 MongoDB 存设备日志和运行数据。这次要迁的历史数据超过 20 亿行。这是石化领域头一个关键业务系统上的 MongoDB 国产替代。
目标定得很硬,应用零代码修改、数据零丢失、业务零中断。思路是让数据库兼容业务,不是让业务适配数据库。策略叫"全量迁移 + 增量同步 + 双重校验"。全量走 KDTS,增量走 Kingbase FlySync,跑完再校验。
真正让我注意的是收尾。他们在测试环境做完功能验证和性能压测,才动生产。新老系统切换用了 5 分钟,他们当时的原话是"泡杯茶就上线"。数据一条没丢,一致性误差控制在 0.1% 以内。上线后高峰支撑每秒 2800 多次写入,可用性 99.999%。
这几个数我最看重的不是性能,是那句"先验完再切"。换引擎能 5 分钟切完,靠的不是手快。是前面把该验的都验完了。这跟我那个朋友的项目刚好是两面。他省掉的三周验收,后来用几个月的排查补回来。
上线后的账更能说明问题。他们对外报的工期,比传统替换方式短 75%。背后是应用层零改动,没有代码重写这一块。运维工作量减了约 35%,因为 DBA 不用再学一套体系。成本降约 70%、年度维保支出降 28%。拆开看,就是少养一套文档库。
朋友那套系统后来照这个思路补了三件事,不多但够用。第一件,把一百多条索引按查询频率重排。第二件,把线上聚合语句抓出来全跑,改掉三处。第三件,把审批流那三条写入收进一个事务。三件事做完,两百多行补偿代码也能删了。我把它写成了固定清单:
# 换引擎之后的验收三步
1) 索引:原库导出 → 新库重建 → 字段顺序按查询频率重排
2) 聚合:线上管道全量回放,逐条比对结果集
3) 计划:抽 20 条核心语句,两边 EXPLAIN 对形状
结果不需要我吹。那几个接口回到了迁移前的水位。第七周、第八周都没再冒出新的慢查询。清单上的项一条条划掉,比任何一句"没问题"都管用。
七、MongoDB 迁移要不要做,先问三个问题
第一个问题,你只是嫌它老了,还是它真的不够用?换硬件、升版本、调分片,同引擎搬家就能解决。如果你的痛点是容量、成本、运维人力,搬家就够了。MongoDB 迁移里,换引擎的门槛比搬家高一个量级,别为了换而换。
第二个问题,你的应用有没有跨库拼装的活?文档和关系天天一起查,一个内核能省掉很多中间表。如果系统只有文档,没有关系数据,收益就没这么大。边界在这,不是所有场景都值得动。
第三个问题,你能不能拿出三周做验收?能,就按金仓那套迁移方法论走一遍。六个阶段一个别跳。不能,先把验收条款写进合同附件,再谈工期。
八、MongoDB 迁移,这五条最容易漏
- 迁移窗口只算搬数据,没算索引重建。一百多条索引重建,耗时不低于搬数据的一半,排计划时单独列。
- 验收只跑功能用例,不比对执行计划。功能对、结果对,不代表还走索引。抽核心语句把计划拉出来对形状。
- 驱动上来就用最新版。KES 对齐 4.4/5.0 协议规范,客户端用 3.x/4.x 更稳。
- 装完图省事,认证方式留在 trust。装扩展时设 trust 没问题,生产要改回 md5 或 scram-sha-256。
- 最后一条我自己踩过:连接串只改了地址,没改读偏好。原库靠读偏好分流,这行配置迁过来还留着。所有读请求压到一台机器,白天一到就顶。我盯 CPU 曲线看了两小时,才想起看连接串。
写在最后
那家教育平台的库,我上个月又看了一眼。并发涨了不少,那几个接口还是稳的。他们后来把验收清单做成了模板。这件事对我的提醒是,迁移的胜负不在搬,在验。
回头看我这一路踩的坑,我记住的是几件具体的事。KES 的 MongoDB 支持沿着存储引擎做,协议解析和落盘在一条链上。协议级兼容让原来的驱动直连,应用侧几乎不用改代码。一个内核装下了关系、文档、时序、向量、GIS 和文本。落到我手上,是这五条:
- 金仓协议级兼容:MongoDB 驱动直连 KES,27017 端口应答,换地址就能跑。
- 解析做在引擎内:内置 MongoDB-parser,BSON 直接落到存储引擎。
- 多模一体化:文档和关系共用一个事务引擎,跨模型能一条语句查。
- 工具链成套:KDMS 评估、KDTS 迁移、Kingbase FlySync 追增量,全量加增量加双重校验有现成路径。
- 集中分布一体:从小系统到需要分片的规模,不用换一套东西重学。
最硬的一条证据是茂名石化。20 亿行历史数据,应用零代码修改,5 分钟切换。可用性 99.999%,不是 PPT 上的数字。石化领域第一个在关键业务系统上换掉 MongoDB 的案例。落的就是这套能力。
如果你的 MongoDB 迁移还在立项,先做一件事。把"验收"写进方案,而不是写进总结。数据搬完只是第一格血条,剩下的在第六周。清单先写,工期后谈,这个顺序别反。
你们做 MongoDB 迁移的时候,验收项写了几条?有没有碰到"数据全对、接口却变慢"的情况?评论区聊聊,我帮你看看清单里漏了哪一项。我那份验收清单已经放在上面,缺的你补。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋

- 点赞
- 收藏
- 关注作者
评论(0)