时序|分位数摘要可以预先算好再合并了,ES 9.3 的 tdigest 字段类型
T-Digest 是一种估算分位数的数据结构。以前它只活在聚合的内部计算里,9.3 把它变成了可以存进索引的字段类型。这带来的变化是:分位数摘要可以预先算好、存起来、之后再合并。
说明
实测环境:本地起的 Elasticsearch 9.4.2 单节点实例(官方 tar 包直接跑,堆内存 512MB,安全与机器学习关闭),curl 连本地 9200 端口。本文「实测」小节的命令和输出都出自这个实例。
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.3.0.yml、AbstractPercentilesAggregationBuilder.java、MapperFeatures.java),文中引用的原文均来自这些文件。示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
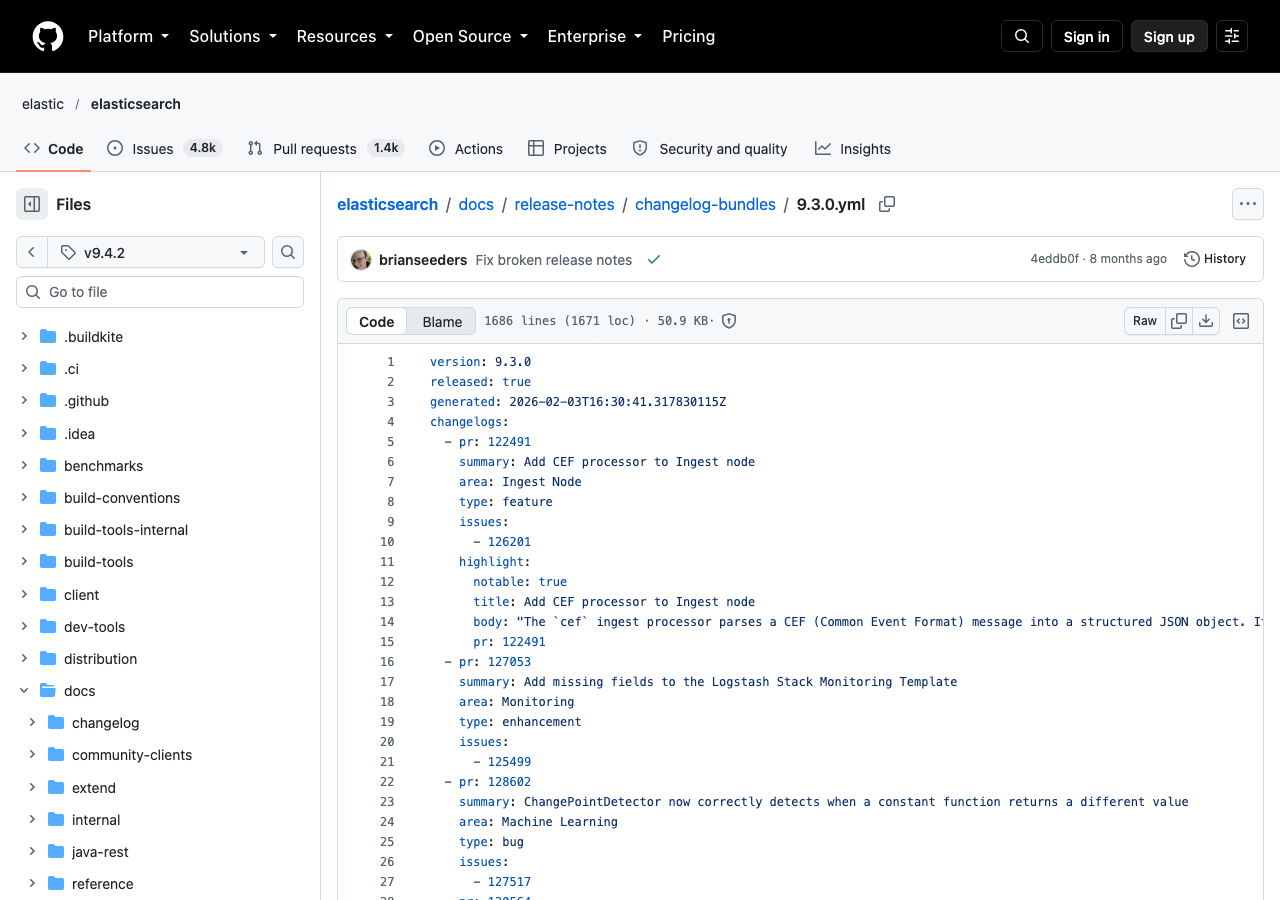
图 1:官方文件 9.3.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.3.0.yml
官方条目
9.3 的 changelog 标为 enhancement(9.3.0.yml 第 1454–1457 行 @ v9.4.2),area: Mapping:
Add a dedicated field type for T-Digests
只有一行 summary。下面的内容来自源码和相关文档。
图 2:官方文件 AbstractPercentilesAggregationBuilder.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 AbstractPercentilesAggregationBuilder.java
先说分位数和为什么难算
分位数(percentile)就是"百分之多少的数据低于这个值"。常见的 P95、P99 延迟就是这么来的。
算分位数需要全量排序——把所有值排一遍,取第 95% 位置的它。数据量小时没问题,但监控场景动辄百万、千万个数据点。
全量排序的代价:
- 内存要放得下所有值;
- 时间随数据量增长。
所以实际系统都用估算算法——用很少的内存换一个"够准"的结果。
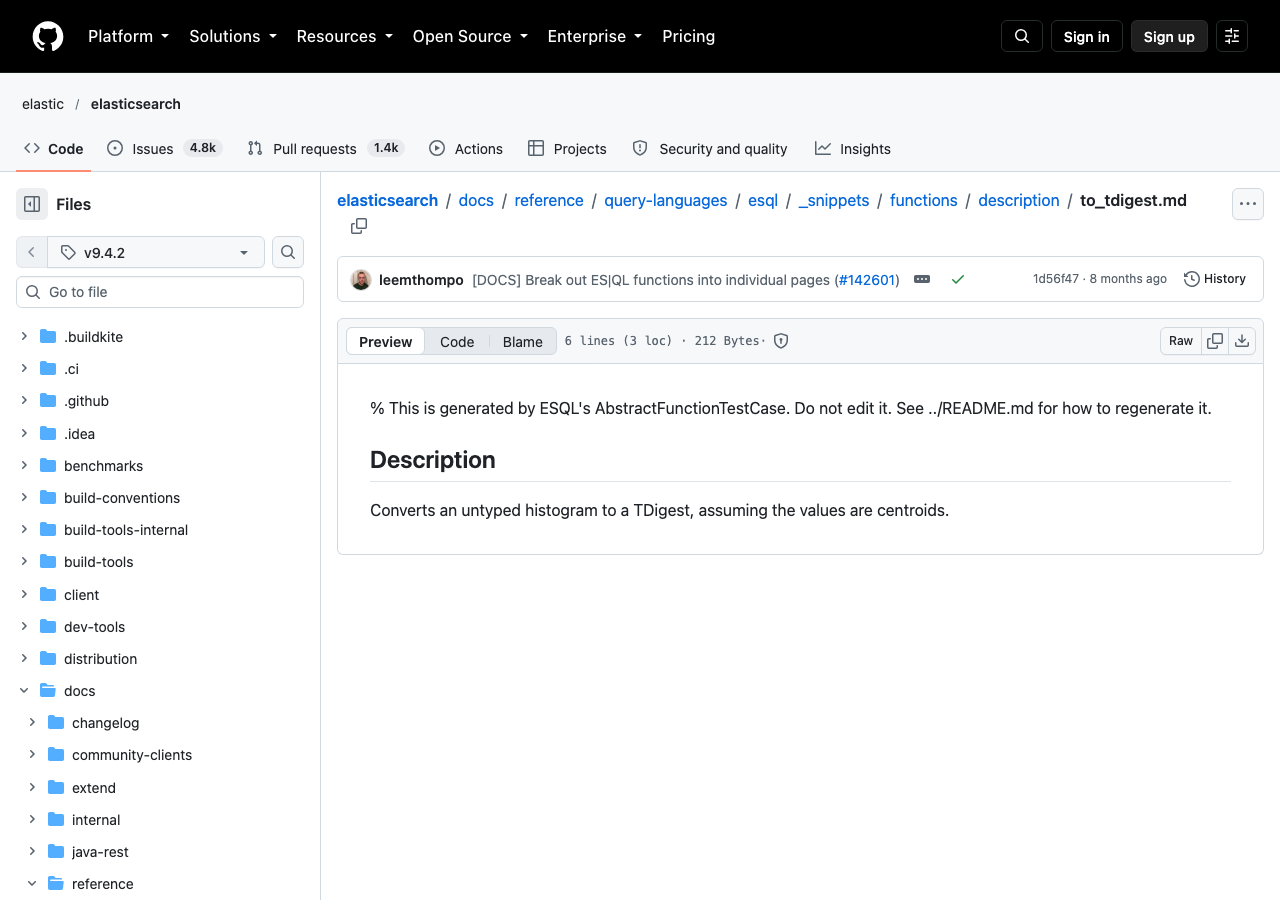
图 3:官方文件 to_tdigest.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 to_tdigest.md
T-Digest 是什么
T-Digest 就是这样一种估算结构。它的思路可以粗略理解为:
把数据聚成一堆"簇"(centroid),每个簇记录"大约有多少个点、中心在哪"。 分位数从这些簇里插值算出来。
关键性质:
- 占用固定且小——不随数据量线性增长;
- 误差可控,且在两端(P99、P1)比中间更准——这正好是监控最关心的区域;
- 可以合并——两个 T-Digest 能合成一个。
第三条是本篇的重点:我的判断是"能合并"这一条最关键——它意味着可以分头算再汇总,这是选它而不是存原始数据的理由。
(说明:以上是 T-Digest 的通用原理描述,未引用具体论文,细节以算法原始资料为准。)
以前的用法
在 9.3 之前,T-Digest 出现在聚合内部:
percentiles聚合有个method参数;- 其中
TDIGEST是一个可选实现(源码里能看到PercentilesMethod.TDIGEST,AbstractPercentilesAggregationBuilder.java 第 105–106 行 @ v9.4.2)。
也就是说:T-Digest 是算分位数时的一种算法选择,是聚合过程的一部分,不是你能存下来的东西。
这带来一个限制:每次查询都要拿原始数据重新算一遍。
9.3 之后变成字段类型
源码里能看到这个类型被注册为节点特性(MapperFeatures.java 第 78 行,源码 @ v9.4.2):
static final NodeFeature TDIGEST_TYPE = new NodeFeature("mapper.tdigest_type");
有了字段类型,就可以:把 T-Digest 作为一个值存进文档。
这带来了什么? 核心是预聚合:
- 上游按时间窗口(比如每分钟)算好一个 T-Digest;
- 作为一个字段存进索引;
- 查询时合并这些 T-Digest,直接得到任意时间范围的 P95、P99。
对比以前:以前要保留原始数据,每次查询扫全量重算。现在只存摘要,查询时合并摘要。
ES|QL 里怎么产生它
有个 TO_TDIGEST 函数。官方描述(to_tdigest.md @ v9.4.2):
Converts an untyped histogram to a TDigest, assuming the values are centroids.
把一个未定类型的直方图转成 TDigest,假定其中的值是质心(centroid)。
“假定值是质心"这个说法要看清楚——它说明这个函数是把一个已经是质心形式的结构转成 TDigest 类型,不是"对一堆原始值求 T-Digest”。
(说明:"未定类型的直方图"具体指什么输入,未查证。从措辞看应该是 histogram 类字段,但确切类型不确定。)
如果需求是"对原始数值算 T-Digest",那这个函数可能不是入口——这一点未确认,需要的话请查你版本的函数文档。
能合并才是关键
前面说 T-Digest 可以合并,这里说它为什么重要。
分位数有个讨厌的性质:不能直接从子集的 P95 算出全集的 P95。
举例:两个分钟,第一分钟 P95 是 100ms,第二分钟 P95 是 200ms。这两分钟的整体 P95 不是 150ms——它取决于两分钟各自的数据分布。
这是分位数聚合不能简单"预聚合"的原因,也是它和其它指标(count、sum、avg)的根本区别:
| 指标 | 能从子集算出全集吗 |
|---|---|
| count | 能(相加) |
| sum | 能(相加) |
| avg | 能(sum/count) |
| P95 | 不能 |
而 T-Digest 解决了这个问题:它保留了足够的分布信息,合并之后能算出合并集的分位数。
所以"存 T-Digest"和"存 P95"是完全不同的两件事——前者保留了合并能力,后者已经丢了信息。
这是本篇最该讲清的一点:这个字段类型存的是"可再计算的摘要",不是"已经算好的数"。
和 aggregate_metric_double 的对比
讲聚合度量那篇里写过 aggregate_metric_double——它把 min/max/sum/value_count 打包成一个字段存。两者都是"预聚合存储",但能表达的东西不一样:
aggregate_metric_double |
tdigest |
|
|---|---|---|
| 存的是 | 几个标量(min/max/sum/count) | 一个分布摘要 |
| 能算出的 | 这些标量、以及由它们推导的量 | 任意分位数 |
| 时间范围合并 | 标量可相加 | 摘要可合并 |
| 能否还原单条 | 不能 | 不能 |
关键区别在第二行:aggregate_metric_double 存的几个标量算不出 P95——因为它没有保留分布形状。而 tdigest 专为这个设计。
反过来,tdigest 也算不出精确的总和或最小值(它是估算结构,且存的是分布不是极值)。
所以两者是互补的,不是替代。 如果指标看板同时要"总和"和"P99",可能需要两类字段都配——或者保留原始数据。
判断:选哪个取决于你要回答什么问题:
- “这段时间总共多少次” → 计数类,标量够;
- “这段时间的 P99 是多少” → 必须保留分布信息,标量不够,
tdigest或原始数据二选一。
什么场景需要它
判断主要是监控/指标类场景:
- 上游按小窗口采集(每分钟、每 5 分钟);
- 需要查询任意时间范围的延迟分布;
- 原始数据量大,不能长期保留。
典型例子:APM 的延迟分布、接口响应时间、请求大小分布。
不适合的场景:
- 数据量小,直接算就行(不需要摘要);
- 只需要固定几个分位数且范围固定(那直接存数更省);
- 需要精确值而非估算(T-Digest 是估算)。
这条改动怎么看
这条改动属于能力补齐:把一个此前只能内部使用的数据结构,开放成可存储的类型。
它的价值不在"又多了个字段类型",而在于让一种数据组织方式变得可行:
- 以前:存原始数据 → 查询时算;
- 现在:存摘要 → 查询时合并。
后者的存储成本可能低一个数量级(摘要比原始数据小得多),查询也更快。代价是精度变成估算、且原始值找不回来了。
所以这个交换是否划算,取决于场景能不能接受"只有分布、没有原始值"。监控类场景通常能接受;需要逐条排查的场景不能。
一个要提醒的点
存了摘要就等于丢了原始数据。
这是预聚合类方案的通用权衡,但值得明确说出来:一旦你把每分钟的数据压成一个 T-Digest 存起来,那一分钟里具体每个请求是多少毫秒,就再也查不到了。
建议:
- 如果保留原始数据成本可接受,两者都存(原始数据短期保留,摘要长期保留)——这是最常见的监控数据分层策略;
- 如果成本紧张,至少确认你真的不需要原始值再压缩。
判断依据:你会不会需要下钻到单条记录? 需要 → 别只存摘要。
和别的新字段类型放一起看
9.x 加了几个字段类型,前面写过相关的:
| 类型 | 用途 |
|---|---|
dense_vector 相关 |
向量检索 |
semantic_text |
语义检索(内置向量化) |
本篇的 tdigest |
存分位数摘要 |
共同点:都是为某类计算专门设计存储格式,而不是通用容器。
这个方向是对的:专用类型能用更少的空间、更适配的结构来表达特定数据,比用通用结构硬套划算。aggregate_metric_double(前面写过那篇)也是同一思路——把 sum/min/max 等预聚合值打包存。
所以 tdigest 可以看作是这条思路的延伸:从"预聚合的标量"延伸到"预聚合的分布"。
在 9.4.2 上跑一遍
建一个 tdigest 字段,然后对它做一次普通的 percentiles 聚合:
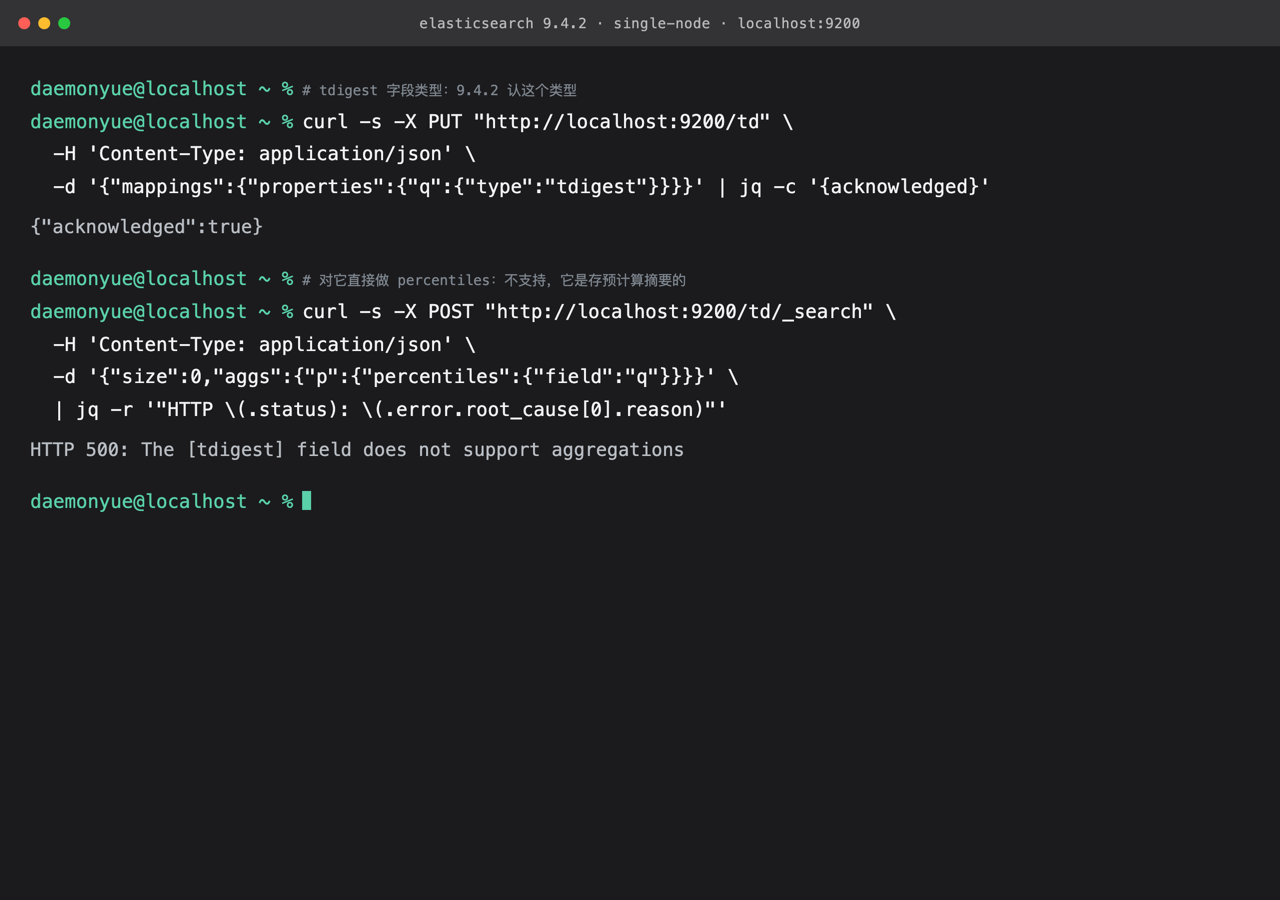
图 4:本地 9.4.2 单节点实例上的实测输出。上:建索引;下:直接聚合
curl -s -X PUT "" \
  -H 'Content-Type: application/json' \
  -d '{"mappings":{"properties":{"q":{"type":"tdigest"}}}}' | jq -c '{acknowledged}'

curl -s -X POST "" \
  -H 'Content-Type: application/json' \
  -d '{"size":0,"aggs":{"p":{"percentiles":{"field":"q"}}}}' \
  | jq -r '"HTTP \(.status): \(.error.root_cause[0].reason)"'
索引建起来了;聚合返回 HTTP 500: The [tdigest] field does not support aggregations。
这个组合看起来矛盾,其实正好说明它的定位:存的是算好的摘要,不是原始值。原始值根本不在索引里,所以"对原始值求分位数"这件事做不了——能做的是把多路摘要合并起来。这也解释了为什么报 500 而不是 400:它是执行阶段发现字段类型不支持,不是参数校验失败。
结论是:用之前先想清楚数据的来源。如果分位数是在别处(比如流处理任务里)算好、只需要合并的,tdigest 字段类型合适;如果指望索引自己从原始值算,那还是用普通数值字段加 percentiles 聚合。
写在最后
一个专用字段类型:把 T-Digest 存进索引。
一,T-Digest 是估算分位数的紧凑结构,特点是占用小、两端更准、可以合并。
二,9.3 起它能作为字段类型存储,于是可以从"查询时算"变成"存摘要、查询时合并"。我的建议是:要跨多个索引算分位数时才值得用它,单个索引的普通聚合不用换。
三,能合并是它相对"直接存 P95"的核心优势——分位数不能从子集的分位数推出,但能从子集的 T-Digest 推出。
四,存摘要等于丢原始数据,用之前确认你不需要下钻。
另外诚实标注三处:T-Digest 的算法细节是通用原理描述,未引论文;TO_TDIGEST 的输入类型未查证,且它看来是"转换质心"而非"从原始值计算";这个字段类型的完整使用方式(mapping 写法、支持的聚合)未逐个确认。
参考
- changelog 9.3.0:Add a dedicated field type for T-Digests(第 1454–1457 行)@ v9.4.2
MapperFeatures.java:类型注册mapper.tdigest_type(第 78 行)@ v9.4.2AbstractPercentilesAggregationBuilder.java:T-Digest 作为聚合方法之一(第 105–106 行)@ v9.4.2to_tdigest.md:ES|QL 转换函数描述 @ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。图 4 实测:mapping 可建,但对它直接做percentiles会报does not support aggregations(500)。T-Digest 的算法细节为通用原理描述,未引用原始论文;TO_TDIGEST的输入类型未查证,且其描述显示为"转换质心"而非"从原始值计算",是否可用于对原始数值求摘要未确认;该字段类型的完整使用方式未逐个确认。

- 点赞
- 收藏
- 关注作者
评论(0)