从一张原图到三档产物华为云OBS + FunctionGraph 构建无服务器图片处理流水线

一、先定方案:三条路,各自的代价
把图片处理放在哪里,本质是在「运维成本、格式自由度、冷启动延迟」三者之间做取舍。先把三条常见路线摆在同一张表上,后面所有设计都是这张表推导出来的结果。
表 1 三条图片处理路线的取舍
|
维度 |
自建 ECS + 图片服务 |
OBS 原生图片处理 |
OBS + FunctionGraph(本文) |
|
运维负担 |
需要进程守护、机器扩容、依赖打补丁 |
零运维 |
零运维,只维护函数代码 |
|
格式与算法自由度 |
完全自由(ImageMagick / libvips 全量) |
受限,以缩放、裁剪、水印、格式转换为限 |
完全自由(Pillow / OpenCV 均可) |
|
延迟特征 |
常驻进程,首字节最快 |
边缘处理,通常毫秒级 |
热启动 2~3 s,冷启动额外 2~6 s |
|
计费方式 |
包年包月或按小时 |
按处理次数与流量 |
按调用次数 + 执行时长(GB·秒) |
|
适合场景 |
超高并发、强定制、已有机器 |
只做尺寸变换的标准场景 |
规则常变、流量波峰明显、要写业务逻辑 |
选第三条的理由很直接:需求里包含「按 EXIF 方向纠正」「WebP 与 JPEG 双格式」「体积超过阈值时二次压缩」这类会持续变化的规则,OBS 原生能力覆盖不到;而流量曲线是白天高、凌晨接近零,常驻机器有大量空转。函数计算按调用计费,规则改动只涉及一次代码发布。
二、总体架构
整条流水线只有两个存储桶、一个函数、一个触发器,数据流是单向的。先把图看明白,后面每一步都能在图上找到位置。
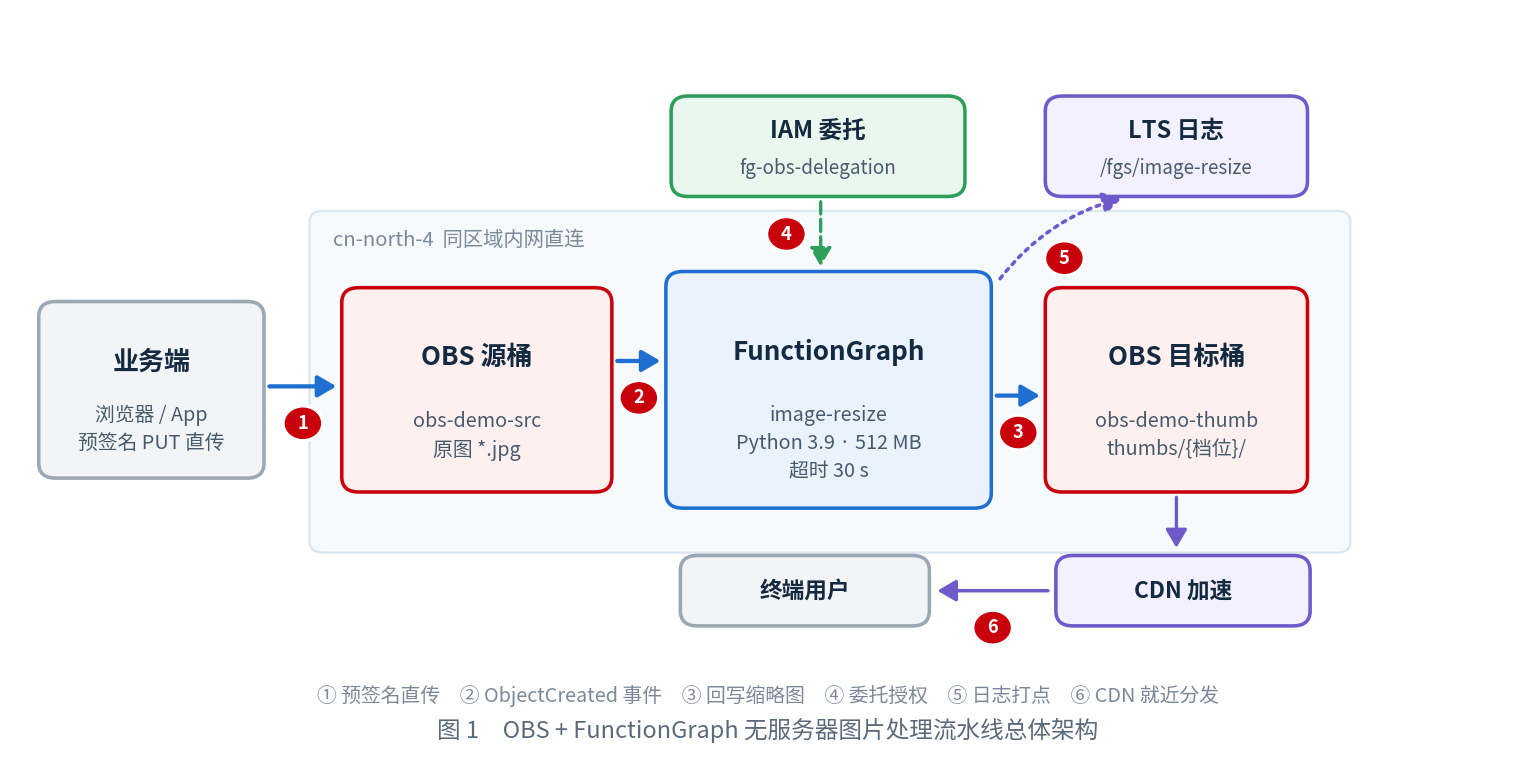
图中编号与第三章之后的步骤一一对应:① 预签名直传 ② 事件通知 ③ 回写产物 ④ 委托授权 ⑤ 日志 ⑥ CDN 分发。
四条设计原则决定了这张图的样子:
▪ 源桶与目标桶分开。若函数把产物写回同一个桶,新对象又会触发一次事件,形成自激循环。物理隔离比在代码里判断前缀更可靠。
▪ 触发器只监听源桶的 ObjectCreated,事件通道异步投递,上传方拿到 200 OK 与函数执行完成解耦。
▪ 函数用 IAM 委托换取临时密钥,代码里始终保持零长期密钥。
▪ 产物 key 保持与原图相同的相对路径结构,前端只要替换前缀就能拼出地址。
三、准备:桶、目录、权限
3.1 两个桶与目录约定
表 2 存储桶规划
|
桶名 |
用途 |
区域 |
访问策略 |
生命周期 |
|
obs-demo-src |
存放原图,只写不读 |
cn-north-4 |
私有 |
90 天后转低频 |
|
obs-demo-thumb |
存放三档产物,供 CDN 回源 |
cn-north-4 |
私有 + CDN 回源授权 |
永久 |
两个桶必须同区域。函数与桶跨区域时,GetObject 走公网,单次读取 4 MB 的耗时从 30 ms 量级涨到 200 ms 以上,还会产生公网流出流量费。
产物目录统一为 thumbs/{档位}/{文件名},例如原图 photos/2026/11/a.jpg 对应产物 thumbs/medium/a.jpg。去掉日期层级是有意为之:CDN 的缓存键越短越稳定,缩略图本体直接平铺,按日期归档的收益为零。
3.2 委托与最小权限
在 IAM 控制台创建委托 fg-obs-delegation,委托对象选「云服务 → 函数工作流 FunctionGraph」,授予自定义策略 obs-image-rw,只包含下面四条 action:
{
"Version": "1.1",
"Statement": [
{ "Effect": "Allow",
"Action": ["obs:object:GetObject", "obs:object:PutObject",
"obs:object:GetObjectVersion"],
"Resource": ["obs:*:*:object:obs-demo-src/*",
"obs:*:*:object:obs-demo-thumb/*"] },
{ "Effect": "Allow",
"Action": ["obs:bucket:ListBucket"],
"Resource": ["obs:*:*:bucket:obs-demo-src"] }
]
}
策略里刻意剔除 obs:bucket:DeleteBucket、obs:object:DeleteObject 这类动作。函数只需要读源桶、写目标桶,多出来的权限在出事故时会放大损失,例如一次误触发把整个前缀清空。
3.3 依赖包:Pillow 与 OBS SDK 的坑点
FunctionGraph 的 Python 3.9 运行时自带标准库与少量常用库,图片处理库与 OBS SDK 都需要随代码打包。打包的核心要求只有一条:wheel 的平台标签要与运行时一致。
▪ Pillow 选 cp39-cp39-manylinux_2_28_x86_64(或 manylinux2014 版本),体积约 4 MB。
▪ esdk-obs-python 是纯 Python 包,直接 pip download 即可取到 whl。
▪ 在本地建空目录,执行 pip download -d . -r requirements.txt --platform manylinux2014_x86_64 --python-version 39 --only-binary=:all:,再把 whl 解压进代码根目录。
很多「cannot import name _imaging」的报错都来自同一原因:在 macOS 或 ARM 机器上用 pip 直接下载,拿回的是本地平台的二进制。打包时显式指定 platform 参数,这个问题从源头消失。
# 目录结构(压缩成 zip 上传)
image-resize/
├── index.py # 入口文件,函数入口为 index.handler
├── requirements.txt
└── lib/python3.9/site-packages/
├── PIL/ # Pillow
└── obs/ # OBS SDK
四、函数实现:从事件到三档产物
函数按「解析事件 → 读原图 → 纠正方向 → 逐档生成 → 幂等写回 → 汇总日志」六段式组织。下面这份代码约 90 行,是可直接运行的完整版本,注释标注了每一段对应的设计意图。
# -*- coding: utf-8 -*-
import io, os, time, urllib.parse, logging
from obs import ObsClient
from PIL import Image, ImageOps
logger = logging.getLogger()
logger.setLevel(logging.INFO)
OBS_SERVER = os.environ.get("OBS_SERVER", "https://obs.cn-north-4.myhuaweicloud.com")
DST_BUCKET = os.environ.get("DST_BUCKET", "obs-demo-thumb")
SRC_PREFIX = os.environ.get("SRC_PREFIX", "photos/")
MAX_SIDE = int(os.environ.get("MAX_SIDE", 6000))
# 档位: (目录名, 长边像素, 输出格式, 质量)
TIERS = [
("thumb", 320, "JPEG", 82),
("medium", 1024, "JPEG", 85),
("webp", 1280, "WEBP", 78),
]
def _client(context):
"""用函数委托换取临时密钥,全程零长期 AK/SK。"""
return ObsClient(
access_key_id=context.getAccessKey(),
secret_access_key=context.getSecretKey(),
server=OBS_SERVER,
security_token=context.getSecurityToken(),
connection_timeout=8,
max_retry_count=2,
)
def _records(event):
"""事件里可能出现多条 Record,逐条处理即天然支持批量上传。"""
for r in event.get("Records", []):
s3 = r.get("s3", {})
bucket = s3.get("bucket", {}).get("name")
key = urllib.parse.unquote_plus(s3.get("object", {}).get("key", ""))
if bucket and key:
yield bucket, key
def _resize(im, side):
w, h = im.size
if max(w, h) <= side:
return im.copy()
if w >= h:
return im.resize((side, round(h * side / w)), Image.LANCZOS)
return im.resize((round(w * side / h), side), Image.LANCZOS)
def _encode(im, fmt, quality):
buf = io.BytesIO()
if fmt == "WEBP":
im.save(buf, "WEBP", quality=quality, method=5)
else:
im.save(buf, "JPEG", quality=quality, optimize=True, progressive=True)
buf.seek(0)
return buf
def handler(event, context):
t0 = time.time()
client = _client(context)
done, skip, failed = 0, 0, []
for src_bucket, src_key in _records(event):
# 防御:产物前缀与目标桶一律跳过,避免自激循环
if src_bucket == DST_BUCKET or src_key.startswith("thumbs/"):
logger.info("skip key=%s/%s", src_bucket, src_key)
continue
try:
resp = client.getObject(src_bucket, src_key, loadStreamInMemory=True)
if resp.status >= 300:
raise RuntimeError("get %s/%s status=%s"
% (src_bucket, src_key, resp.status))
raw = resp.body.buffer
with Image.open(io.BytesIO(raw)) as im:
if max(im.size) > MAX_SIDE:
logger.warning("oversize key=%s size=%s", src_key, im.size)
im.thumbnail((MAX_SIDE, MAX_SIDE), Image.LANCZOS)
im = ImageOps.exif_transpose(im) # 手机竖拍方向纠正
im = im.convert("RGB") if im.mode in ("P", "CMYK", "L") else im
stem = src_key.rsplit("/", 1)[-1].rsplit(".", 1)[0]
for tier, side, fmt, q in TIERS:
ext = "webp" if fmt == "WEBP" else "jpg"
dst_key = "thumbs/%s/%s.%s" % (tier, stem, ext)
# 幂等:事件至少一次投递,先探针再写入
if client.headObject(DST_BUCKET, dst_key).status == 200:
skip += 1
continue
buf = _encode(_resize(im, side), fmt, q)
ctype = "image/webp" if fmt == "WEBP" else "image/jpeg"
r = client.putObject(
DST_BUCKET, dst_key, buf,
headers={"Content-Type": ctype,
"Cache-Control": "public, max-age=2592000"})
if r.status >= 300:
raise RuntimeError("put %s status=%s" % (dst_key, r.status))
logger.info("tier=%s key=%s bytes=%d",
tier, dst_key, buf.getbuffer().nbytes)
done += 1
except Exception:
logger.exception("failed key=%s/%s", src_bucket, src_key)
failed.append(src_key)
cost = int((time.time() - t0) * 1000)
logger.info("summary done=%d skip=%d failed=%d cost=%dms",
done, skip, len(failed), cost)
if failed:
# 抛出异常交给触发器重试,单条失败不影响其它记录
raise RuntimeError("partial failure: %s" % ",".join(failed))
return {"done": done, "skip": skip, "cost_ms": cost}
4.1 事件结构:先看清字段再写解析
OBS 触发器投递给函数的事件体是一个 JSON 对象,最常用的三个字段是 s3.bucket.name、s3.object.key 与 eventName。key 在传输过程里做过 URL 编码,包含中文、空格或加号的对象名必须过一次 unquote_plus,否则 GetObject 会拿到一个带 % 的假路径,直接返回 404。
{
"Records": [{
"eventName": "ObjectCreated:Put",
"eventTime": "2026-11-14T02:11:07.412Z",
"s3": {
"bucket": { "name": "obs-demo-src", "arn": "arn:aws:s3:::obs-demo-src" },
"object": { "key": "photos/2026/11/%E5%B1%B1%E8%84%8A.jpg",
"size": 5032184, "eTag": "9c1f...", "sequencer": "0000..." }
}
}]
}
4.2 幂等:把重复投递当成常态
事件通道是「至少一次」语义,同一次上传在网络抖动时可能出现两条 Record;前端重传同一个文件名同样会触发第二条。所以在写每个档位之前先做一次 headObject 探测:对象已存在就计入 skip,跳过重复编码。这一步的成本是一次 HEAD 请求(约 1 ms),换来的是整个流水线的可重入性。
4.3 方向纠正与缩放策略
手机直出照片在 EXIF 里记录方向标记,像素本身往往是横躺的。直接按像素缩放,竖拍的人像会变成侧躺。ImageOps.exif_transpose 会读取 Orientation 标签并做物理旋转,这一步必须在缩放之前执行。
缩放用长边约束而不是固定宽高:竖图与横图在产品里共用同一套 CSS 容器,按长边等比缩放可以让两种方向占据相同的视觉面积,前端也不需要再用 object-fit 二次裁切。
4.4 三档参数的来历
表 3 三档产物参数
|
档位 |
长边像素 |
格式 |
质量 |
典型体积 |
使用位置 |
|
thumb |
320 |
JPEG |
82 |
20~35 KB |
列表页、消息卡片 |
|
medium |
1024 |
JPEG |
85 |
150~260 KB |
详情页首屏、分享图 |
|
webp |
1280 |
WebP |
78 |
80~130 KB |
现代浏览器主图 |
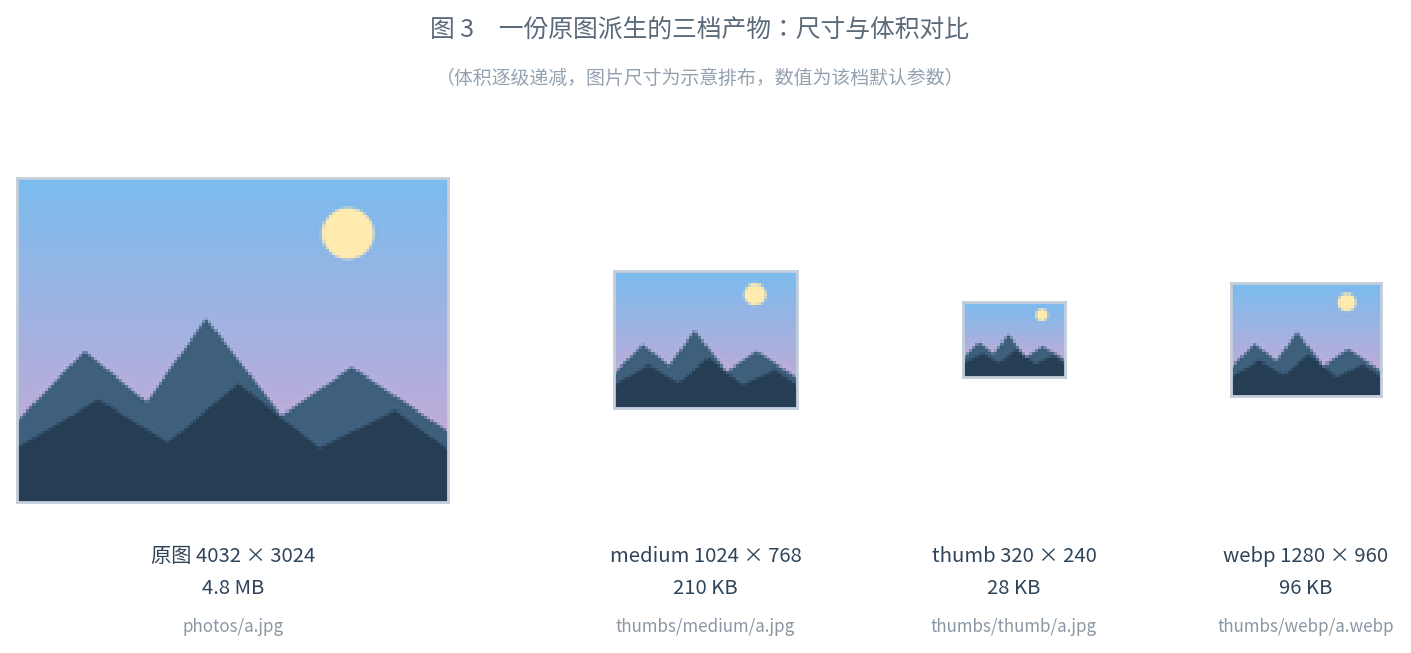
质量参数用 82 / 85 / 78 而非统一 90,是压缩比与观感的折中:JPEG 在 85 附近进入平台区,再往上加 5 个点体积涨四成,肉眼对比几乎看不出差别;WebP 的 78 已经相当于 JPEG 的 88 左右。
五、触发器配置:让事件精准落到函数上
在函数详情页添加「OBS 触发器」,四个参数决定它是否按预期工作:
表 4 OBS 触发器参数
|
参数 |
取值 |
说明 |
|
事件源 |
OBS |
选择与函数同区域的源桶 |
|
事件类型 |
ObjectCreated:Put / Post / Copy |
上传、表单上传、复制三类创建动作都覆盖;删改事件在这里无意义 |
|
前缀(可选) |
photos/ |
只处理原图目录,日志与临时文件天然隔离 |
|
后缀(可选) |
jpg / jpeg / png / heic |
按扩展名过滤,减少无效调用 |
|
重试策略 |
开启,最多 3 次 |
函数抛异常的记录进入重试队列,间隔指数退避 |
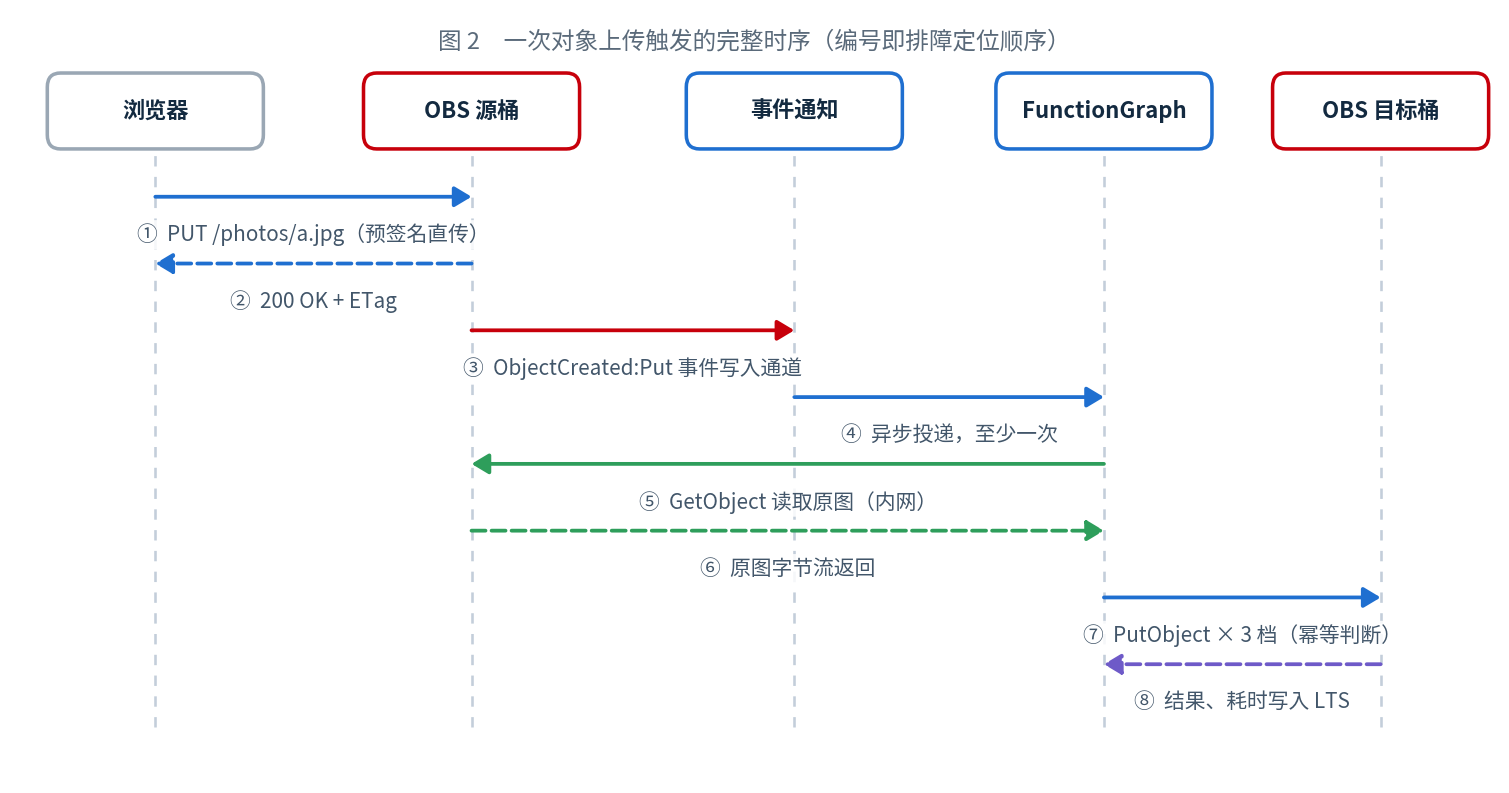
时序图里第 ④ 步是排障时最容易误判的一环:事件投递与函数执行发生在两个独立系统,上传返回 200 OK 只代表对象已落盘,函数是否完成要看 LTS 日志或函数监控面板。
5.1 前缀过滤与自激循环
前缀写成 photos/ 有两个好处:日志、失败备份等目录放在桶根下时,它们触发的事件被自然挡在触发器之外;排查时也能一眼看出哪些对象属于「原图集」。
有人图省事把产物写回同一个桶,靠代码判断 key 是否以 thumbs/ 开头来防循环。这层防御在代码里保留(本文实现里就有),但物理上分桶才是根本解法——一次规则调整、一次前缀改错,都可能让循环重新出现,而分桶让这种可能彻底消失。
# 代码里的双保险:桶名与前缀同时判断
if src_bucket == DST_BUCKET or src_key.startswith("thumbs/"):
logger.info("skip key=%s/%s", src_bucket, src_key)
continue
六、验证:三步确认链路真的通了
部署完成后按顺序验证,任何一步失败都能定位到具体环节,比在日志里翻找高效得多。
6.1 上传一张带方向信息的照片
从手机相册取一张竖拍照片,控制台上传到 photos/ 目录。上传完成后立刻打开目标桶的 thumbs/,三档对象应当在 1~3 秒内出现。目标桶为空说明事件链路停在 ③ 之前:先查触发器是否启用,再查桶名与区域是否与函数一致。
6.2 读日志确认三档都写过
在函数详情页的「监控 → 日志」里筛选 summary 关键字,正常记录长这样:
2026-11-14 02:11:09 INFO tier=thumb key=thumbs/thumb/山脊.jpg bytes=27418
2026-11-14 02:11:10 INFO tier=medium key=thumbs/medium/山脊.jpg bytes=214876
2026-11-14 02:11:11 INFO tier=webp key=thumbs/webp/山脊.webp bytes=102311
2026-11-14 02:11:11 INFO summary done=3 skip=0 failed=0 cost=2417ms
6.3 重复上传同一对象,验证幂等
把同一个文件再传一次。第二次的日志应当是 done=0 skip=3 failed=0,目标桶里对象的 LastModified 保持原值。这一步用来确认:即便投递重复,幂等判断也把重复编码与覆盖挡在了门外。
6.4 抽查方向与配色
做一张原图与产物的并排对比图,重点看三处:竖图方向是否正确、红色区块是否偏色(CMYK 与 sRGB 转换的常见偏差)、深色区域是否有明显的块状噪点(质量参数偏低的典型表现)。这三处过关,绝大多数场景就够用了。
七、性能与成本:把函数规格算清楚
函数的内存档位直接决定 CPU 份额与单价。同一个函数在多种内存规格下处理同一张 4032×3024 的 JPEG,耗时差异相当明显:
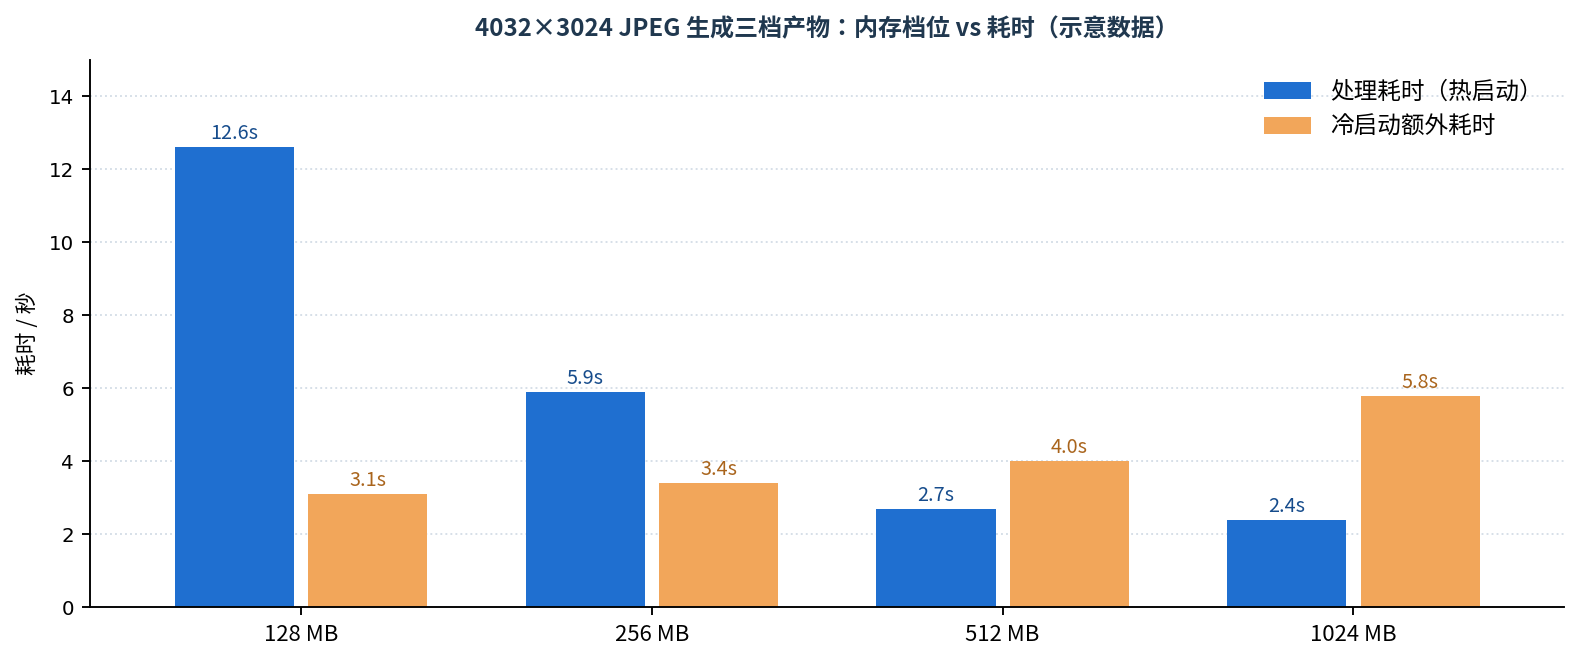
表 5 内存档位选择
|
内存 |
单次处理耗时 |
冷启动 |
结论 |
|
128 MB |
12.6 s |
3.1 s |
Pillow 解码大图时内存吃紧,耗时随图片增大迅速恶化 |
|
256 MB |
5.9 s |
3.4 s |
可用,但批量上传时容易触及 30 s 超时上限 |
|
512 MB |
2.7 s |
4.0 s |
推荐档位,3 档产物稳定在 3 s 内完成 |
|
1024 MB |
2.4 s |
5.8 s |
耗时提升有限,冷启动代价反而更高,适合超大图场景 |
512 MB 是这条流水线的甜点:处理耗时压到 3 秒内,冷启动成本可控,单价与 256 MB 的差距被执行时长缩短抵消掉大半。把超时时间设为 30 秒,留出 10 倍余量应对突发的大文件,同时避免异常情况下长时间占用配额。
7.1 成本量级估算
表 6 成本构成(单价以官网价格计算器为准)
|
计费项 |
口径 |
10 万张/月估算 |
|
函数调用 |
按请求次数计费 |
10 万次 × 单价,量级在几元 |
|
函数执行 |
按 GB·秒计费(内存 × 时长) |
0.5 GB × 3 s × 10 万次 = 15 万 GB·秒 |
|
OBS 存储 |
标准存储按 GB·月 |
原图 40 GB + 产物 25 GB ≈ 65 GB |
|
OBS 请求 |
PUT / HEAD / GET 分别计价 |
推理:40 万次写 + 30 万次 HEAD |
|
CDN 流量 |
按流出流量计费 |
取决于命中率,命中 90% 时回源量仅为十分之一 |
横向对比常驻方案:一台 2 核 4 GB 的云服务器月费通常在百元量级,而函数侧在 10 万张/月的量级上多数情况低于这个数;真正的分水岭是流量曲线的形状——波峰越尖、夜间越空,函数方案越划算。
7.2 三个降本动作
▪ 产物加 Cache-Control: public, max-age=2592000。CDN 命中率上去后,回源请求与流出流量同步下降。
▪ 源桶配生命周期:90 天转低频存储,180 天转归档。原图只在重新生成产物时需要,冷数据放低频层是纯收益。
▪ HEIC 等特殊格式在上传端转换。函数运行时里解码 HEIC 需要额外依赖,把这一步挪到客户端能同时省下体积与耗时。
八、九个坑:现场记录与处理
以下九条按出现频率排序,每条给出「现象 → 根因 → 处理」,可以当作上线前的自查清单。
坑 1 key 带 %E5%B1%B1,GetObject 报 404
现象:日志里 key 是 URL 编码串,目标桶空空。根因:事件体里的 object.key 经过编码,中文、空格、加号都会变形。处理:解析时统一 urllib.parse.unquote_plus,并在日志里同时打印原始 key 与解码后 key,排查时一眼分明。
坑 2 产物写回同桶,函数被反复触发
现象:函数调用量在几分钟内暴涨,账单异常。根因:写入动作本身产生 ObjectCreated 事件,再次触发函数,每轮再写一次,形成指数增长。处理:产物桶单独创建;代码里同时判断桶名与 thumbs/ 前缀,两层拦截。
坑 3 冷启动把首屏拖到 6 秒
现象:每天第一批上传的产物延迟明显,之后恢复正常。根因:函数实例在空闲后回收,首次调用要拉代码包、初始化解释器与依赖。处理:把依赖精简到 Pillow + OBS SDK 两个包;对热点时段开启预留实例;前端在上传后先显示本地预览,产物就绪后再替换。
坑 4 cannot import name _imaging
现象:本地跑得好好的,部署后一调用就 ImportError。根因:wheel 平台标签与方法运行时不一致,例如在 ARM 机器或 macOS 上下载了本地二进制。处理:pip download 时显式指定 --platform 与 --python-version,上传前用 unzip -l 检查 PIL/.libs 下的 .so 是否为 x86_64。
坑 5 headObject 返回 404 被当成异常
现象:日志里全是 failed,却没有真实的写入失败。根因:对象不存在时 HEAD 返回 404,某些封装层会把它包装成异常。处理:判断 resp.status 而不是依赖 try/except;把 404 视为「对象尚不存在,可以写入」的正常分支。
坑 6 EXIF 方向标记丢失,人像侧躺
现象:手机竖拍照片的产物被旋转 90°。根因:缩放前没有处理 Orientation 标签,或者中途用 convert() 把 EXIF 丢掉了。处理:读取后立刻 exif_transpose,再转色彩模式;顺序颠倒会让旋转失效。
坑 7 超大图触发 DecompressionBombError
现象:个别专业相机照片一进函数就抛异常。根因:Pillow 对超过约 8900 万像素的图片默认抛保护性错误。处理:先判断尺寸,超过阈值就 thumbnail 到安全范围再处理;确有需求时显式调整 Image.MAX_IMAGE_PIXELS,同时把函数内存提到 1024 MB。
坑 8 CMYK 图输出后整体发灰
现象:印刷来源的图片产物偏暗偏灰。根因:CMYK 直接保存成 JPEG,色彩空间没有转换。处理:convert('RGB') 显式转 sRGB;观察红色区块与肤色区块是否还原,这两处对偏色最敏感。
坑 9 日志里塞了二进制,LTS 检索卡顿
现象:函数日志面板打开极慢,按关键字搜不到内容。根因:调试时把图片字节流或整个 event 打印出来。处理:只打印结构化短字段(key、档位、字节数、耗时),event 只在调试期打印前 300 字符。
九、按需扩展:往流水线里加能力
9.1 加水印
在 _resize 之后、_encode 之前插入一段绘制逻辑即可。文字水印建议用半透明白字 + 轻描边,位置固定但随图片宽度等比缩放,避免小图上水印占比过大:
from PIL import ImageDraw, ImageFont
def add_mark(im, text="@demo"):
im = im.convert("RGBA")
layer = Image.new("RGBA", im.size, (0, 0, 0, 0))
d = ImageDraw.Draw(layer)
size = max(14, im.size[0] // 40)
font = ImageFont.truetype("/opt/fonts/NotoSansCJK-Regular.ttc", size)
w, h = d.textbbox((0, 0), text, font=font)[2:]
x, y = im.size[0] - w - size, im.size[1] - h - size
d.text((x, y), text, font=font, fill=(255, 255, 255, 150),
stroke_width=max(1, size // 16), stroke_fill=(0, 0, 0, 90))
return Image.alpha_composite(im, layer).convert("RGB")
9.2 按内容打标
把同一份原图同时送一路给图像识别服务,返回的标签写进对象元数据(x-obs-meta-tags),前端即可在不改代码的前提下做筛选。识别调用放在函数末尾,失败只记日志、不回滚图片产物——图片链路与打标链路分开成败,是这类混合流水线的基本原则。
9.3 换成更快的解码器
处理 4000 万像素以上的专业图片时,libvips 的流式解码比 Pillow 快 3~5 倍,内存占用也更低。它需要在函数里预置 .so 并设置 LD_LIBRARY_PATH,适合有明确大图需求的场景,普通社交图片用 Pillow 足够。
十、收尾:这套结构的可复制性
把整篇文章压缩成四句话:源桶只进不出,目标桶只出不进;函数用临时密钥、按长边缩放、写前先探针;触发器按前缀后缀过滤,异常交给重试;慢的地方用预留实例补,贵的地方用生命周期与缓存降。
这套结构换个对象就能复用:视频抽帧写 thumbs/{ts}.jpg、文档转 PDF 存 docs/、CSV 转 Parquet 存 table/——事件源、函数骨架、幂等策略、日志格式全部一致,变的只是函数体内那 30 行处理逻辑。
下一步可以做的两件事:给产物加一张比对表(原图 MD5 → 产物 key),让重复上传直接短路;把函数改成「事件批量处理」,一次拉取 10 条 Record 合并处理,调用次数与冷启动概率同步下降。

- 点赞
- 收藏
- 关注作者
评论(0)