Anthropic 拆了 Agent 的记忆:一条错笔记,会被注入到每一轮会话
一句话定位:这不是"它记得多不多",而是"一条错的东西能活多久、能扩散到多远"——被测对象是记忆的分层结构与注入面的错误传播,不是召回率。同样的断言可迁移到客服知识库、配置中心、配额缓存、地址簿默认值、审批流的历史结论复用。
摘要
Anthropic 2026 年 11 月 6 日的工程博客把 Agent 记忆拆成四层:可搜索的会话日志、Agent 自己写的笔记、由笔记构建的 wiki、以及每次会话开头注入的那一小块。官方给出的对比很具体——同一个游戏任务,旧模型写了一万步、413 个文件只拿到一个徽章,新模型写了九个文件拿到四个。这篇不复述机制,只做一件事:把四层结构翻译成四类可写的断言,并且重点讲那个最容易被忽略的面——注入层。它用 token 少、看起来无害,但一条错的会被带到每一次会话。核心结论一句:记忆的验收不该测"记得对",该测"错的能活多久"。
一个游戏任务,跑到一万步左右,两套记忆策略交出了两份完全不同的账本。
旧模型存了 413 个记忆文件,分布在 225 个文件夹里,拿到一个徽章。新模型只存了两个文件夹、九个文件,外加一个顶层的 global.md,拿到四个徽章。
原文对这个差距的解释不复杂:旧模型记的是屏幕本来就一直在显示的东西,金钱和位置,这些每回合都在变,存下来很快过期,查起来还费时间;新模型留的是计划、策略、验证过的规则——这些只有自己写下来才存在。
这是 Anthropic 2026 年 11 月 6 日那篇工程博客的开场对比。我读的时候没有先想到"少即是多",而是想到另一件事:那 413 个文件,后来谁去清理?
因为记忆不是上下文的延伸。它是一个会被写入、被检索、会过期的持久化存储——按原文的定义,它甚至明确排除了权重更新、单次对话内的学习和上下文压缩这三种东西,只指"跨会话保留、之后能读到的知识"。
有持久化存储,就有失效策略。有失效策略,就有断言。
四层结构,决定了断言能写在哪一层
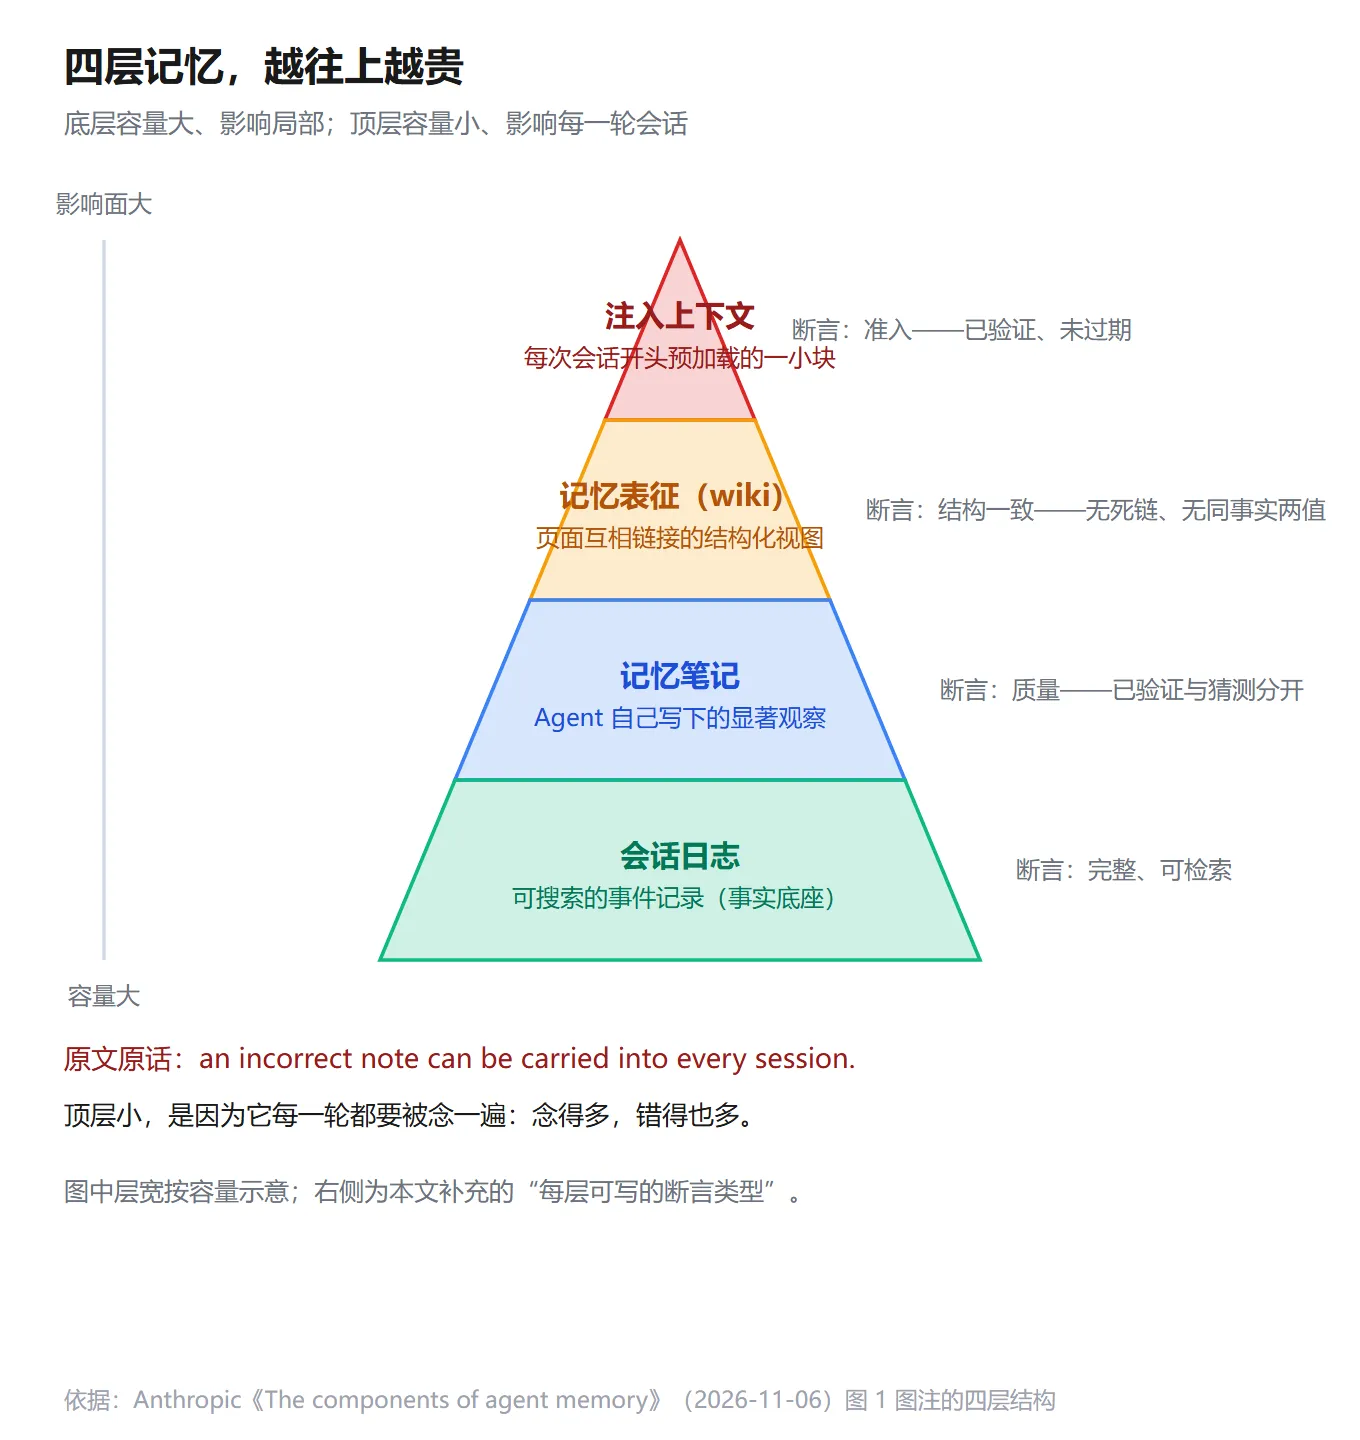
原文把记忆组织成从下到上的四层,我用更能对应测试场景的话重述一遍。
第一层,会话日志(transcripts):可搜索的事件记录,是整套记忆的事实底座。这一层能断言的只有两件事:完整性(这件事在当时被记录过)和可检索性(事后找得到)。它出问题的典型表现是"复盘时找不到当时为什么这么决定"。
第二层,记忆笔记(memory notes):Agent 自己写下的显著观察,比如一条被验证过的规则。这一层断言的是内容质量——有没有把已验证的事实和未验证的猜测分开,有没有写下"我怎么知道这条规则成立"。
第三层,记忆表征(representations,典型形态是 wiki):由笔记和日志构建出来的结构化视图,页面之间互相链接。这一层断言的是结构一致性——有没有指向不存在页面的链接,有没有同一个事实在两个页面里写了两个值。
第四层,注入上下文(injected context):每次会话开始前预加载的那一小块。这一层断言的是准入——什么内容有资格进来,进来多少,过期了怎么办。
四层里,前三层的错误是"局部的",第三层错了还能靠检索绕开;第四层错了是"全局的",因为它在每一轮会话开头都重新说一遍。
注入层为什么是最危险的那一层
原文有一句我几乎原样抄进了自己的验收模板:
Injected memories use up valuable tokens, and an incorrect note can be carried into every session.
两句话,两个成本。第一个是显性成本:token 是钱。第二个是隐性成本:错的笔记会被带到每一次会话。
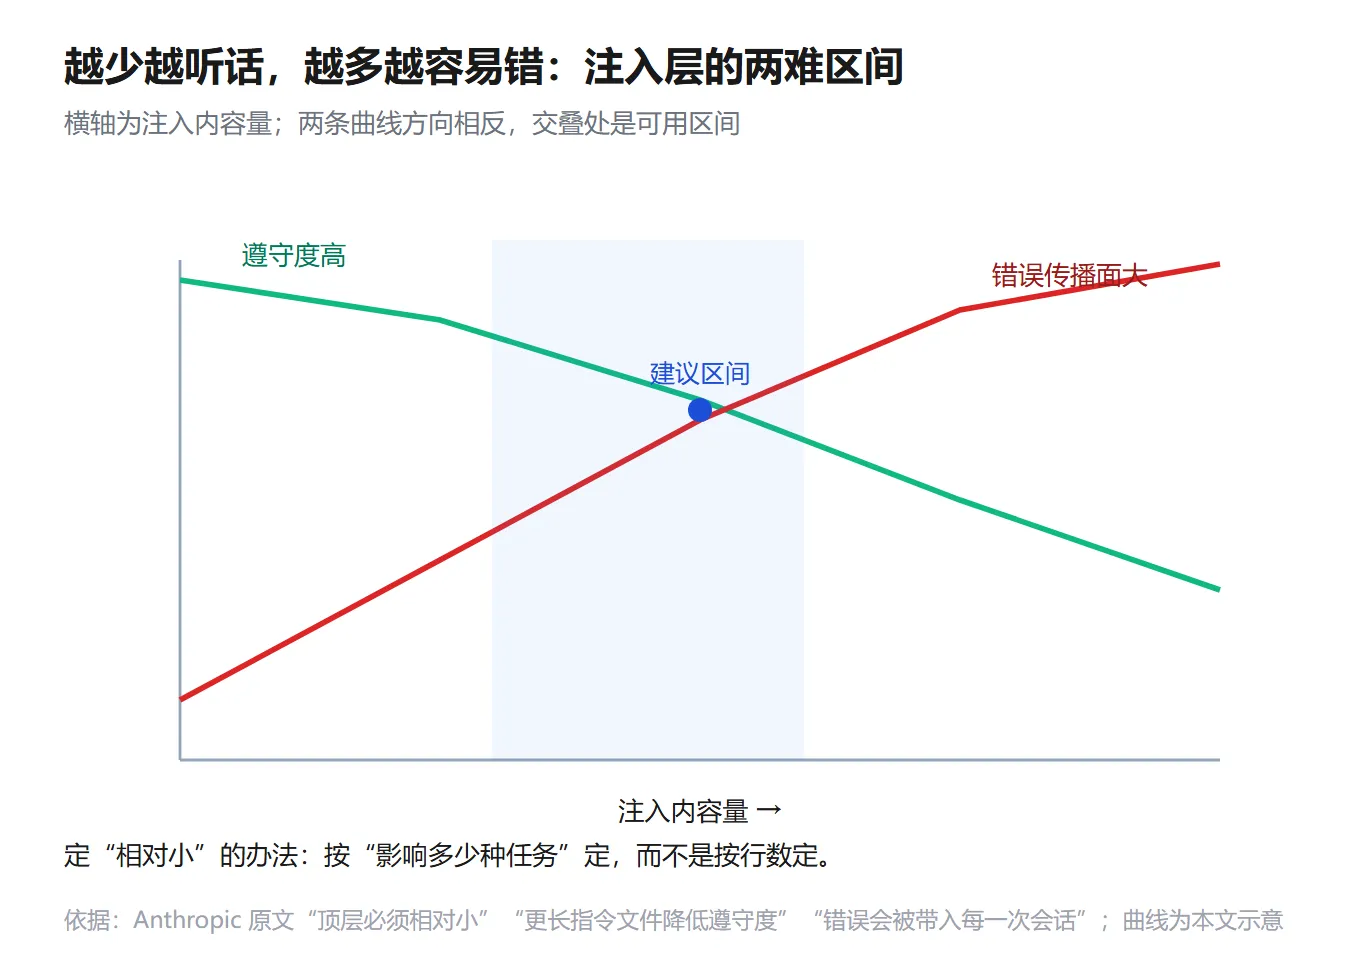
原文紧接着补了一刀:加载进去也不保证它会被遵守——Claude Code 的文档里就写了,更长的指令文件会降低遵守度。
这构成一个很别扭的三角:内容越少越容易被遵守,但少了又怕漏掉关键约束;内容越多越全,但遵守度下降、错误传播面扩大。 原文给出的处理方式是把顶层维持在"相对小",并且让 dreaming 在后台不断把细节下沉、只留链接。
我对这个设计的评价是:它在工程上是对的,但它把一个判断责任推给了使用者——什么算"相对小",谁定?
我自己的经验是别用行数或字节定,用"错误传播成本"定:一条内容如果错了,会让多少种任务出错。只影响一类任务的内容,留在 wiki 层;影响所有任务的内容(比如"这个客户是 VIP,不要提价格"),才进注入层,而且还必须带有效期。
四层各一条断言(可照做)
我按这套结构给一个"客服知识库 Agent"写了四条断言。场景是推演,断言是可用的。
# 记忆验收四条断言(构造数据,不依赖任何模型)
import re

notes = {
    "n1": {"text": "客户 A 要求不要电话联系,只能短信", "src": "t_20260810", "ttl": "2026-11-01", "verified": True},
    "n2": {"text": "客户 A 应该是 VIP", "src": "t_20260701", "ttl": None, "verified": False},
    "n3": {"text": "退款必须先查 48 小时内是否有重复申请", "src": "t_20260912", "ttl": None, "verified": True},
}
injected = ["n1", "n2", "n3"]

def assert_transcripts(n):
    # 第一层:笔记必须能追到一条可检索的会话记录
    return n["src"].startswith("t_")

def assert_note_quality(n):
    # 第二层:未验证的猜测不得写成陈述句;已验证的不得带模糊词
    if not n["verified"]:
        return bool(re.search(r"不确定|待确认|猜测", n["text"]))
    return not re.search(r"应该是|可能是|大概", n["text"])

def assert_representation(links, pages):
    # 第三层:wiki 链接不得指向不存在的页面
    return [l for l in links if l not in pages] == []

def assert_injectable(n, today="2026-11-12"):
    # 第四层:进注入层必须同时满足 已验证 且 未过期
    if not n["verified"]:
        return False
    if n["ttl"] and n["ttl"] < today:
        return False
    return True

bad_inject = [k for k in injected if not assert_injectable(notes[k])]
bad_note   = [k for k, n in notes.items() if not assert_note_quality(n)]
bad_trace  = [k for k, n in notes.items() if not assert_transcripts(n)]
dead_link  = not assert_representation(["n1", "n9"], pages=["n1", "n2", "n3"])

print("可注入检查未通过:", bad_inject)     # ['n1', 'n2']
print("笔记质量未通过:", bad_note)         # ['n2']
print("可追溯未通过:", bad_trace)          # []
print("存在死链:", dead_link)              # True
我实跑的结果是:注入层拦下 n1 和 n2——n1 因为有效期已过(2026-11-01 早于今天),n2 因为未验证。笔记质量只拦下 n2,n1 是已验证且带"只能短信"这类事实陈述,通过;死链检查返回 True,因为 n9 不在页面集合里。
四条断言里,第四条最有用也最少人写。注意它拦下 n1 的理由不是"这条记错了",而是"这条可能已经过期了"——客户三个月前说不要电话联系,今天可能改了主意。原文对过期这个问题的处理方式很实际:不是靠判断对错,而是靠 dreaming 拿会话日志去核对、修正。
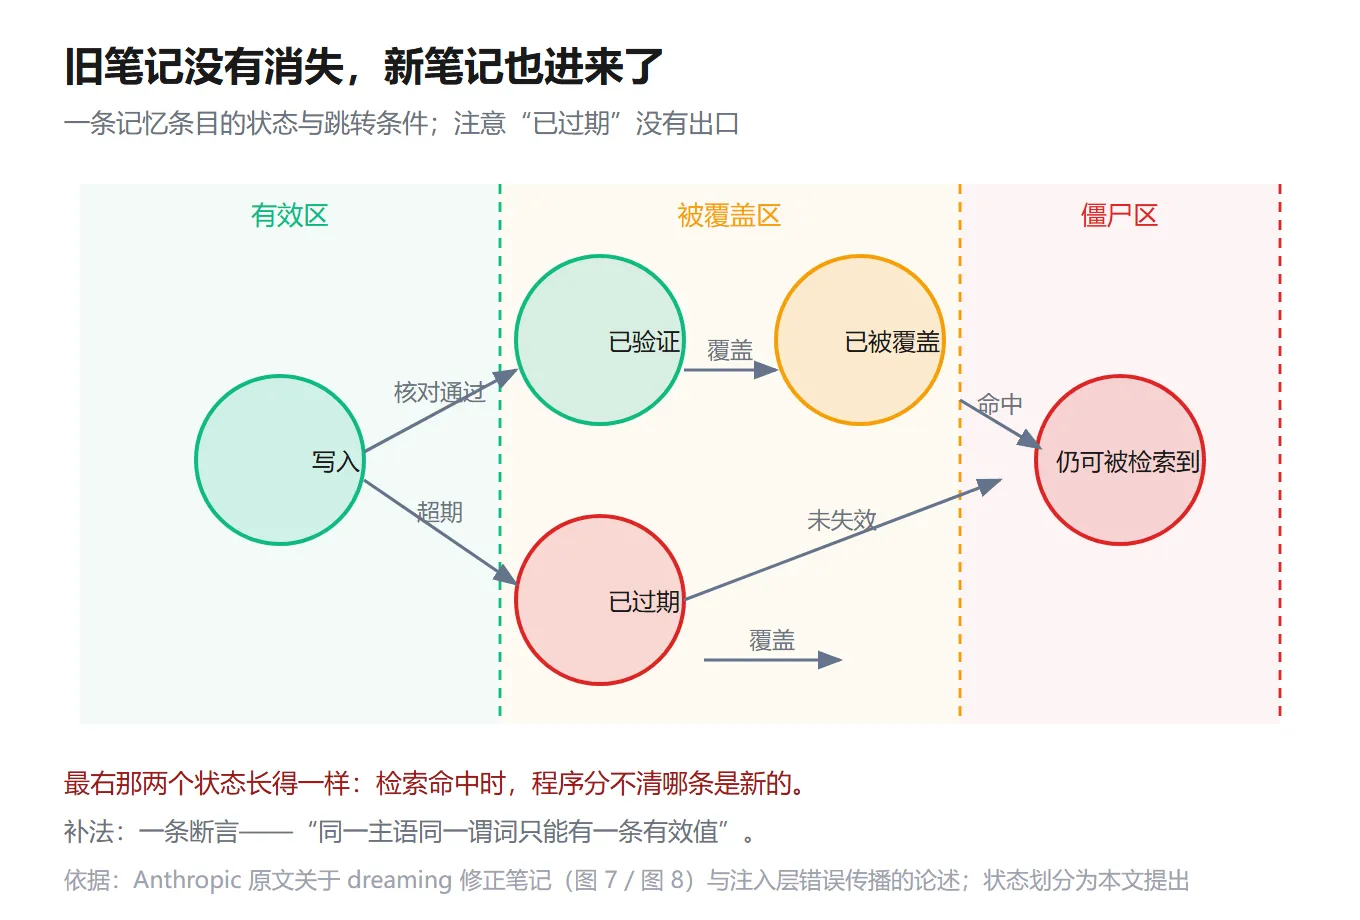
这里有一个我认为必须说明的边界:更新一条记忆,不等于旧的那条消失了。如果检索时命中了旧笔记、注入时又带上了新旧两条,正确性就变成了"模型有没有读到最新那条"。这类问题在缓存和配置中心里被解决过一千次,解法是带版本号并只认最新的那条。记忆系统目前多数没有这个字段,所以要在断言层补一个"同一主语同一谓词只能有一条有效值"的检查。
好的设计也会把 wiki 写胖
原文有一段很像自嘲的记录:他们让 Claude 从一个文档集合构建 wiki,有一组任务的语料是 10 个文档、115 KB,最后 wiki 长到了 68 个页面、255 条链接、203 KB——比原始语料还大。
原文引了博尔赫斯那个故事:地图画得和帝国一样大,等于什么都没抽象。
这件事对测试有直接启示。我们在做知识库、做 RAG、做任何"结构化整理"的时候,都会有一个自然的成功指标:覆盖了多少、沉淀了多少。而这个案例说明,这个指标可能正好是错的方向。一个比原文还大的摘要,是失败,不是成功。
可写的断言很具体:wiki 的总字符数不得超过源语料的两倍;任意一个页面的字数不得超过源文档单篇的最大字数;页面之间的链接密度不得高于某个阈值(否则说明碎片过多)。这三条都不涉及语义判断,全是可计算的。
原文也给了一个反向的例子:把 dreaming 从 2 轮加到 128 轮,25 道题的得分从 13% 升到 48%;wiki 加搜索工具时,随着 wiki 增长,综合分从 54% 到 61%,而只用搜索工具是 53%,并且每题还省了两万 token 左右。这些是官方自报的单组实验,原文没有把它当成通用结论,我也不。
我会怎么在团队里落地
三步,都很轻。
一,先量"注入层有多大"。你现在的 Agent 系统提示里有多少条是记忆内容?如果超过一半,就把它们按"影响多少种任务"分层,只留下影响最广的那几条。
二,给每条注入项加两个字段:来源(哪次会话)、有效期(什么时候必须复核)。没有来源的,直接不进注入层。
三,写那条"同一事实只能有一条有效值"的检查。这条检查不解决全部问题,但它能挡住最常见的一类错误——旧信息还在、新信息也进来了、模型按顺序读到了旧的。
原文最后那段话我很喜欢,大意是:记忆的价值在于它能纠正错,不在于它能记住多。这话换成测试语言就是——不要测它记得对不对,要测错的能活多久。 前者需要模型,后者只需要两个字段。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

- 点赞
- 收藏
- 关注作者
评论(0)