Anthropic 挖出 37966 条候选漏洞,台账上修好的 217 条:两边都没算错
二、摘要
2026 年 11 月 9 日,VulnCheck 的分析师 Patrick Garrity 基于 Anthropic 自己公开的漏洞台账做了一次清点:37966 条候选发现中,只有 217 条被标为已修复。而 Anthropic 官方口径是:5087 条已向维护者披露,629 条已获得上游补丁。**两个数字差了将近三倍,但双方都没有造假。**本文讨论的是行业正在形成的一个新问题——当发现能力被 AI 放大几十倍之后,"修好了"这个词由谁来定义。
先把两个数字来源分清楚,因为这篇文章的全部意义都在这里。
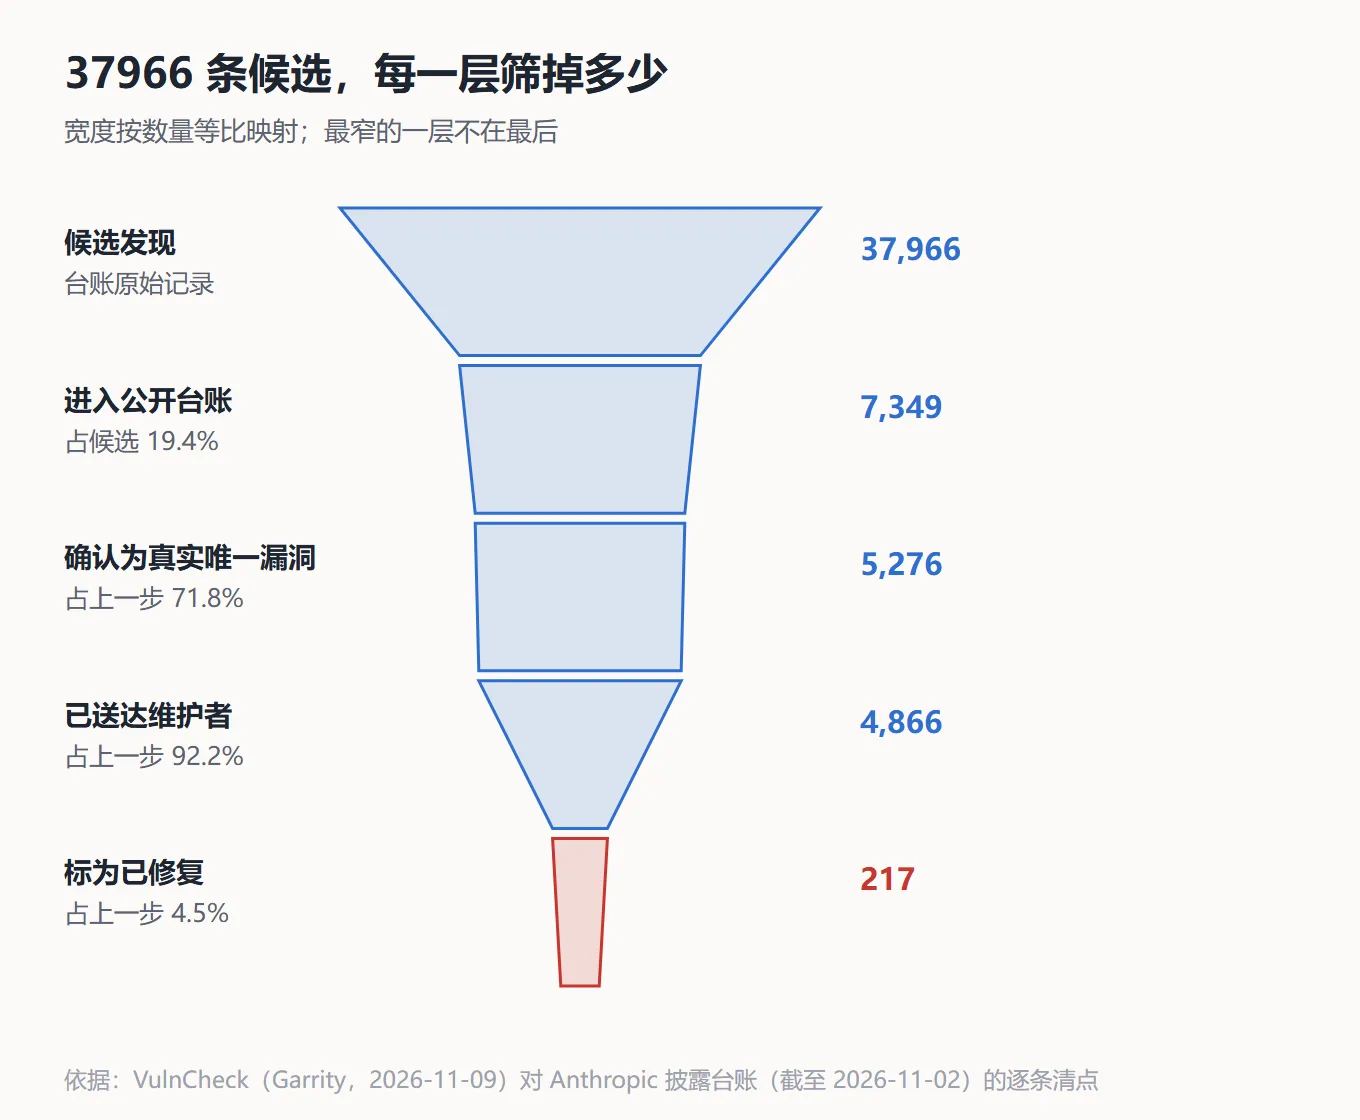
217 出自 VulnCheck 的 Patrick Garrity 在 2026 年 11 月 9 日发布的清点。他的方法是打开 Anthropic 自己的协同漏洞披露台账(数据截至 11 月 2 日),逐条数:37966 条候选发现,其中 7349 条出现在公开台账里(约 19.4%),这里面 5276 条被确认为真实且唯一的漏洞,1654 条是重复、419 条被撤回,4866 条已送达维护者、193 条还在预披露阶段,最后 217 条被标记为已修复。
629 出自 Anthropic 自己披露面板的同一批数据:截至 11 月 2 日,5087 条漏洞已在 680 个开源项目中披露,629 条已获得上游补丁。
同一批数据,两个"修好"的数,差了三倍。多家媒体(Infosecurity Magazine、I-Scoop、Metir AI)都注意到了这个差,并给了同一个解释方向:它们统计的不是同一样东西。
Garrity 数的是"台账条目里状态字段写着 fixed 的"。Anthropic 数的是"维护者那边合进了补丁的"。前者是流程状态,后者是代码事实。一个漏洞可能已经在项目里被修掉、但台账状态没更新;也可能台账标了 fixed,而上游其实换了个方式处理。
所以这不是一次财务造假式的争议,是一个更常见也更麻烦的问题:两个都诚实的统计,因为定义不同,给出了相差三倍的结论。
为什么这件事值得测试从业者看
这看起来是安全圈的事,跟测功能、测接口的人隔得挺远。我把它放进这个账号,是因为它是"验收口径"这个问题最干净的一个样本。
你自己团队每周都在做同样的事:修了多少个缺陷、关闭率多少、遗留多少个。"已修复"这个词在大多数项目管理系统里至少有四种含义——开发改完了、测试验证了、上线了、复现不了了。这四种混在一个字段里,做出来的月报就是一份谁也复核不了的报表。
Glasswing 这件事的价值在于它把这个混乱推到了公开层面,而且是双方都不打算遮掩的那种公开。
清理一下量级,别只看 217
把漏斗一层层剥开,37966 到 217 之间发生了什么,比单看两端更有信息:
| 阶段 | 数量 | 相对上一步 |
|---|---|---|
| 候选发现 | 37966 | — |
| 进入公开台账 | 7349 | 19.4% |
| 其中有真实且唯一的漏洞 | 5276 | 71.8% |
| 已送达维护者 | 4866 | 92.2% |
| 最终标为已修复 | 217 | 4.5% |
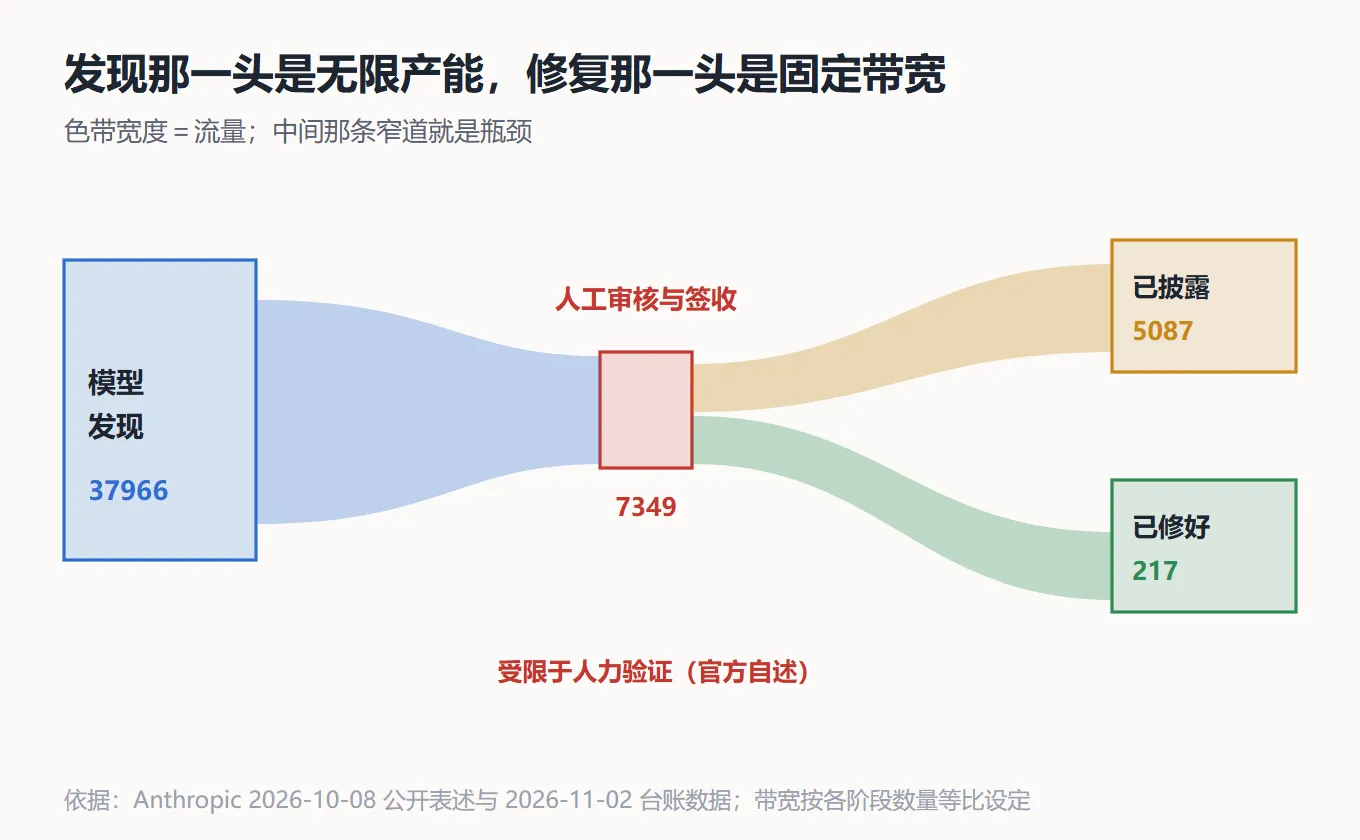
最陡的一次衰减不在最后一格,在第一次:37966 里只有 19.4% 进了台账。原文对这件事的解释是人工审核能力。Anthropic 在 10 月 8 日公开说过:模型已发现超过 29000 条候选漏洞,但人工只复核了约 6000 条,并且受限于人力,验证环节是瓶颈。
这句话是整个事件里最诚实的一句,也是分歧的根源。发现是模型做的,签收是人在做的。模型变快了,人没变快。
94.2% 的真阳率,为什么不能直接信
Anthropic 公布过 94.2% 的真阳率。这个数字被引用得最多,也最容易被误读。
Garrity 的质疑是:在一个有 1654 条重复、419 条撤回的台账里,94.2% 怎么算出来的?
要公平地说,Anthropic 的 94.2% 有一个限定语——它是外部安全研究公司评估过的那部分发现的真阳率,不是全部 37966 条。这个限定很重要,因为评估样本和工作样本不是同一批。
但限定语正是问题:一份报告写"真阳率 94.2%",读者不会自动去做这个减法。这跟前面说的四种"已修复"是同一个毛病——数字本身没错,但它在传播中丢掉了自己的定义。
我在自己的报告模板里加过一条规则,效果不错:每一个百分比后面必须跟一个括号,写清分母是什么。不是"94.2%“,是"94.2%(外部机构评估的样本内)”。写不出来就说明我自己也没想清楚。
curl 的那 45 份报告,是这件事最具体的一面
荷兰媒体报道里有一段值得逐字看:curl 的维护者 Daniel Stenberg 在 11 月 6 日收到了 45 份来自 Anthropic 的漏洞报告。他用 OSS Scanner 和其他工具分析了其中 34 份,结果是:19 份根本不是漏洞,6 份被确认为低危,9 份还在评估。
也就是三分之二被排除。这不是说 AI 找错了——45 份里挑出 9 份真问题,对一个已经被审了二十多年的老项目来说并不算差。它说明的是另一件事:维护者的工作量增加了 45 份,而实际需要他动手的可能是个位数。
curl 这个项目今年还因为报告量太大改了流程:低危和中危的报告改为在 GitHub 公开讨论,让社区其他人帮着看。一个运行了几十年的项目,因为上游 AI 的发现速度,被迫修改自己的安全处理规则——这件事本身比"修了多少个"更能说明结构性的变化。
一线分析:把"发现"和"修复"当成两条独立的流水线
我读完全部材料之后的一个判断,供参考:这次争议之所以绕不出来,是因为大家在用一条流水线的语言(修了多少)讨论两条流水线的事。
第一条流水线是发现。它的成本由模型决定,边际成本趋近于零,产能几乎是无限的,质量由真阳率刻画。
第二条流水线是修复。它的成本由维护者的时间决定,边际成本极高,产能固定,质量由"补丁是否被采用"刻画。
两条流水线的接口处,就是审核与签收。接口的带宽是人的注意力,几十年来没变过。当上游产能提高一个数量级而接口带宽不变,下游必然会堆积——这不是谁的错,是流量守恒。
一旦这样看,"217 还是 629"这个问题就不重要了。重要的是接口两侧的计数规则不同,而且短期内不会统一。想看清这件事,得分别问:这条流水线的产能是多少、接口带宽是多少、积压是在哪一段堆积的。
这个视角对测试团队同样成立。做自动化用例生成的人这几年产能涨得很快,而跑用例、看结果、判断"这算不算问题"的人力没涨。所以多数团队的积压不在用例数量,而在"待判定"的队列上。如果你的用例生成速度已经超过了你判断结果的速度,加更多的生成就是给自己制造积压。
这不是 Anthropic 一家的处境
同一周里还有别的信号。I-Scoop 的报道提到,AI 找 bug 的速度已经超过维护者能消化的速度,一些团队开始把"预算给审核员而不是给推理"。这个说法很朴素,但它把投资方向的判断说清楚了:如果瓶颈在接口,扩产能就是浪费。
放在更大的范围里看,这件事其实在替整个行业问一个问题:当一个环节被 AI 提速十倍,我们有没有同步把那个环节的"验收"重新定义一次?多数组织没有。它们的做法是把新产能塞进旧接口,然后抱怨堵车。
对个人来说,我能想到的最具体的一条建议是:如果你在做缺陷管理或者质量报告,去做一次"已修复"的字段审计。找十个状态为已修复的缺陷,逐个问清楚它现在说的是四种含义里的哪一种。这个动作花不了半天,但它会改变你后面所有报表的可信度。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

- 点赞
- 收藏
- 关注作者
评论(0)