告别“黑盒”运维:基于华为云 AOM 的微服务全景监控与智能告警实战
在微服务架构普及的今天,一个业务请求往往需要在十几个甚至几十个微服务之间穿梭。系统节点数量的剧增,使得传统的静态监控手段(如仅监控 CPU、内存利用率)难以应对复杂的线上故障。当故障发生时,运维人员往往面临“告警风暴”和“定位困难”的双重打击。
作为华为云云原生可观测性生态的核心入口,AOM(应用运维管理) 提供了集指标监控、日志分析、告警管理及微服务拓扑于一体的一站式运维平台。本文将带大家了解如何基于华为云 AOM 构建覆盖“基础资源 - 容器 - 应用 - 业务”的全景监控与智能告警体系。
什么是华为云 AOM?
华为云 AOM(Application Operations Management) 是云原生应用的一站式 IT 运维管理平台。它能够自动发现 CCE(容器引擎)、ECS(弹性云服务器)等底层资源上的应用及组件,实时采集性能指标、日志与事件,并通过全景拓扑图直观展示系统整体运行健康度。
AOM 的核心能力架构
+-------------------------------------------------------------------+
|                        华为云 AOM 运维指挥中心                       |
+-------------------------------------------------------------------+
       ▲                             ▲                             ▲
       │                             │                             │
【全景微服务拓扑】           【智能告警与收敛】           【全栈监控指标】
 - 实例健康度状态             - 告警静默与抑制             - 基础资源 (CPU/Memory)
 - 服务间调用依赖             - 降噪与多通道通知           - 容器/Pod 运行状态
 - 流量与时延分布             - 自动关联故障上下文         - 业务自定义 Metrics
构建全景监控体系的四个维度
要彻底告别运维“黑盒”,需要从以下四个层级建立完整的监控覆盖:
1. 基础资源与容器层监控
-
监控对象:ECS 主机、CCE 节点、Pod、容器 CPU/内存/磁盘 I/O/网络带宽。
-
实现方式:在 CCE 集群中一键部署
icagent采集插件,自动纳管集群节点与容器实例,零配置开启基础指标采集。
2. 微服务与应用层监控
-
监控对象:JVM 堆内存、GC 频率、HTTP/RPC 请求 QPS、响应时间(Latency)、错误率(5xx 比例)。
-
实现方式:接入 PromQL 标准接口,将应用暴露的
/actuator/prometheus端点自动接入 AOM,实现应用性能的实时度量。
3. 微服务依赖拓扑可视
AOM 能够基于实际流量自动绘制微服务拓扑图:
-
红黄绿三色预警:绿色代表健康,黄色代表高时延,红色代表存在服务异常或高错误率。
-
上下游依赖分析:秒级识别是上游 API 网关过载,还是下游数据库/Redis 瓶颈导致的系统变慢。
4. 日志与事件联动
通过与 LTS(日志服务) 深度整合,在 AOM 查看某节点指标异常(如 CPU 飙升至 99%)时,可直接下钻查看该时间段内产生的错误日志,无需切换平台。
智能告警配置最佳实践:拒绝“告警风暴”
在大型系统中,单点故障可能瞬间触发成百上千条告警。AOM 提供了智能降噪与告警抑制机制,帮助团队精准捕获真正关键的故障。
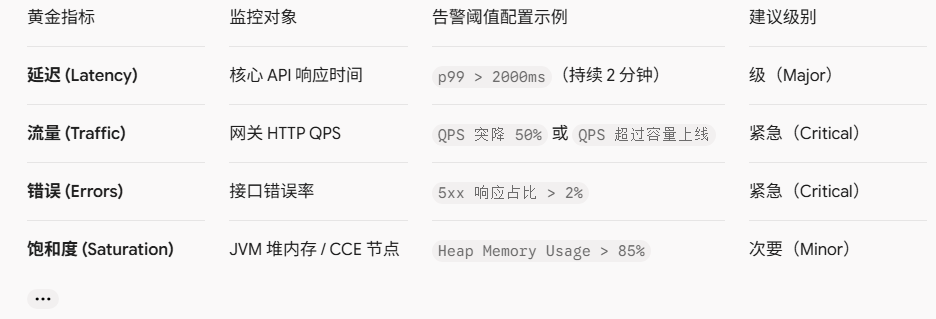
步骤 1:基于黄金指标(Golden Signals)创建告警规则
建议优先针对以下四项黄金指标设置告警:
步骤 2:配置告警抑制与分组规则
-
告警分组:将相同微服务集群、同一故障源触发的多条告警合并为一条“聚合通知”。
-
告警抑制:例如设置规则“当 CCE 节点处于 Down 状态时,抑制该节点上所有 Pod 抛出的网络超时告警”,避免次生告警干扰排障。
步骤 3:多通道通知与移动端推送
结合华为云 SMN(消息通知服务),将不同级别的告警分派至不同的通知渠道:
-
紧急/重要告警:通过电话、短信及钉钉/飞书机器人实时通知值班运维人员(On-Call)。
-
次要/提示告警:发送至团队邮件列表或内部 Slack/企业微信运维群,供日常巡检参考。
总结
基于华为云 AOM 构建的全景监控与智能告警体系,实现了从“人找故障”到“故障找人”的运维模式转变。通过指标、日志与拓扑的深度融合,运维团队能够将平均故障恢复时间(MTTR)从小时级缩短至分钟级,为企业业务的稳定运行保驾护航。
欢迎在评论区分享您在微服务监控、Prometheus 告警治理或运维自动化方面的经验!

- 点赞
- 收藏
- 关注作者
评论(0)