考古|Groovy 迁 Painless,ES 5.0 最常见的差异是参数要加 params. 前缀
5.0 把默认脚本语言从 Groovy 换成 Painless。两者语法相近,最常见的差异是参数必须带
params.前缀。除了换语言,同一节还有三处会直接让老请求失败:script.default_lang设置删除、1.x 的字符串写法("script": "...")和script_file/script_id参数删除。本文对照 v5.6.16 逐条核对,并给出 Painless 未定义变量的报错原文。
说明
实测环境:本地起的 Elasticsearch 5.6.16 单节点实例(官方 tar 包直接跑,堆内存 512MB,机器学习关闭),curl 连本地 9200 端口。本文「实测」小节的命令和输出都出自这个实例。
来源和边界先交代:本文的依据出自 v5.6.16 标签下的官方文件(scripting.asciidoc、Script.java、ScriptSettings.java),文中引用的原文均来自这些文件。示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
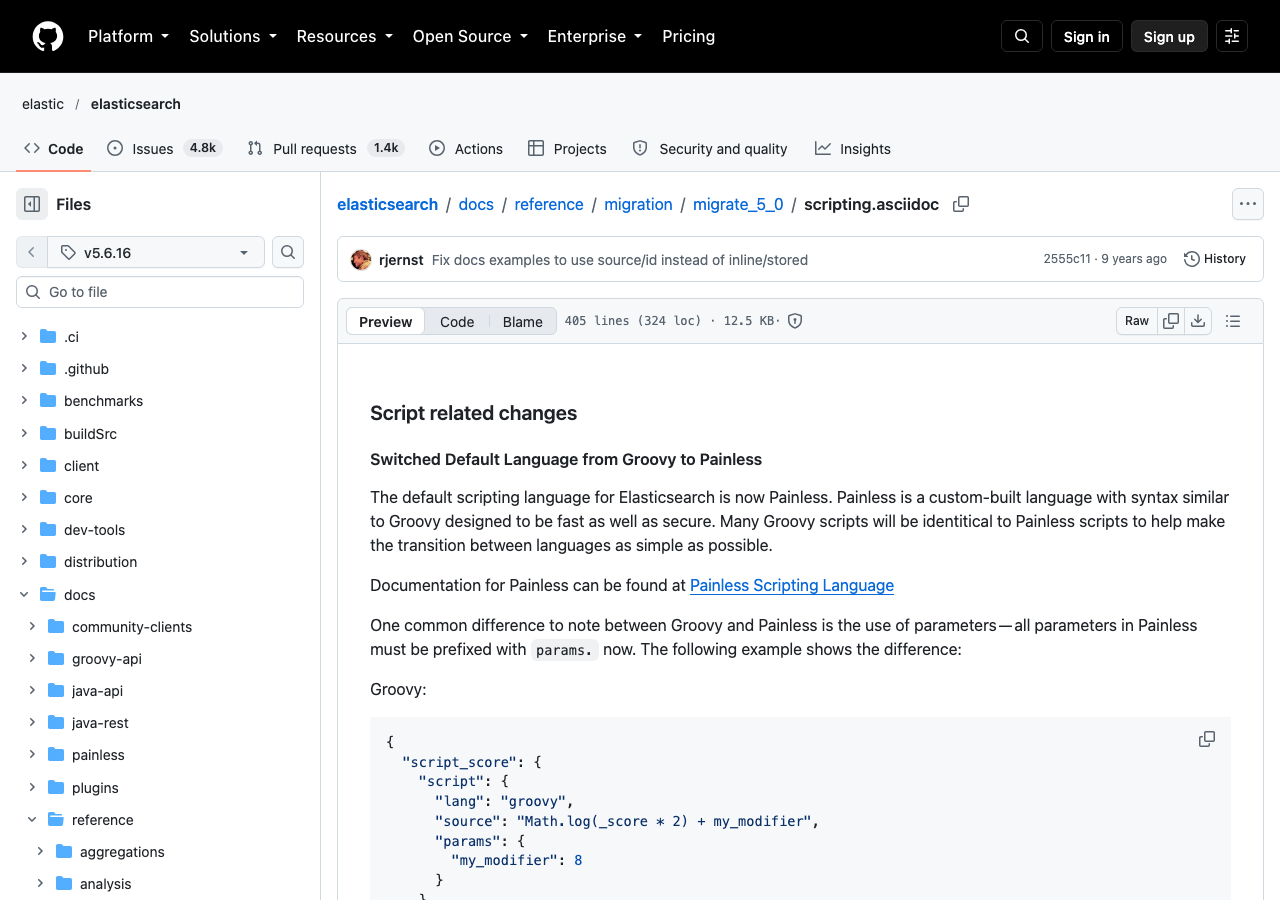
图 1:官方文件 scripting.asciidoc(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 scripting.asciidoc
官方说明
5.0 迁移文档(migrate_5_0/scripting.asciidoc 第 4–13 行):
The default scripting language for Elasticsearch is now Painless. Painless is a custom-built language with syntax similar to Groovy designed to be fast as well as secure. Many Groovy scripts will be identitical to Painless scripts to help make the transition between languages as simple as possible.
One common difference to note between Groovy and Painless is the use of parameters – all parameters in Painless must be prefixed with
params.now.
源码里 Script.DEFAULT_SCRIPT_LANG 的值是 painless。
同一节还有一条容易被漏掉(第 49–53 行):
The
script.default_langsetting has been removed. It is no longer possible set the default scripting language. If a different language thanpainlessis used then this should be explicitly specified on the script itself.
所以以前靠改设置切换默认语言的做法没有了,要用别的语言就在脚本上显式写 lang。对已经存在的 percolator 查询里没写语言的脚本,script.legacy.default_lang 这个设置还能控制(ScriptSettings 第 45 行),默认值是 groovy(第 36 行)。
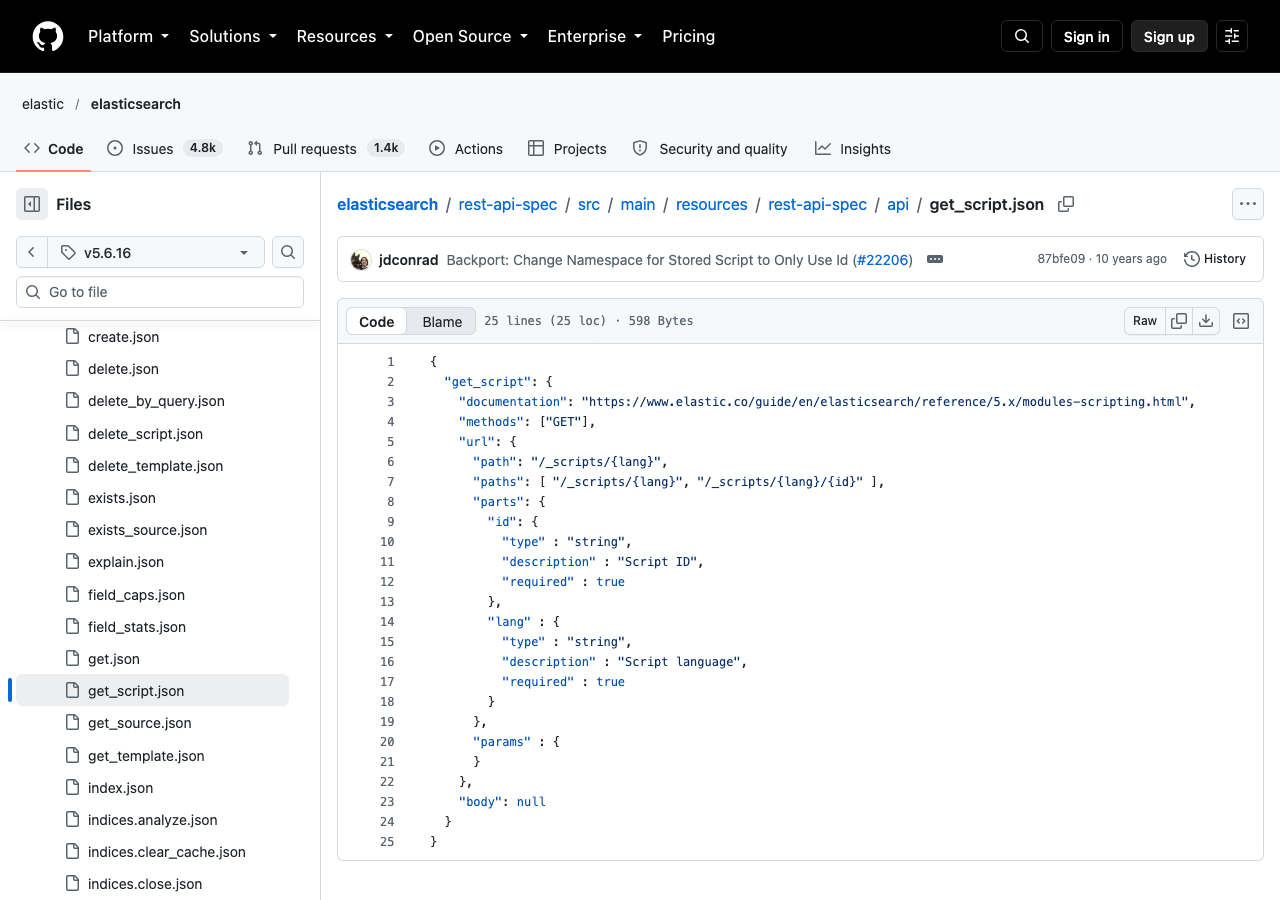
图 2:官方文件 get_script.json(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 get_script.json
为什么要换
Groovy 是通用 JVM 语言,功能强,但也意味着脚本能访问的东西太多,只能靠 Security Manager 白名单从外面堵。Painless 是 ES 自己造的、语法类似 Groovy 的语言,设计目标就是快和安全:语法受限、能访问的东西由语言本身限定。
5.6.16 的脚本文档里按是否带沙箱给语言分层(security.asciidoc 第 56–60 行):Painless 属于"有强安全沙箱"的语言,可以直接内联、可以存进集群状态;文档也提到 ES 除了脚本沙箱之外还使用 Java Security Manager。Groovy 不在这一层。
图 3:官方文件 Script.java(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 Script.java
最常见的改写点
Groovy 写法(迁移文档里的示例,第 15–29 行):
{
  "script_score": {
    "script": {
      "lang": "groovy",
      "source": "Math.log(_score * 2) + my_modifier",
      "params": { "my_modifier": 8 }
    }
  }
}
Painless 写法(第 32–46 行):
{
  "script_score": {
    "script": {
      "lang": "painless",
      "source": "Math.log(_score * 2) + params.my_modifier",
      "params": { "my_modifier": 8 }
    }
  }
}
Groovy 里 params 的键会被注入成脚本作用域的变量,所以 my_modifier 能直接用。Painless 不做这种注入,参数一律通过 params 这个显式容器访问。
这个差异同时解决了一个实际问题:脚本里的标识符来源清楚了,params.xxx 是外部传入、doc['field'] 是文档数据,其他是语言内置的。隐式注入容易和脚本里的局部变量重名。
1.x 的脚本写法被删
这一条和换语言无关,但同样会让老请求失败(第 55–136 行):
script和params作为字符串参数的写法不再支持,必须写script对象(source或id或file加params)。影响 update API、script sort、script_score、scriptquery、scripted_metric聚合、script_heuristic聚合;- 引用文件脚本的
script/script_file参数不再支持,改用file; - 引用 indexed script 的
script_id参数不再支持,改用id。
所以迁移时不能只把参数加上 params.,还要看脚本本身是用旧的字符串形式还是对象形式写的。
Groovy 在 5.x 里还能用,但有条件
modules/lang-groovy 在 5.6.16 里仍然存在(GroovyScriptEngineService 的 NAME 是 groovy),但使用方式受限。脚本文档写的是(using.asciidoc 第 66–70 行):Painless、expression 这类语言可以直接当 inline 或 stored 脚本用,而 groovy 这类语言只能作为 file 脚本,除非你先调整脚本安全设置。
也就是说,内联的 Groovy 在默认配置下不可用,这比"Groovy 还能用"这句话要严格。长期还是应该迁到 Painless。
迁移步骤
- 把脚本的
lang改成painless(或者不写,5.0 起默认就是 Painless); - 脚本正文里所有来自
params的变量加params.前缀; - 字符串形式的脚本改写成
script对象形式;script_file改file,script_id改id; - 逐条在 5.0 环境跑一遍:Painless 的语法限制比 Groovy 多,涉及反射、动态方法调用、闭包技巧的脚本需要重写;
- 确认脚本里访问文档数据用的是
doc['field']这种写法(fields.asciidoc 第 90 行起)。
另两类差异
静态类型
Painless 是静态类型语言,运算前类型要能确定。doc['count'].value 是数字,和字符串拼接、和不同类型的数做运算都可能报错,改法是显式转换:
(long) doc['count'].value * params.factor
报错信息会指向具体表达式,先定位再转换。
可用的 API 变窄
Groovy 里能用的很多类和方法在 Painless 里不存在,这是能力面收窄的直接结果。典型的是日期处理、集合操作这类:我的判断是,如果脚本里用了较复杂的标准库调用,很可能要重写逻辑,不是改语法就行。
我的建议是把复杂的脚本逻辑搬出 ES。脚本适合简单的字段运算和条件判断,一旦需要复杂的库调用,放到应用层做,ES 里只存结果:既避开 Painless 的限制,也不给集群增加执行负担。
排障
Painless 报未定义变量时,消息格式在 Locals 第 142 行:
Variable [factor] is not defined.
这只是其中一种。按下面的顺序排查,能覆盖多数迁移报错:
- 先看参数前缀:报
Variable [xxx] is not defined通常就是忘了加params.; - 再看类型:静态类型引起的报错会指向具体表达式,定位后加显式转换;
- 最后看空值:文档里某个字段缺失时,
doc['field'].value的行为和预期可能不同,稳妥的做法是先用doc['field'].size != 0判断再取值。空值保护在脚本里做,比让它抛异常后再排查便宜。
换语言比加沙箱更根本
2.2 用 Security Manager 把 Groovy 关进沙箱,5.0 换成 Painless。两步的关系:
- 沙箱是在通用语言外面加围栏:Groovy 能做的事太多(文件、网络、反射),只能一个个堵,而且每次 Groovy 升级都可能带来新的口子;
- Painless 是从语言层面缩小能力面:它本来就不能访问文件和网络,不需要围栏。
所以它换掉的不只是语法:安全模型从[“”“']堵漏洞[“””‘]变成了[“”"’]没这个能力[“”"']。能用受限能力解决的,别用通用能力加限制来解决。
代价是 Groovy 脚本要改,Painless 是静态类型、语法限制更多。这些代价是一次性的,而沙箱方案的代价是长期的:维护白名单、跟着上游升级。
怎么验
改脚本的一次完整验证:
# 找代码里的脚本
grep -rn '"script"\s*:\|new Script(' --include=*.java --include=*.py --include=*.json . | head -30

# 集群里已存的脚本(按语言列)
curl -s 'localhost:9200/_scripts/painless' | python3 -m json.tool
存脚本的端点是 /_scripts/{lang}(get_script.json),按语言列举。
找到之后两件事:参数全部加 params.;逐个执行一次,未定义变量、类型不匹配这类问题只有执行才会暴露,读代码看不出来。
验证改对了没有,用同一个脚本在改前后对同一批文档各跑一次,比对结果。结果一致才算改对:涉及数值计算的脚本,类型转换改错不会报错,但算出来的值会偏。比对要拿真实数据做,造几条测试数据跑通说明不了什么,问题往往出现在边界值上:空值、负数、超长字符串、除零。
脚本的长期成本
脚本的便利是"不用改应用就能改逻辑",代价是:每次执行都要在集群上跑,占用搜索或写入线程的资源;调试比应用代码困难,报错只在执行时出现;迁移时要逐个验,这次就是这样。
判断标准是:脚本适合简单、稳定、和文档字段强相关的运算(按字段值算一个分数、按条件过滤),不适合业务逻辑。业务逻辑会变,变了就要改脚本,而改脚本的成本高于改应用代码。借这次迁移做一次清点,把复杂逻辑往应用层搬,下次再遇到语言或 API 变化时改动面会小很多。
在 5.6.16 上跑一遍
同一个脚本排序,只换 lang:
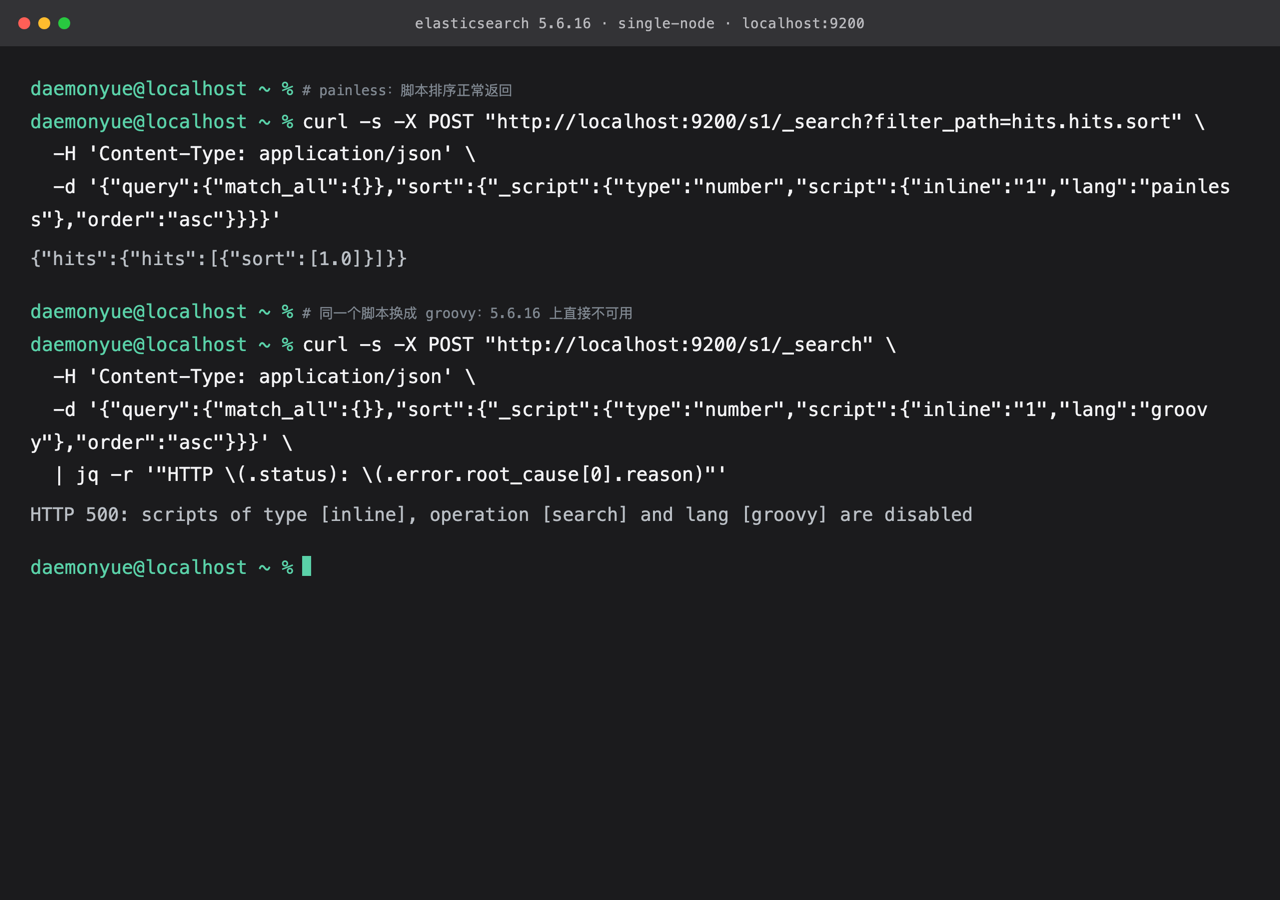
图 4:本地 5.6.16 单节点实例上的实测输出。上:painless;下:groovy
curl -s -X POST "" \
  -H 'Content-Type: application/json' \
  -d '{"query":{"match_all":{}},"sort":{"_script":{"type":"number","script":{"inline":"1","lang":"painless"},"order":"asc"}}}}'

curl -s -X POST "" \
  -H 'Content-Type: application/json' \
  -d '{"query":{"match_all":{}},"sort":{"_script":{"type":"number","script":{"inline":"1","lang":"groovy"},"order":"asc"}}}' \
  | jq -r '"HTTP \(.status): \(.error.root_cause[0].reason)"'
painless 那条返回 {"hits":{"hits":[{"sort":[1.0]}]}},脚本排序生效;groovy 那条返回 HTTP 500: scripts of type [inline], operation [search] and lang [groovy] are disabled。
注意状态码是 500,不是 400。这类"语言不可用"的失败在 5.x 里是从分片那边抛上来的,所以外层是 search_phase_execution_exception、把所有分片失败包在里面。客户端如果只判 4xx,会把它当成"服务端出事了"去重试,而重试多少次都不会变。
结论是:迁移脚本时别只改 lang 字段就完事。5.x 的报错路径和 4xx 不一样,告警和重试逻辑要跟着改;另外 params. 前缀那件事要逐个脚本过一遍,语言换过去之后才暴露。
写在最后
5.0 的脚本迁移有两层:一层是换语言,参数加 params.、静态类型、API 变窄;一层是写法,script.default_lang 删除,字符串形式和 script_file、script_id 不再支持。第二层和语言无关,容易被漏掉。
改完按"参数前缀、类型、空值"的顺序排查报错。验的时候要拿真实数据比对结果,语法错误会立刻报,逻辑错误不会。
参考
本文对照 Elasticsearch
v5.6.16标签的官方文档核对,引文逐字取自原文。图 4 的两次脚本排序来自本地 5.6.16 单节点实例。

- 点赞
- 收藏
- 关注作者
评论(0)