ES|QL|全文函数能写进 OR 了,同字段多词还是别这么写
9.0 之前,ES|QL 里
MATCH(或其它全文函数)不能出现在OR里——写了会报错。9.0 分两步放开了这个限制。这个限制为什么存在,比"现在能用了"更值得知道。
说明
实测环境:本地起的 Elasticsearch 9.4.2 单节点实例(官方 tar 包直接跑,堆内存 512MB,安全与机器学习关闭),curl 连本地 9200 端口,_query 接口走 ES|QL;测试文档在实验时现场写入。图 4 出自这个实例。
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.0.0.yml、EsqlCapabilities.java),文中引用的原文均来自这些文件。示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
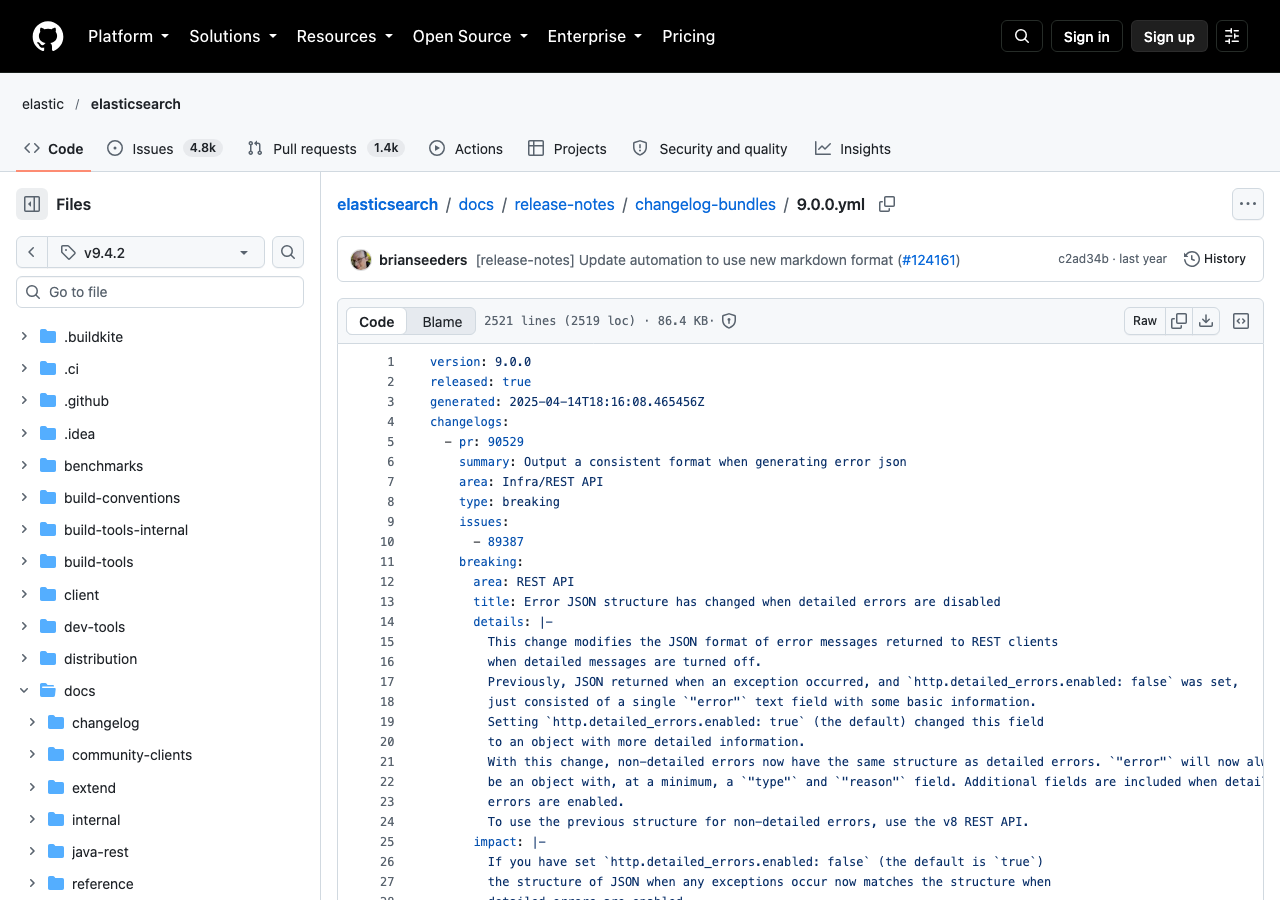
图 1:官方文件 9.0.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.0.0.yml
官方条目
9.0 的 changelog 里有两条相关条目。
放开限制(9.0.0.yml 第 1585–1588 行 @ v9.4.2):
ESQL - Allow full text functions disjunctions for non-full text functions
加打分(9.0.0.yml 第 2023 行 @ v9.4.2):
ES|QL - Add scoring for full text functions disjunctions
两条都只有一行 summary。下面的内容来自源码。
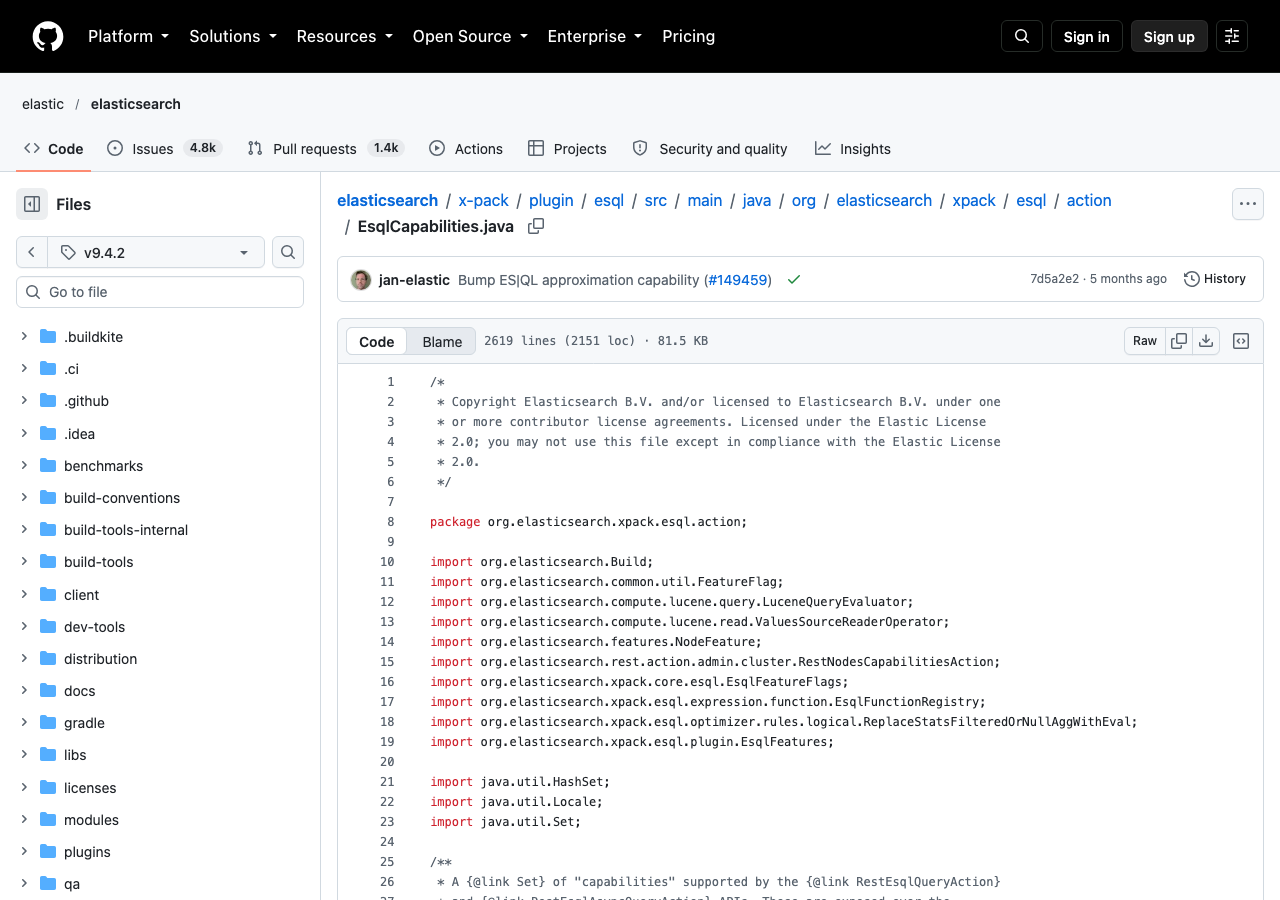
图 2:官方文件 EsqlCapabilities.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 EsqlCapabilities.java
先说什么是析取
析取(disjunction) 就是逻辑上的"或"(OR)。
在 ES|QL 里大致长这样:
FROM logs
| WHERE MATCH(message, "timeout") OR MATCH(message, "refused")
这条查询在 9.0 之前是不合法的。
为什么以前不行
这段是理解,官方没解释过,但源码里的注释支持这个推测。
原因在全文检索和普通过滤的执行方式不一样。
普通条件(=、<、范围、term 之类)是"是或否"的:每条文档要么符合,要么不符合。这类条件可以自由组合,AND、OR 都行。
全文函数不一样。它返回的不只是"是否符合",还有一个相关度分数。MATCH(message, "timeout") 告诉你"符合,且相关度 0.73"。
问题来了:OR 两边都有分数,合并之后的分数怎么算?
- 取大的?(max)
- 相加?(sum)
- 还是别的?
这不是一个有唯一正确答案的问题——不同的合并方式会给出不同的排序结果。而 ES|QL 的早期实现里,这块没有定论,所以直接禁止。
这是稳妥的做法:宁可报错,也不要给出一个"看起来能用但排序说不清"的行为。报错你能立刻发现;排序不对则要很久才被察觉。
图 3:官方页面 esql-search-tutorial.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 docs/reference/query-languages/esql/esql-search-tutorial.md
两条条目的区别
源码里有两个 capability,注释把它们说清楚了(EsqlCapabilities.java 第 1019–1022 行、第 1039–1042 行 @ v9.4.2):
/**
 * Full text functions can be used in disjunctions
 */
FULL_TEXT_FUNCTIONS_DISJUNCTIONS,
/**
 * Full text functions can be used in disjunctions as they are implemented in compute engine
 */
FULL_TEXT_FUNCTIONS_DISJUNCTIONS_COMPUTE_ENGINE,
两条注释的区别在第二句:有没有 “as they are implemented in compute engine”。
理解是分了两步:
- 第一步(第一个 capability):先支持,可能是在某个执行路径上实现;
- 第二步(带
_COMPUTE_ENGINE):改成在计算引擎里实现——这是更通用的实现位置,不再依赖能否翻译成 Lucene 查询。
(说明:这两步的先后顺序和具体差异是推断。从 capability 的注释和命名判断它们是两个阶段,但未查证各自的引入版本和切换时机。)
"在计算引擎实现"是条演进线索
这个词值得解释一下,因为它是理解 ES|QL 演进的线索。
ES|QL 有两种执行路径:
- 能下推给 Lucene 的:把查询翻译成 Lucene 查询,交给倒排索引执行。快,但只能表达 Lucene 支持的操作;
- 走计算引擎(compute engine)的:ES 自己实现的列式计算。通用,什么都能算,但不一定能利用倒排索引。
早期 ES|QL 的很多功能依赖"下推到 Lucene"。好处是快,坏处是遇到 Lucene 表达不了的结构就无能为力——而全文函数的 OR 组合恰好可能属于这类。
改到计算引擎里实现,意味着不再依赖"能不能翻译成 Lucene 查询"。这是从"能用"走向"通用"的一步。
(说明:这段关于两条执行路径的描述属 ES|QL 的通用架构认知,未逐个核实这条改动具体走了哪条路径。)
报错长什么样,以及怎么绕过
既然 9.0 之前会报错,那如果你在老版本上遇到,会看到什么?这一点未实测,无法给出原文。但根据 ES|QL 的报错习惯,大概率是一句"全文函数不支持在此处使用"之类的提示,而不是莫名其妙的语法错误。
老版本上想表达"命中任意一个",有三个办法:
一,一个 MATCH 里写多个词。 前面提过,这是首选:
FROM logs
| WHERE MATCH(message, "timeout refused unreachable")
MATCH 内部默认按 OR 语义处理多个词,等价于你要的 OR 链。
二,用 IN / 多值比较代替非全文部分。 如果其中一部分其实不是全文条件(比如状态码),那部分本来就支持 OR,问题只在全文那一侧。
三,升级。 如果这个需求频繁出现,升级到 9.0+ 是根本解法。
列这三个是因为"这个限制让查询写不了"是个具体的困境,而多数情况下第一条就能解决——不需要升级,也不需要绕。
这也说明了一件事:限制之所以能维持那么久,一部分原因是它的替代品足够好用。真正需要跨字段 OR 全文条件的场景,比想象中少。
现在能怎么写
放开之后,下面这类写法是合法的:
FROM logs
| WHERE MATCH(message, "timeout") OR MATCH(message, "refused")
混合普通条件也可以(这是第一条 changelog 里 “for non-full text functions” 的意思):
FROM logs
| WHERE MATCH(message, "timeout") OR status_code == 500
打分是第二条条目加的。也就是说放开语法和加上打分是两件事——先允许你写,再让它的分数可用。
(说明:上面两条查询按语法规则构造,未实际执行过;具体的函数签名和参数形式以你版本的文档为准。)
分数怎么合并
这是最想说清楚、也最没法给确定答案的一点。
OR 两边都有分数时,ES 怎么合并?按 ES 的传统,Lucene 的 BooleanQuery 在 SHOULD 子句下默认是求和(再配合协调因子等),但也有其它模式。
ES|QL 里具体采用哪种,未从源码确认,所以不写死一个结论。
如果你依赖排序结果,这里是必须实测的地方。 做法很简单:
FROM logs
| WHERE MATCH(message, "timeout") OR MATCH(message, "refused")
| SORT _score DESC
| LIMIT 10
跑一遍看排序是否符合预期。尤其是"两个词都命中"的文档排在哪——这是最能体现合并规则的地方。
(说明:_score 在 ES|QL 里的可用性未确认。ES|QL 的 SCORE 讲 SCORE 函数,那里提到过相关用法,可以参考。这段示例同样是构造的,未执行。)
和 Query DSL 的 bool 查询放一起看
如果你熟悉 Query DSL,看到这里应该会觉得眼熟——bool 查询里的 should 就是干这个的:
{
  "query": {
    "bool": {
      "should": [
        { "match": { "message": "timeout" } },
        { "match": { "message": "refused" } }
      ]
    }
  }
}
DSL 里这件事从来都是支持的,分数合并也有成熟的规则(should 下的子句分数累加,配合 minimum_should_match 等参数)。
所以这条改动本质上是在补 ES|QL 相对 DSL 的差距。
这个视角能帮你判断一件事:ES|QL 目前还不是"DSL 的完整替代"。它在逐步补齐能力,某些结构现在能写了,某些还不行。遇到写不了的,先看 DSL 里对应怎么写、ES|QL 是否已支持——换了语言不等于所有能力都在。
判断:ES|QL 的定位是查询语言层面的统一,不是要一次性搬完 DSL 的全部表达力。所以补齐会持续进行,短期内"某个结构不支持"仍会遇到。遇到时先找替代写法,比硬等支持更实际。
OR 分支多了之后性能和分数怎么变
OR 的分支数量多了之后,性能和分数会怎么变,不确定。
逻辑上,分支越多要评估的全文条件越多,开销越大。但具体增长是线性还是更差,没有数据也未实测。
建议:如果 OR 里有五六个以上的全文函数,先测一下延迟。这属于"能写不代表该这么写"的地方。
另外:同样的语义如果在 DSL 里能写出来,可以先拿 DSL 跑一遍做对照。两组结果对比着看,比单独看一边更容易判断 ES|QL 的行为是否符合预期。
该不该这么用
放开限制不等于推荐这么用。判断:
适合:
- 两三个同义/近义词做 OR(
timeout OR refused OR unreachable); - 全文条件和非全文条件混合;
- 你确实需要"命中任意一个"的语义。
不太适合:
- 一大串词做 OR —— 这通常说明你该用的是一个
MATCH里写多个词。MATCH(message, "timeout refused unreachable")本身就会按 OR 语义处理,而且走的是 Lucene 的原生路径,更直接也更可能更快; - 需要精细控制各分支权重 —— 那应该看
SCORE或 Query DSL 的bool查询。
第一条特别要说:很多时候你以为需要写 OR,其实一个 MATCH 就够了。 放开限制解决的是"跨字段、跨类型"的组合需求,不是"同字段多词"。
和别的能力放开放一起看
9.x 里 ES|QL 一直在补齐能力,前面写过几篇:
| 篇 | 补齐什么 |
|---|---|
| FORK 与 INLINE STATS | FORK / INLINE STATS |
| ES|QL 的 SCORE | SCORE 函数 |
| SAMPLE 聚合 | SAMPLE 函数 |
| 本篇 | 全文函数的 OR |
| time_series 里的 nested | TSDB 下的 nested |
共同的模式:先禁止(因为行为没定论),等想清楚了再放开,有时还分阶段放开。
对这个节奏的评价是正面的。相比"先放出去再说、后面再改行为",先禁止的成本更低——用户的错误认知一旦形成,很难纠正。报错虽然不友好,但它不会让你产生"这个排序是对的"的错觉——排序错了比报错了更难发现,这个不对称决定了先禁止是对的。
放开之后要留意什么
限制解除往往比限制存在时更需要小心——因为没有报错提醒你了。列几条容易出问题的地方。
一,结果集会变大。 OR 天生比 AND 匹配得多。原来因为写不了 OR 而用别的方式表达的查询,换过来之后命中数可能明显增加。如果下游有分页或者条数假设,先确认一下。
二,排序可能和预期不同。 前面说过分数合并规则未确认。尤其是"只命中一边"和"两边都命中"的文档谁排前面,这个顺序在不同合并规则下会不一样。依赖排序就必须实测。
三,别把它当成性能等价物。 多个全文条件 OR,和单个 MATCH 写多个词,语义接近但执行路径未必相同。同字段多词仍建议用单个 MATCH——那走的是 Lucene 最熟悉的路径。
四,升级后老查询的行为不会变。 这条改动是"放开限制",不是"改行为"。以前能跑的查询,升级后结果不变——所以不用担心升级引入回归。这点确认过性质:它是新增能力,不是修改既有行为。
在 9.4.2 上跑一遍
9.0 放开的第一件事——全文函数能进 OR——在 9.4.2 上直接可验,官方首选的写法也一起跑一遍。
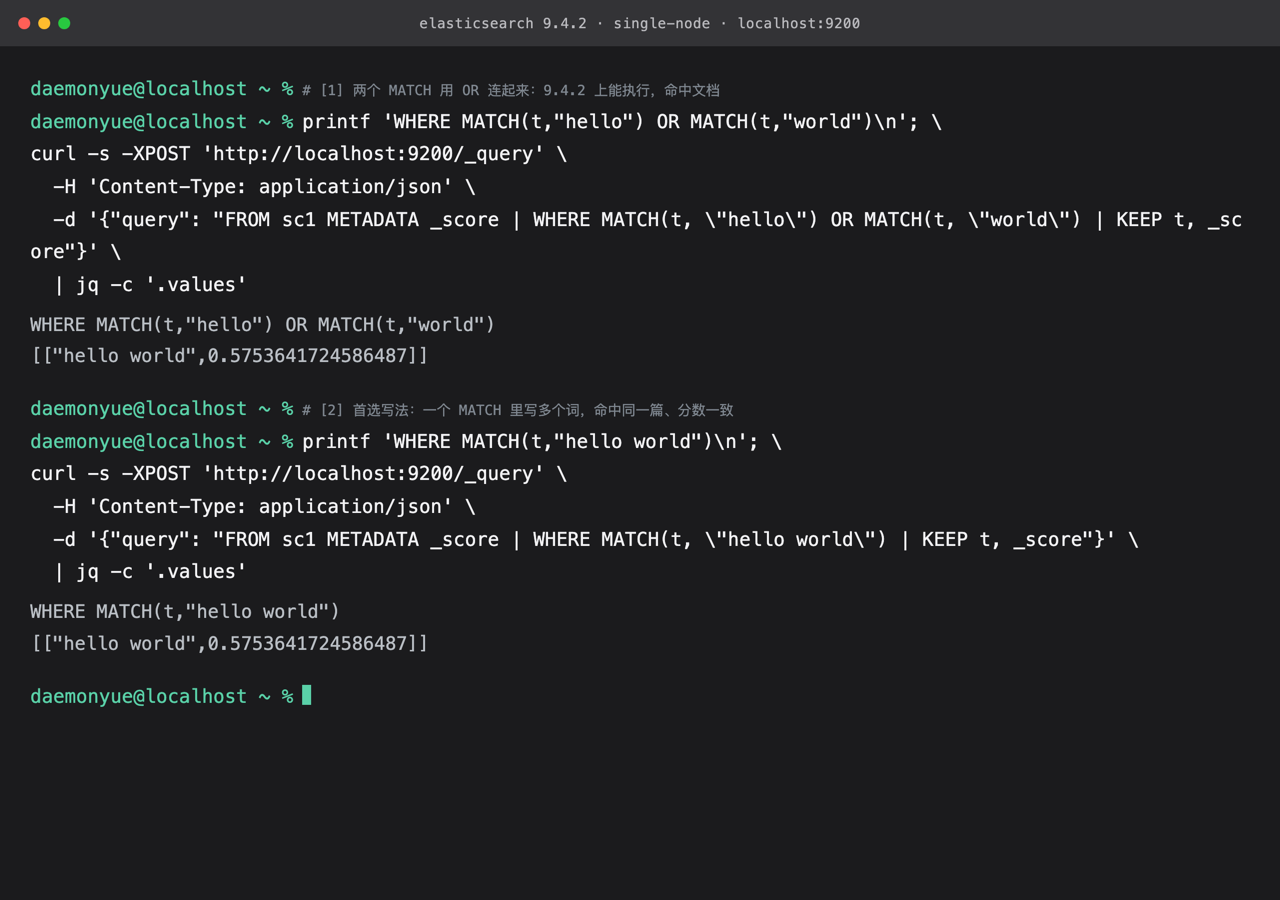
图 4:上:WHERE MATCH(t, "hello") OR MATCH(t, "world") 正常执行,命中 hello world,_score 为 0.5753641724586487。下:换成 WHERE MATCH(t, "hello world"),命中同一篇,分数完全一致。本地实测输出。
curl -s -XPOST '' \
  -H 'Content-Type: application/json' \
  -d '{"query": "FROM sc1 METADATA _score | WHERE MATCH(t, \"hello\") OR MATCH(t, \"world\") | KEEP t, _score"}'
# [["hello world", 0.5753641724586487]]

curl -s -XPOST '' \
  -H 'Content-Type: application/json' \
  -d '{"query": "FROM sc1 METADATA _score | WHERE MATCH(t, \"hello world\") | KEEP t, _score"}'
# [["hello world", 0.5753641724586487]]
这个样本里两种写法连分数都一样,因为文档同时含两个词、每个 MATCH 各贡献一份。也就是说「放开 OR」带来的主要是写法自由,不是新的算分方式。9.0 之前第一种写法会在校验阶段被拒,本机没有对应版本二进制,那一层没有做运行期对照。
结论是同字段多词仍然优先写成一个 MATCH:一次全文函数调用、一条查询条件,比拆成两个 OR 分支更短,也省掉分支数量带来的执行开销(这部分本文没有从源码确认,见边界)。我的建议是把 OR 留给「不同字段、不同语义条件」的组合,同字段的多个词一律合并进一个 MATCH,这样查询意图一眼能看出来。
边界:
- 图 4 出自 9.4.2 单节点实例,只有一篇文档且两个词都命中,分数相等是这个样本下的结果;
- 9.0 之前「写进 OR 会报错」来自 changelog 与 capability 开关,本地没有旧版本可跑;
- 分数合并规则、分支数量对性能的影响没有从源码确认,也没有实测。
写在最后
这条改动让 ES|QL 的全文检索能力完整了一块:MATCH 之类的函数现在能进 OR 了。
一,9.0 之前全文函数不能出现在 OR 里,9.0 放开。 放开语法和补上打分是两条独立条目,别当成一件事。
二,放开是分两步的:先允许使用,再补上打分。源码里两个 capability 的注释反映了这一点(这一步的先后顺序是推断)。
三,能写不等于该这么写。 我的默认做法是:同字段多词先用一个 MATCH,OR 留给跨字段或混合类型的组合。老版本上遇到限制,多数情况也是这一个办法就能绕过去。
另外诚实标注了四处:"为什么以前不行"是推断;两个 capability 的前后顺序与切换时机未查证;分数合并的具体规则未从源码确认;示例查询未执行。
参考
- changelog 9.0.0:Allow full text functions disjunctions for non-full text functions(第 1585–1588 行)@ v9.4.2
- changelog 9.0.0:Add scoring for full text functions disjunctions(第 2023 行)@ v9.4.2
EsqlCapabilities.java:两个 capability 及注释(第 1019–1022 行、第 1039–1042 行)@ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。"以前为什么禁止"与"两个 capability 是先后两阶段"均为推断,官方未解释设计动机与顺序;执行路径的具体归属、分数合并规则、分支数量对性能的影响仍未从源码确认或实测;「在 9.4.2 上跑一遍」里的两条查询已在本机单节点实例上实际执行(OR 与单 MATCH 的命中、分数均已实测,见该节)。

- 点赞
- 收藏
- 关注作者
评论(0)