ES|QL 终于有视图了,常用查询可以变成一个虚拟索引
ES 9.4 给 ES|QL 加了 Views:把一段查询定义成有名字的视图,之后在
FROM里当索引用。本文讲清定义方式、嵌套与分支上限、预览阶段的限制,以及它和子查询、FORK怎么选。
说明
实测环境:本地另起一个 Elasticsearch 9.4.2 单节点实例(官方 tar 包,端口 9200,独立 path.data),安全特性与机器学习均关闭;实验产生的索引与视图都在这台实例上。文末「在 9.4.2 上跑一遍」里的命令与响应均取自该实例。
反复出现的那几段查询
写 ES|QL 的时候,总有几段查询会反复出现:固定的过滤条件、固定的字段重命名、固定的派生字段。以前要么每次复制粘贴,要么在应用层封一层。
9.4 加进来的 ES|QL Views,给了一个更直接的办法:把这段查询定义成一个有名字的视图,之后在 FROM 里当索引用。
先把状态说清楚,免得你看完就想往生产上放:9.4 技术预览,而且 serverless 不可用。官方 esql-views.md 文档头部写的是 stack: preview 9.4.0、serverless: unavailable(v9.5.4 文档 4–5 行)。
它到底是什么
先看官方是怎么定义的(12–17 行):
A view is a virtual index with fields that are produced from the output of an ES|QL query.
Each view has a name and a definition. The definition is a complete ES|QL query, with source commands and processing commands.
The view name can be used within an index pattern in theFROMcommand of any normal ES|QL query, as well as within another view definition.
When the main query is executed, all referenced views are also executed independently.
This ensures up-to-date results from all source indexes referenced by both the main query and the view definitions themselves.
The final output combines all these results into a single list, including any duplicate rows.
拆开看有五点:
- 视图是个虚拟索引,字段来自一条 ES|QL 查询的输出。
- 它有名字和定义,定义就是一条完整的 ES|QL 查询(source 命令 + 处理命令都有)。
- 这个名字可以用在任何查询的
FROM索引模式里,也可以被另一个视图引用。 - 主查询执行时,被引用的视图会各自独立执行,所以拿到的是源索引的最新数据,不是缓存快照。
- 结果合并成一个列表,重复行会保留,不会帮你去重。
官方列的四种适用场景
官方列了四种场景(19–26 行),翻过来就是:
- 复用一段命名查询:把常用的管道包成视图,之后按名字引用,不用每个请求都重复一遍。
- 抽象通用转换:把重命名、类型转换、派生字段集中在一个地方,用的人只看到一组稳定的列,不用关心底层结构。
- 组合多个预处理过的数据源:一个源定义一个视图,各自带自己的过滤或聚合,然后在一条
FROM里一起查。 - 给下游工具减负:看板、告警、临时分析的人直接查
FROM my_view,不用知道背后是哪些索引、哪些命令。
第三条最实用——以前要在一个查询里合并几个口径不同的数据源,只能写很长的管道或者在应用层拼。
怎么定义,怎么用
用 REST API 定义。假设有这样一条查询(这是官方示例,views_plain_addresses):
FROM addresses
| RENAME city.country.name AS country
| EVAL country = CASE(country == "United States of America", "United States", country)
| STATS count=COUNT BY country
结果是:
| count:long | country:keyword |
|---|---|
| 1 | Japan |
| 1 | Netherlands |
| 1 | United States |
把它定义成视图(42–52 行):
PUT /_query/view/country_addresses
{
    "query": """
        FROM addresses
        | RENAME city.country.name AS country
        | EVAL country = CASE(country == "United States of America", "United States", country)
        | STATS count=COUNT BY country
        """
}
然后直接查视图名,输出跟上面那条查询一模一样(views_country_addresses 示例):
FROM country_addresses
用起来就跟普通索引一样。官方说法是(63–68 行):FROM 后面是逗号分隔的索引或视图名列表,支持通配符和 date-math。
几个要注意的行为:
- 一边有、另一边没有的字段,会填
null(77 行)。 - 视图可以嵌套,深度上限 10(82 行)。
- 分支因子上限 8,而且 views、subqueries、
FORK是共用这个额度的(86–88 行)。官方举的例子:一个索引模式里引用 4 个视图 + 4 个子查询可以,再多一个就超限,查询直接失败。
进阶一点的用法
一个 FROM 里合并多个视图。 官方示例定义了三个视图 country_airports、country_addresses、country_languages,分别从三个源索引统计每个国家的文档数,然后一起查(99–112 行)。同一个国家会在多个视图里都出现,于是产生多行;想要合并就再套一层 STATS ... SUM(count) BY country。通配符也能用,比如把所有 country_* 视图一次性查出来再做 SUM。
视图里可以写 LOOKUP JOIN。 这个挺实用:
PUT /_query/view/airports_mp_filtered
{
    "query": """
        FROM airports
        | RENAME abbrev AS code
        | LOOKUP JOIN airports_mp ON abbrev == code
        | WHERE abbrev IS NOT NULL
        | DROP code
       """
}
这个视图里的行,都是 airports 里能在 airports_mp 索引匹配到 abbrev 的那些(125–139 行)。官方还举了个用法:把视图和索引写进同一个 FROM,对比"只在 airports 里的"和"在视图里的"各有多少。
限制,这部分要认真看
视图在预览阶段,限制不算少(官方限制片段):
- 视图定义里基本不能用
FORK和子查询,除非分支点能通过 query compaction 合并掉。 - 嵌套和分支可以组合,但分支点不能超过一个。视图里可以有子查询,但该视图就不能再和其他视图一起用了。
- 跨集群:不支持远端视图。
FROM cluster:view只会去匹配远端的同名索引;如果远端真有个视图,查询会失败。反过来,如果远端有个索引跟本地视图同名,查询也会失败。 - 查询参数不能用在视图定义里,所以主查询传的参数不会影响视图结果。
- 已知问题:主查询上的 Query DSL 过滤,目前会作用到视图定义里的源索引上,后续版本会改成作用于视图的输出——这个行为变化要留意。
METADATA在视图内外的行为也还会变。
,跨集群和参数这两块,现阶段基本别指望。
视图、子查询、FORK 怎么选
这三个是近亲,官方专门做了对比(对比片段)。用一句话区分:
FORK:对同一份已有数据做并行多分支处理,每个分支拿到的输入行和列都一样;一个查询只能有一个FORK。- 子查询:每个分支可以有自己的
FROM,来源可以完全不同。 - 视图:可复用的命名查询,当虚拟索引用。
它们的共同点也很明确:都是查询时才执行(所以结果是最新的)、列取并集(缺的填 null)、最大分支数都是 8、一般不允许嵌套分支(视图能通过 compaction 绕一部分)。
还有两条容易忽略:
- 视图名在索引命名空间里唯一,不能和已有索引同名,反过来也一样。
- 视图可以嵌套,但不能循环引用(
viewA→viewB→viewC→viewA不行),循环是在主查询执行时才检测的。
| 项 | 结论 |
|---|---|
| 版本 | 9.4 起,技术预览 |
| Serverless | 不可用 |
| 定义方式 | PUT /_query/view/<name>,body 里是完整 ES |
| 用法 | FROM 里当索引用,支持通配符和 date-math |
| 结果 | 各视图独立执行后合并,重复行保留,缺列填 null |
| 嵌套深度 | 10 |
| 分支上限 | 8(views + subqueries + FORK 共用) |
| 主要限制 | 视图内一般不能用 FORK/子查询;不支持远端视图;不能用查询参数 |
在 9.4.2 上跑一遍
视图的 REST 路径、嵌套、字段补齐这几条,用三条文档就能全验一遍。
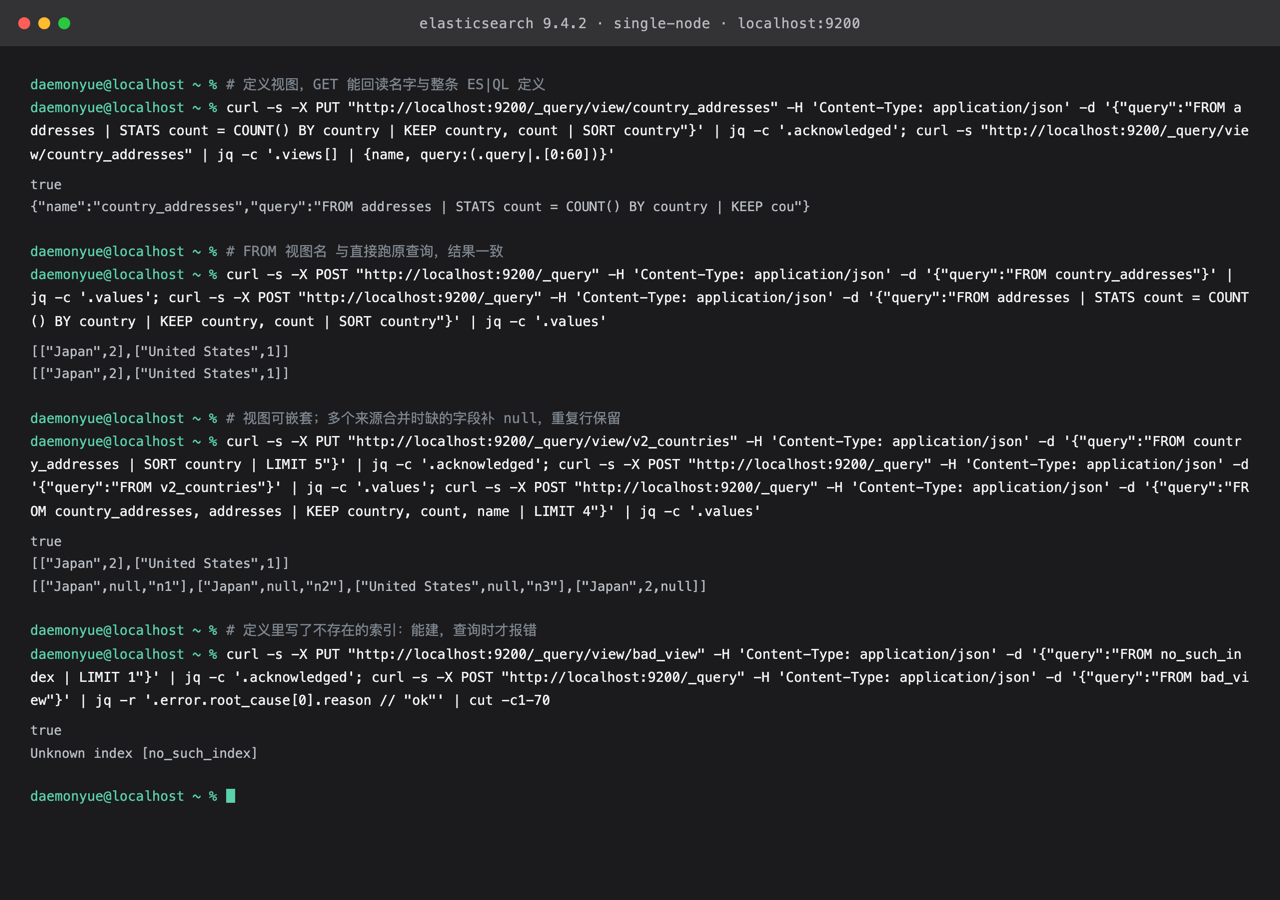
图 1:9.4.2 单节点实例的实测输出。PUT /_query/view/country_addresses 定义成功、GET 能回读定义;FROM country_addresses 与直接跑原查询的结果一致 [["Japan",2],["United States",1]];嵌套视图 v2_countries 可用;FROM country_addresses, addresses 里缺的字段补 null、重复行保留;定义引用不存在的索引能建,查询时才报 Unknown index。
curl -s -X PUT '' \
  -H 'Content-Type: application/json' \
  -d '{"query":"FROM addresses | STATS count = COUNT BY country | KEEP country, count | SORT country"}' \
  | jq -c '.acknowledged'
# true
curl -s '' \
  | jq -c '.views[] | {name, query:(.query|.[0:60])}'
# {"name":"country_addresses","query":"FROM addresses | STATS count = COUNT BY country | KEEP cou"}
curl -s -X POST '' -H 'Content-Type: application/json' \
  -d '{"query":"FROM country_addresses"}' | jq -c '.values'
# [["Japan",2],["United States",1]]
curl -s -X PUT '' \
  -H 'Content-Type: application/json' \
  -d '{"query":"FROM country_addresses | SORT country | LIMIT 5"}' >/dev/null
curl -s -X POST '' -H 'Content-Type: application/json' \
  -d '{"query":"FROM v2_countries"}' | jq -c '.values'
# [["Japan",2],["United States",1]]
curl -s -X POST '' -H 'Content-Type: application/json' \
  -d '{"query":"FROM country_addresses, addresses | KEEP country, count, name | LIMIT 4"}' \
  | jq -c '.values'
# [["Japan",null,"n1"],["Japan",null,"n2"],["United States",null,"n3"],["Japan",2,null]]
curl -s -X PUT '' \
  -H 'Content-Type: application/json' -d '{"query":"FROM no_such_index | LIMIT 1"}' >/dev/null
curl -s -X POST '' -H 'Content-Type: application/json' \
  -d '{"query":"FROM bad_view"}' | jq -r '.error.root_cause[0].reason'
# Unknown index [no_such_index]
图 1 把正文几条说法落到了实测:FROM 里直接写视图名能跑、结果与原查询逐行一致;视图可嵌套;合并多个来源时缺失字段补 null、重复行不去重。另有一条正文没写:定义阶段不校验源索引是否存在,写错了要到查询时才报 Unknown index。
边界:
- 图 1 出自 9.4.2 单节点实例,3 条文档、两层嵌套;正文提到的深度上限 10、分支因子 8 未构造到边界;
- 技术预览功能,本机 9.4.2 可用,其它版本与 serverless 未核对;
- 视图定义的持久化与权限控制未测。
写在最后
视图解决的是一个很朴素的问题:同一段 ES|QL 别再到处复制。如果看板、告警里反复出现同一段查询,值得把它抽成视图试一下,尤其是"把几个口径不同的数据源合到一条 FROM 里"这种场景,视图会比手写长管道清爽得多。
但要记住它还是技术预览:跨集群和查询参数这两块现在基本用不了,嵌套深度、分支数也有上限。先在测试环境和内部看板上试,别急着把核心告警迁过来。
参考
- ES|QL Views 官方文档 @ v9.5.4
- 视图限制片段 @ v9.5.4
- 视图 / 子查询 / FORK 对比 @ v9.5.4
- 9.4.0 发布说明 highlights @ v9.5.0
本文对照 Elasticsearch
v9.5.4标签的官方文档与v9.5.0标签的发布说明核对,示例均取自官方示例文件。「在 9.4.2 上跑一遍」里已实际创建、回读、嵌套并查询视图:FROM 视图名与原查询结果逐行一致,多来源合并时缺失字段补null、重复行保留,坏定义到查询时才报Unknown index。深度上限 10、分支因子 8 未构造到边界;视图定义的持久化与权限控制未测。

- 点赞
- 收藏
- 关注作者
评论(0)