ES|QL 一条查询拿到整体分和子条件分,靠 SCORE()
9.3 把
SCORE函数放进了正式构建。它作用于单个全文函数(比如match),返回那个条件的分数。配合METADATA _score,可以在一条查询里同时拿到整体分和子条件分——这在排查"为什么这条排这么靠前"时很有用。
说明
实测环境:本地起的 Elasticsearch 9.4.2 单节点实例(官方 tar 包直接跑,堆内存 512MB,安全与机器学习关闭),curl 连本地 9200 端口,_query 接口走 ES|QL;测试文档在实验时现场写入。图 1 出自这个实例。
官方条目
9.3 的 changelog 标为 feature(9.3.0.yml 第 471–474 行 @ v9.4.2):
summary: Enable score function in release builds
area: ES|QL
type: feature
一行 summary,没 details。但函数本身有文档,下面按文档核。
函数做什么
官方描述(functions/description/score.md @ v9.4.2):
Scores an expression. Only full text functions will be scored. Returns scores for all the resulting docs.
三句拆开:
- 给一个表达式打分——不是给整个查询打分;
- 只有全文函数会被打分——
match、qstr这类;其它表达式没有分数概念; - 返回所有结果文档的分数。
官方示例(functions/examples/score.md @ v9.4.2):
FROM books METADATA _score
| WHERE match(title, "Return") AND match(author, "Tolkien")
| EVAL first_score = score(match(title, "Return"))
这个例子信息量不小:
FROM books METADATA _score——要显式声明_score元数据才能拿到整体分;WHERE里有两个match条件;EVAL first_score = score(match(title, "Return"))——只给其中一个条件打分。
SCORE 和 _score 是两回事
这是最该说清楚的一点,两者容易混:
_score |
SCORE |
|
|---|---|---|
| 是什么 | 元数据列 | 函数 |
| 怎么拿到 | FROM ... METADATA _score |
EVAL x = SCORE(...) |
| 表示什么 | 整个查询的综合得分 | 某个全文函数的得分 |
_score 是所有条件合起来的最终分;SCORE 是拆开看——某一个条件贡献了多少分。
用上面那个例子说:
_score=match(title)+match(author)综合后的分;first_score= 只有match(title)这一项的分。
这个区别决定了它们的用途不同:_score 用来排序,SCORE 用来分析。
它解决什么问题
最大的用途是排查相关性。
检索结果排序不符合预期时,常见的问题是:"为什么这条排这么靠前/靠后?"要回答这个,就得知道每个条件各贡献了多少分。
以前在 ES|QL 里做不到——你只能看到最终的 _score,看不出它是怎么来的。SCORE 让你能把组合条件拆开逐个看。
具体做法是把每个条件的分数都算出来:
FROM books METADATA _score
| WHERE match(title, "Return") AND match(author, "Tolkien")
| EVAL title_score = score(match(title, "Return"))
| EVAL author_score = score(match(author, "Tolkien"))
| KEEP title, author, _score, title_score, author_score
| SORT _score DESC
| LIMIT 10
这样能直接看出:某条文档排第一,是因为标题匹配得分高,还是作者匹配得分高。有了这个拆解,"为什么这条排在前面"就不再是猜测——能看到每个条件的具体贡献,调权重时也有依据。
判断这个能力在调优查询时价值最大——比如你怀疑某个条件权重过大或者过小,用它能量化确认,而不是靠猜。
(说明:上面这段查询按官方示例的写法扩展,未实测。SCORE 是否支持在 EVAL 里多次调用、多个 SCORE 能否共存,建议先跑一次确认。)
"只给全文函数打分"这个限制
描述里那句 Only full text functions will be scored 是硬限制,值得展开。
能打分的:match、qstr 这类全文检索函数。它们背后是 Lucene 的评分机制(TF-IDF / BM25 之类),本来就有分数概念。
不能打分的:其它表达式。比如:
WHERE status == "active"——精确匹配,没有"相关度"这个概念;WHERE price > 100——范围过滤,同样没有分数;- 非全文的字符串函数。
这个限制是合理的——评分是全文检索特有的概念。精确匹配要么匹配要么不匹配,谈不上"多相关"。
但它带来一个使用上的注意点:如果你的查询里既有 match 又有过滤条件,那 SCORE 只能用在 match 那部分。想给过滤条件"打分"是没有意义的——它们不参与相关性计算,自然也没有分可拿。
从另一个角度说这也解释了为什么 _score 只受全文条件影响:过滤条件只决定"在不在结果里",不影响"排多前"。理解这一点对看懂 SCORE 的输出有帮助。
写这段时想到一个容易犯的错:有人可能想用 SCORE 给整个 WHERE 打分,比如 SCORE(match(...) AND status == "x")。按描述里的限制,这应该不行——它接受的是一个全文函数,不是任意表达式。不过这点未实测,不确定是报错还是只算 match 那部分。
一个拿不准的用法边界
用 SCORE 时有个未确认的点:它能否作用于没出现在 WHERE 里的全文函数。
比如这样:
FROM books METADATA _score
| WHERE match(title, "Return")
| EVAL other = score(match(author, "Tolkien"))
这里 match(author, "Tolkien") 只出现在 EVAL 里,不参与过滤。
两种可能:
- 能算——
SCORE独立计算这个条件的分数,相当于"另外看看另一条如果不作为过滤条件会得多少分"; - 不能——要求被打分的函数必须已经在查询里参与了过滤。
倾向是前者(函数描述没说要求参与过滤),但未实测。这个用法如果能成立,价值不小——可以在不改变结果集的前提下评估"另一个条件的相关性如何"。
需要用的话先跑一次确认。这也是写这类新函数时的做法:文档没写清的边界,用一次实测代替猜测。
分数能比较吗
另一个值得想的问题:不同 SCORE 结果之间能直接比较吗?
比如 title_score 是 2.3,author_score 是 1.8,能说"标题条件贡献更大"吗?
判断是要谨慎。原因是:
- 两个
match作用在不同字段上,字段本身的特性(长度、词频分布)会影响分数绝对值; - Lucene 的评分和字段的统计信息相关,不同字段的分数量级未必可比。
所以建议是:在同一个查询里横向比较同一条件在不同文档上的分数(这个是安全的),而跨字段比较不同条件的分数要小心。
后者更适合的做法是看相对关系——比如"这条文档的标题分明显高于其它文档",而不是"标题分比作者分高"。
(说明:这段按 Lucene 评分机制的一般理解写的,未在文档里找到明确说明。如果你要做精细的相关性调优,建议参考官方的相关性文档,别只靠这段推断。)
和 Query DSL 的对应关系
如果你熟悉 Query DSL,SCORE 的作用相当于 explain 里每个子查询的分数,或者 function_score 里拆开看各部分的贡献。
Query DSL 有 _explain API 能看到详细的评分拆解,那是排查相关性的标准工具。SCORE 相当于在 ES|QL 里提供了一个轻量版的拆解能力——不如 _explain 详细,但不用换查询语言,写在原查询里就行。
判断是:快速排查用 SCORE,深入分析还是得 _explain。前者胜在方便(同一条查询加一行就能看到拆解),后者胜在信息全(能给出更详细的评分依据)。两者不冲突,按需要的深度选。
一个实际的注意点:性能
SCORE 需要对每个结果文档计算分数。相比只拿 _score,它多了计算量。
具体多多少,文档没说,也未实测。但按机制推断:
- 如果
WHERE里已经有同样的match,那这个条件的分数可能已经算过了,SCORE只是把它取出来——开销小; - 如果
SCORE里的是一个新的全文函数(没出现在WHERE里),那要额外计算——开销取决于数据量。
写这段时倾向是第一种情况居多(通常是给已有的条件打分),但这点未确认。如果你关心性能,建议对比一下加 SCORE 前后的查询耗时——拿自己的数据测一次,比看任何推断都准。
这个对比做法也适用于其它新函数:加之前记一次耗时,加之后再记一次,差值就是它的开销。数据量要够大才有意义,几十条数据看不出差别。
什么情况下不用它
说完用途,也说说没必要用的情况,免得过度使用。
一,只用单一 match 的简单查询。 只有一个条件时,_score 就是这个条件的分数,SCORE 给不出额外信息。
二,结果是按其它字段排序的。 如果你 SORT 的是时间或者某个业务字段,压根不关心相关度,那分数没有意义。
三,生产固定查询里长期保留。 SCORE 是分析工具,不是查询逻辑的一部分。倾向是排查时临时加上,搞清楚之后去掉——留在生产查询里会增加计算量,而那个分数通常没人看。
第三条要强调:分析性的东西不要变成常态。查询里每多一个 EVAL,都要在每次执行时算一遍。排查完就把它们拿掉,保持生产查询干净。
在 9.4.2 上跑一遍
SCORE 吃的是单个全文函数,用一篇同时含 hello 和 world 的文档,能把整体分与子条件分一次拆开。
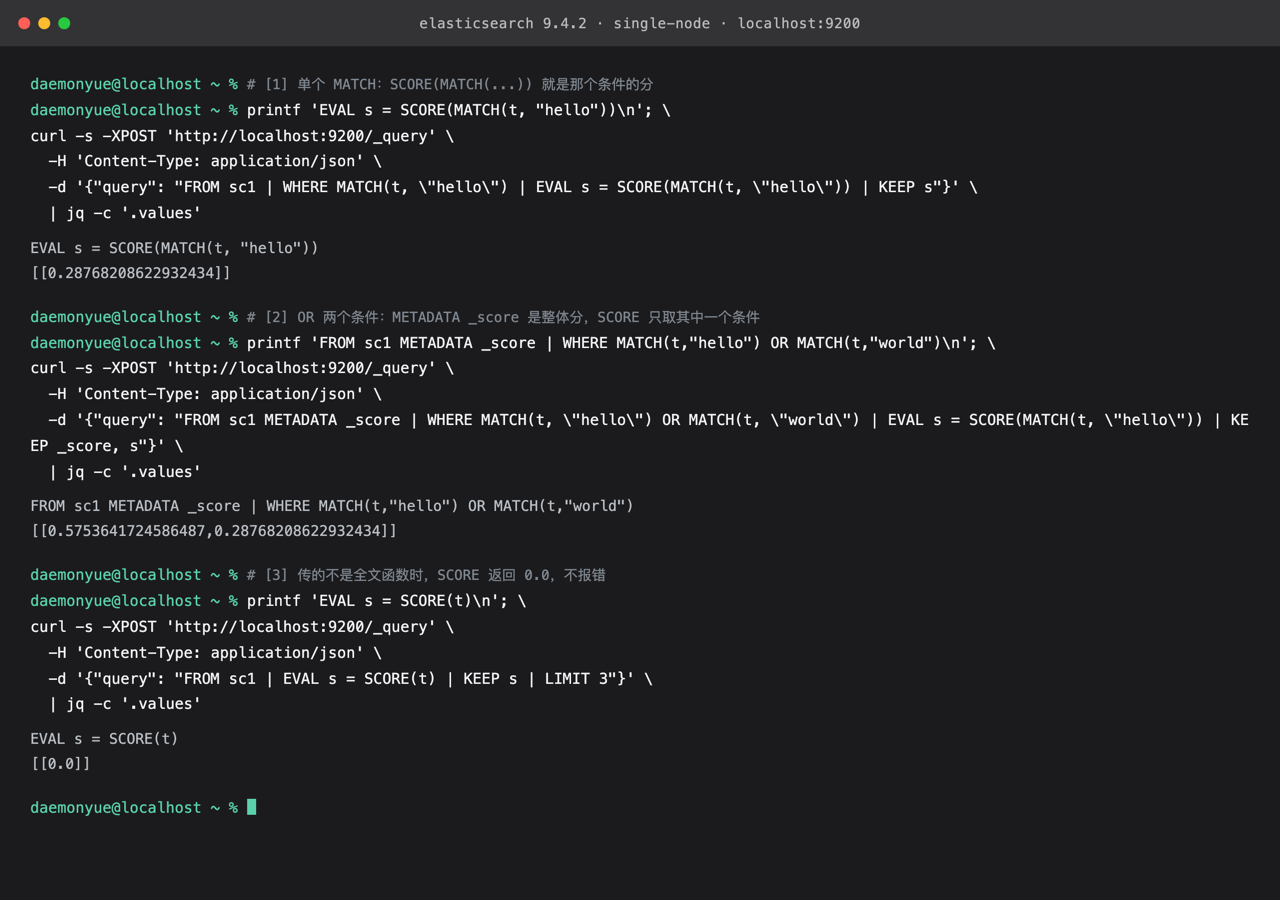
图 1:上:EVAL s = SCORE(MATCH(t, "hello")) 得到 0.28768208622932434。中:METADATA _score 配两个 OR 条件,整体分 0.5753641724586487,而 SCORE(MATCH(t, "hello")) 仍是 0.28768208622932434。下:把字段 t 直接传给 SCORE(t),返回 0.0,不报错。本地实测输出。
curl -s -XPOST '' \
  -H 'Content-Type: application/json' \
  -d '{"query": "FROM sc1 METADATA _score | WHERE MATCH(t, \"hello\") OR MATCH(t, \"world\") | EVAL s = SCORE(MATCH(t, \"hello\")) | KEEP _score, s"}'
# [[0.5753641724586487, 0.28768208622932434]]
两处信息值得记:单条件查询里 SCORE 与 _score 相等(0.28768…);加上第二个 OR 条件后 _score 变成两倍,而 SCORE 仍只报它自己那个条件的分。原文拿不准的「SCORE 作用于非全文表达式会怎样」,本机也给了答案:SCORE(t) 返回 0.0,不报错、不拒绝——所以别拿它的返回值判断表达式是否合法,静默的 0 分比报错更难发现。
结论是排查「这条为什么排这么前」时,_score 看结果、SCORE 看构成,两者要一起读。我的建议是只在排查期临时加 SCORE 列,别把它固化进业务查询:分数依赖分词、词频与索引状态,换个索引或换批文档数值就变,不适合当稳定字段用。
边界:
- 图 1 出自 9.4.2 单节点实例,索引里只有一篇文档,分数只是这个样本下的值;
- 多个
SCORE共存、以及在EVAL里多次调用没有逐个验; SCORE的性能开销没有测,本文也没有给多条件复杂查询下的表现。
写在最后
这个函数不大,用法也简单,但对排查相关性问题是个实用的补充。
一,SCORE 和 _score 不是一回事。 前者是某个全文函数的分,后者是整个查询的综合分。要用 _score 得显式写 METADATA _score,不写就拿不到这一列。
二,它只能给全文函数打分。 match、qstr 这类可以,精确匹配和范围过滤不行——后者没有"相关度"这个概念。
三,主要用途是分析而非排序。 排序用 _score;想知道"分是怎么来的"才用 SCORE 把条件拆开看。查完记得把它从生产查询里去掉——分析性的 EVAL 不该长期留在那。
最后补一句:SCORE 是在 EVAL 里用的,而它作用在全文函数上。用之前先确认你的查询里那个条件确实是全文函数,否则拿不到有意义的分数——这一步确认花不了几秒,但能避免"拿到了 null 还不知道为什么"的困惑。
参考
- changelog 9.3.0:Enable score function in release builds(第 471–474 行)@ v9.4.2
functions/description/score.md:函数说明(Only full text functions will be scored)@ v9.4.2functions/examples/score.md:官方示例,含METADATA _score用法 @ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 与函数文档核对,引文逐字取自原文。「在 9.4.2 上跑一遍」里的查询已在本机单节点实例上实际执行:单条件分、OR 下的整体分与子条件分、以及SCORE(t)返回 0.0 均已实测(见该节);多个SCORE共存与性能开销仍未验证。

- 点赞
- 收藏
- 关注作者
评论(0)