检索|ES 的 doc_values skippers,让不建索引的字段也能快速过滤
Doc_values skippers 给 doc values 字段加了一层稀疏索引,让
index=false的字段也能高效过滤,不用另外建 BKD 或 terms 索引。TSDB 索引这次直接默认启用了,磁盘占用明显下降。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.3.0.yml),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
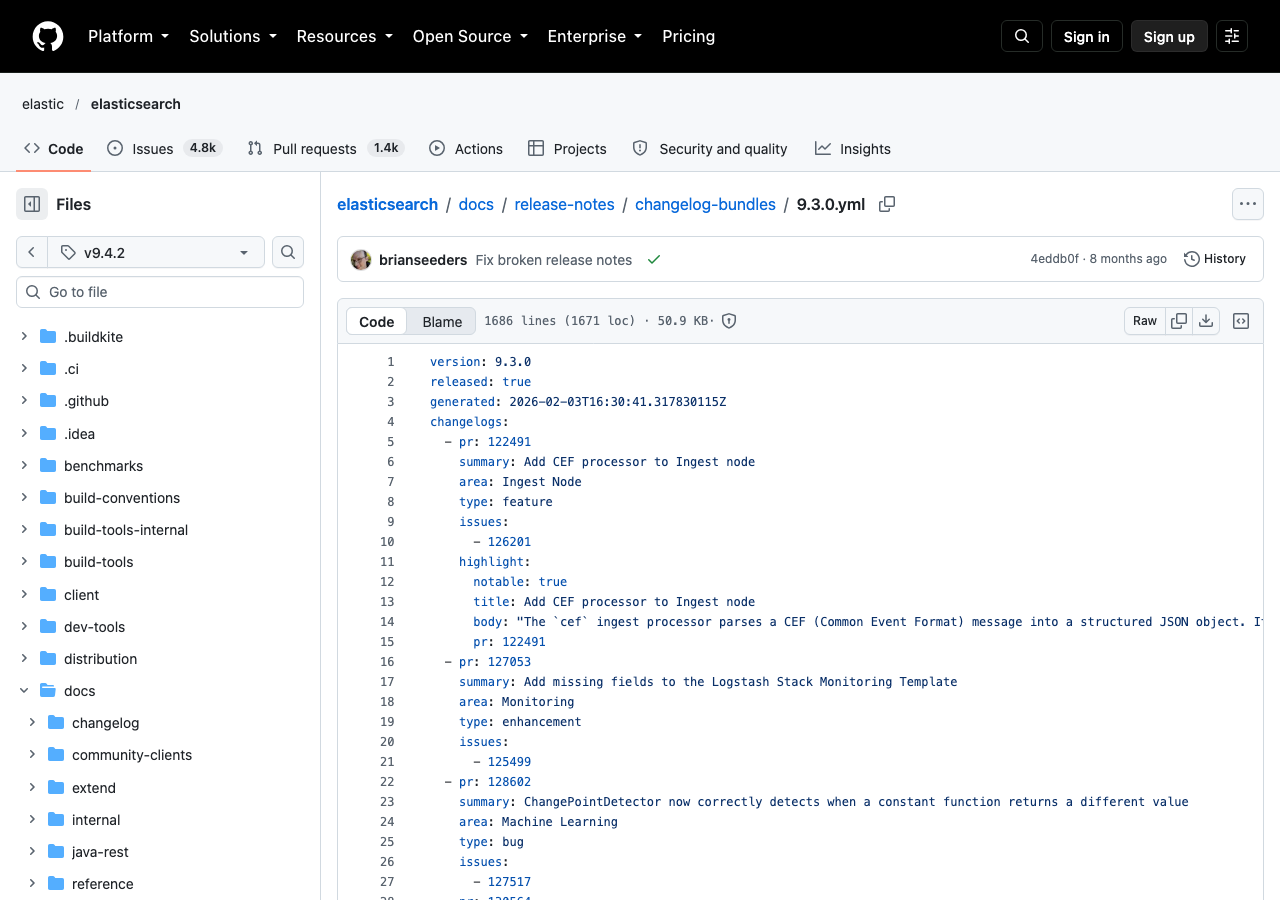
图 1:官方文件 9.3.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.3.0.yml
官方条目
9.3 的 changelog 标为 feature,且带 highlight(notable: true)(9.3.0.yml 第 1140–1156 行 @ v9.4.2),PR 138723。
summary 是 Remove DOC_VALUES_SKIPPER feature flag——它说的是移除特性开关,而 highlight 的标题才是这个能力本身:Enable doc_values skippers。
body 说明了机制和默认值:
Doc_values skippers add a sparse index to doc_values fields, allowing efficient querying and filtering on a field without having to build a separate BKD or terms index. These are now enabled automatically on any field configured with
index=falseanddoc_values=trueif the index settingindex.mapping.use_doc_values_skipperis set totrue(defaultfalse, ortruefor TSDB indexes).
TSDB indexes now default to using skippers in place of indexes for their@timestamp, dimension and_tsidfields, greatly reducing their on-disk footprint. To disable skippers in TSDB indexes, setindex.mapping.use_doc_values_skippertofalse.
先说这个能力解决什么
(它是 9.x 一批存储优化里的其中一条,横向对比见那篇。)
理解它需要知道一个背景:doc values 和索引是两套东西。
- 索引(倒排索引、BKD 树等)——用来快速找到匹配的文档。查询快,但占空间。
- doc values——按列存的值,用来取回字段值做聚合、排序。
一个字段通常两个都建。但有些字段只需要被取回、不需要被快速查找——比如只在聚合里用到的字段。这时可以设 index=false,省掉索引的空间。
代价是:index=false 的字段没法高效过滤——要判断"这个字段 > 100",只能遍历所有文档的 doc values,慢。数据量小的时候感觉不出来,量大了就很明显。
doc_values skippers 解决的正是这个矛盾:给 doc values 加一层稀疏索引,让它既能省掉完整索引的空间,又不用全量遍历。
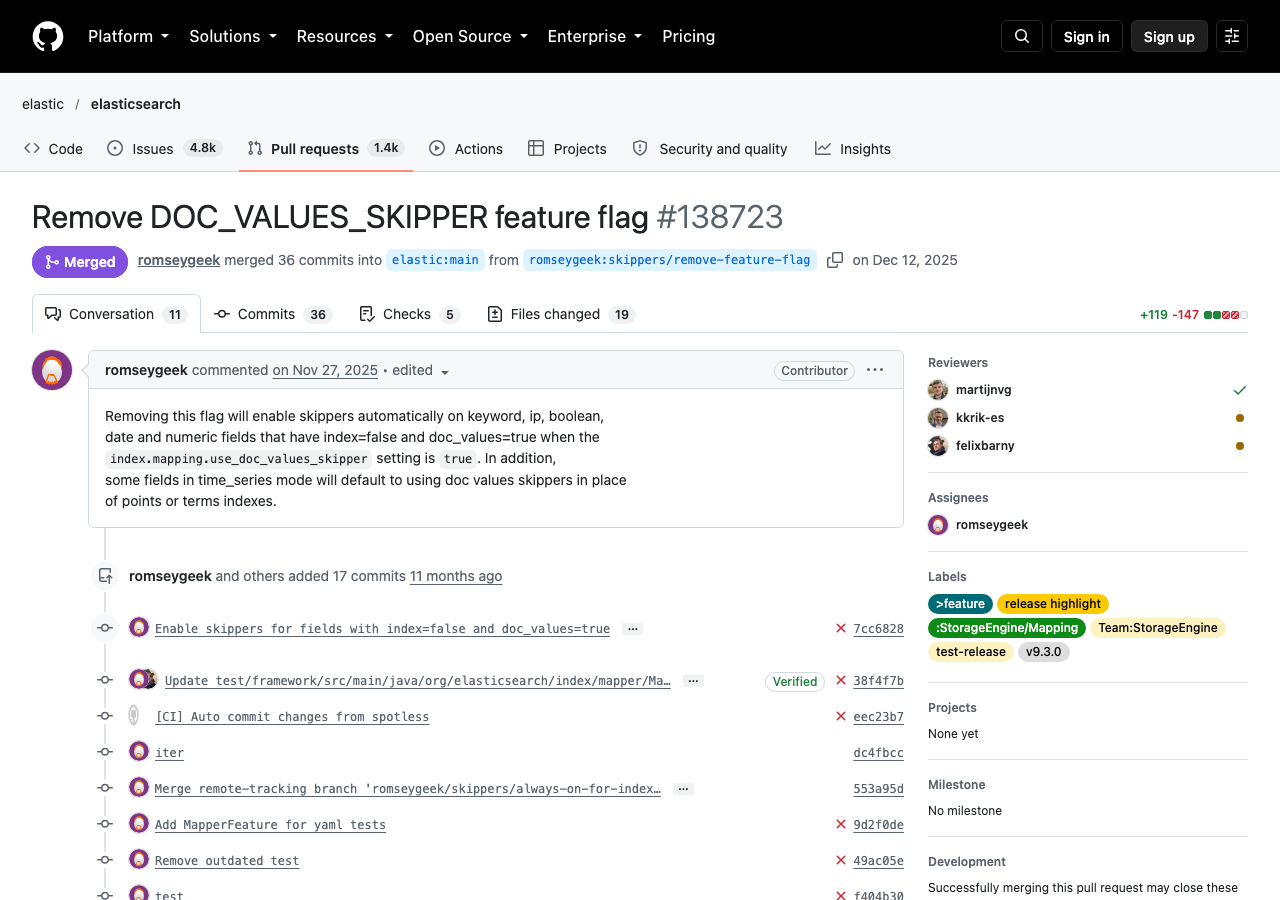
图 2:官方页面 PR #138723。来源:GitHub elastic/elasticsearch pull/138723
为什么"省掉索引"这件事重要
值得展开一下背景,因为它决定了这个特性的价值。
索引很占空间。 倒排索引要记录每个词出现在哪些文档、BKD 树要维护多维结构。对大表来说,索引的体积常常接近甚至超过数据本身。
所以一直有个优化方向:不必要的字段别建索引。
但以前这么做的代价很硬——关掉索引就等于放弃这个字段的过滤能力。要么全量扫(慢),要么别这么查。
skippers 提供了一个中间档:不用建完整索引,但也不至于全量扫。这让"为了省空间关索引"这个选择变得可用得多——以前是省空间和能查询二选一,现在可以两个都要一点。
这才是这个特性的真正意义,比"性能提升多少"更重要:它让一类原本不可行的配置变得可行。
稀疏索引是什么意思
按官方那句 add a sparse index 理解:
它不像倒排索引那样记录每个值的位置,而是记录每隔一段的位置信息(类似"每 1000 个文档记一个锚点")。
查询时可以先跳到锚点附近,只在小范围内扫描,而不是从头扫到尾。
“稀疏"意味着它占的空间远小于完整索引,换来的是"能跳过大部分数据"而不是"精确定位”。所以它是个折中方案,不是一个免费的完整索引——我的判断是:这两者的区别决定了你该在什么场景下用它,别把它当"索引变小还不影响查询"来期待。
(说明:这段关于稀疏索引具体怎么工作是理解,官方只说了 “sparse index” 四个字,没有展开机制。如果你需要精确的实现细节,要去查 Lucene 的相关文档或 PR 138723。)
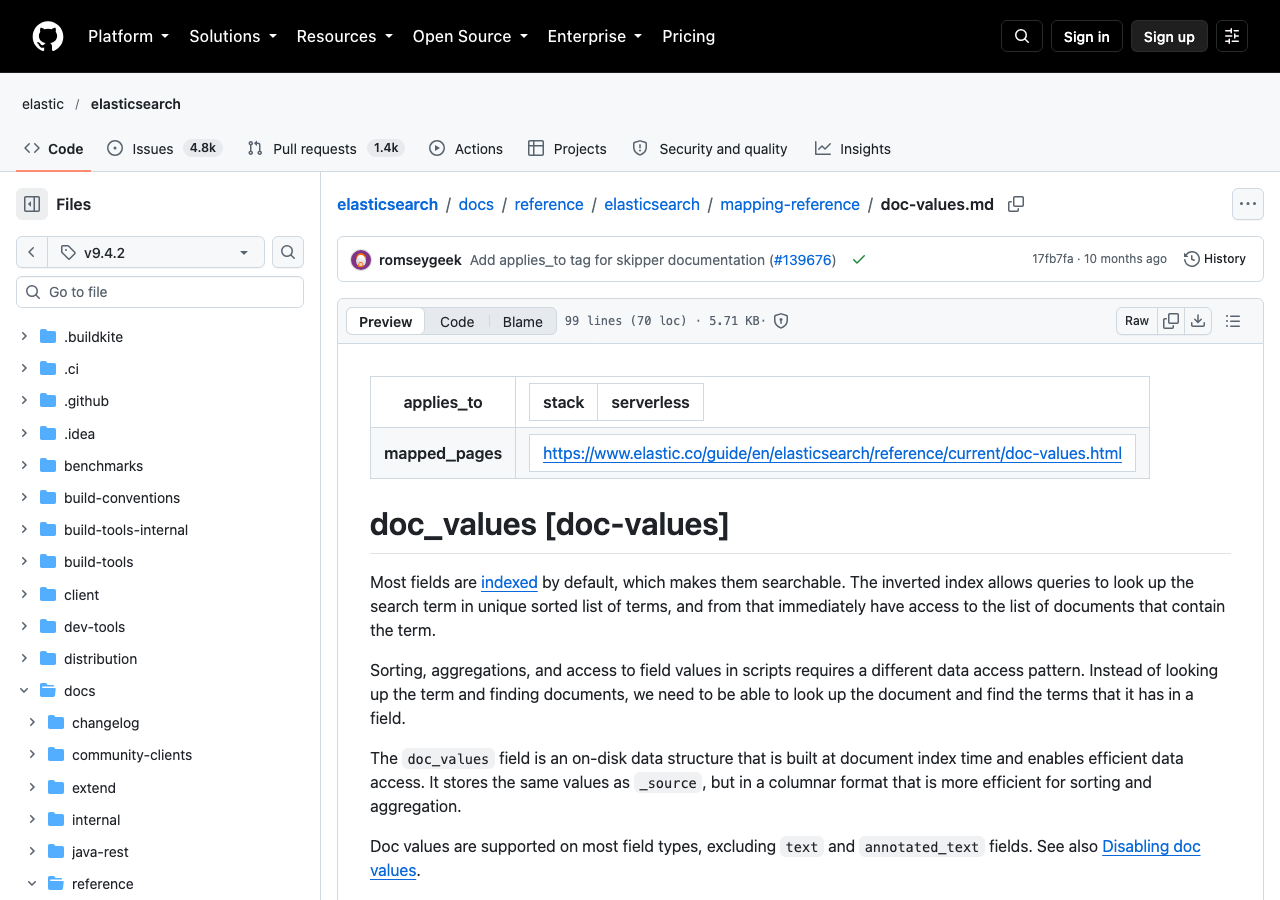
图 3:官方页面 doc-values.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 docs/reference/elasticsearch/mapping-reference/doc-values.md
开启条件
按官方说法,三个条件同时满足才启用:
- 字段配置了
index=false; - 且
doc_values=true; - 且索引设置
index.mapping.use_doc_values_skipper为true。
第 3 条的默认值:
- 普通索引:
false(默认不开); - TSDB 索引:
true(默认开)。
这个区分要留意——同样是这个设置,在不同索引模式下默认行为不同。这和 LogsDB 与 TSDB 取消 norms 里写过的现象一样:索引模式决定了一批默认行为,不看模式就判断默认值会出错。
要注意的是:TSDB 的默认值是 true,意味着 TSDB 索引里符合条件的字段会自动获得 skippers。升级到 9.3 之后,TSDB 用户不用做任何事就会启用这个能力——这是自动的,不是可选的。
TSDB 这次变化最大
官方特别说了 TSDB 的情况:
TSDB indexes now default to using skippers in place of indexes for their
@timestamp, dimension and_tsidfields, greatly reducing their on-disk footprint.
TSDB 索引的 @timestamp、dimension、_tsid 这三个(类)字段,现在默认用 skippers 替代索引。
关键词是 “in place of”——替代,不是"额外加"。也就是说 TSDB 索引里这几个字段不再建原来的索引,改用 skippers。
结果是 “greatly reducing their on-disk footprint”——磁盘占用明显下降。
怎么关掉:把 index.mapping.use_doc_values_skipper 设为 false。
TSDB 用户会直接感受到
按判断,这次变化对 TSDB 用户是自动生效的,而且影响是正面的(省空间)。
但要清楚一件事:这是一个默认行为的改变。虽然官方说是"用 skippers 替代索引"且效果更好,但——
- 磁盘占用会变(下降);
- 这几个字段的查询路径变了(走 skippers 而不是原来的索引)。
理论上性能应该更好或相当(否则官方不会改默认),但没有实测数据。如果你在 TSDB 上有性能敏感的查询,升级后建议比对一下。
普通索引用户:默认 false,什么都不用做,也不会有变化。想用可以显式打开。
什么场景值得手动开
既然普通索引默认不开,那什么情况下值得开?
按官方的能力描述,受益的是这类字段:
- 设了
index=false但要拿来做过滤条件的字段; - 或者聚合用、偶尔过滤的字段。
判断典型场景是:为了省空间关掉了索引,但业务上偶尔要按这个字段筛选。以前这种筛选会很慢(全量扫 doc values),开了 skippers 之后会快很多。
什么时候不需要开:
- 字段本来就有索引 → 不需要,索引已经解决了查找问题;
- 字段只用于聚合/排序、从不用于过滤 → 不需要,skippers 是加速过滤的,对纯取回没帮助。
判断标准就一句:这个字段会不会出现在 WHERE 里。会的才考虑开,不会的开了也没用。
skippers 和完整索引差多少
官方文档里说 skippers 让字段"能高效查询和过滤"。但它和完整索引相比差多少,本文未核实。
按"稀疏索引"的性质推断,它应该比完整索引慢,但比全量扫描快得多——处于两者之间。这是个合理的取舍(用少量空间换大部分性能)。
但未实测,官方也没有给性能对比数据。 所以不要把它当成"等于建了索引"来理解——它是在"不建索引"的前提下提供一个更好的选择,不是替代索引的方案。
决定是否给某个字段开启时,建议是:拿真实数据测一次。开之前记一次查询耗时,开之后再记一次,用数据决定而不是靠推断。这也是本篇多次强调"实测"的原因——这个特性的效果依赖数据分布,通用结论未必适用于你。
和别的"存储优化"放一起看
9.x 在存储效率上投入不少,前面写过几条:
| 条目 | 优化什么 |
|---|---|
| LogsDB 与 TSDB 取消 norms | LogsDB/TSDB 关 norms |
| 本篇 | doc_values 稀疏索引 |
| TSDS 补历史数据 | TSDS 回填开关(不是存储优化,相关) |
共同方向是:在特定模式下,用更省的结构替代通用结构。
这个方向合理——日志和时序数据的访问模式很固定(按时间查、按维度聚合),不需要通用的完整索引。针对模式的优化能省下大量空间。
但也带来 LogsDB 与 TSDB 取消 norms 里提过的顾虑:模式决定了一批默认行为,排查时要先看索引模式。这次的"TSDB 默认开、其它默认关"又是一例。
怎么确认自己的索引是不是 TSDB
既然 TSDB 是这次变化的主要受影响方,给出判断方法。
用 _resolve/index 返回模式 里写过的方式——_resolve/index 会返回索引模式:
curl -s 'localhost:9200/_resolve/index/*?mode=time_series&pretty'
能列出所有 TSDB 模式的索引。空的话说明没在用。
如果确实用了 TSDB,升级到 9.3 之后可以做两件事确认:
# 看磁盘占用变化(升级前后各记一次)
curl -s 'localhost:9200/_cat/indices/<tsdb-index>*?v&h=index,store.size,pri.store.size'

# 看典型查询的耗时
第二个没有标准命令,实际做法是在你的查询监控里对比升级前后的 P99。
建议至少看一眼磁盘占用——官方说会"greatly reducing",这是个可观测的收益,值得确认一下兑现了没有。如果没变化,可能是索引不符合条件(比如字段配置不满足)。
写在最后
这条 feature 对多数人是"不用管"的——普通索引默认不开。
TSDB 用户会直接感受到:升级后磁盘占用下降,但查询路径也变了。这是好事(官方明确说了省空间),但我的建议是升级后确认一下——收益和性能各看一眼,前者验证改动生效,后者确认没有意外。
一,skippers 给 doc values 加稀疏索引,让 index=false 的字段也能高效过滤。 它介于"有索引"和"全量扫描"之间,省空间换性能,是个折中而不是免费的完整索引。
二,普通索引默认 false,TSDB 默认 true。 又是"索引模式决定默认行为"的一例——不看模式就判断默认值会出错。
三,TSDB 的 @timestamp、dimension、_tsid 现在改用 skippers 建索引。 磁盘占用下降,但要留意查询路径变了——省空间是官方明确说的收益,值得升级后确认兑现了没有。
参考
- changelog 9.3.0:Remove DOC_VALUES_SKIPPER feature flag(highlight: Enable doc_values skippers,第 1140–1156 行)@ v9.4.2
- PR 138723
- 相关:同批的
AggregateMetricDouble不建 BKD 索引(PR 138724)@ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 核对,highlight 引文逐字取自原文。"稀疏索引的具体工作机制"是理解,官方只用了 “sparse index” 一词未展开,已标注;"skippers 与完整索引的性能差异"未实测、官方未给对比数据,已在正文说明。撰写时未启动集群、未运行测试。

- 点赞
- 收藏
- 关注作者
评论(0)