ES 的 ILM max_size 弃用,换成主分片大小上限别照搬数值
9.3 起
max_size在 ILM 策略和 rollover 接口里被弃用,官方推荐换成max_primary_shard_size。功能还能用,但会在响应头和服务器日志里产生警告。这条值得留意的原因是:两个条件的判定对象不同,换过去之后触发时机可能变。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.3.0.yml),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
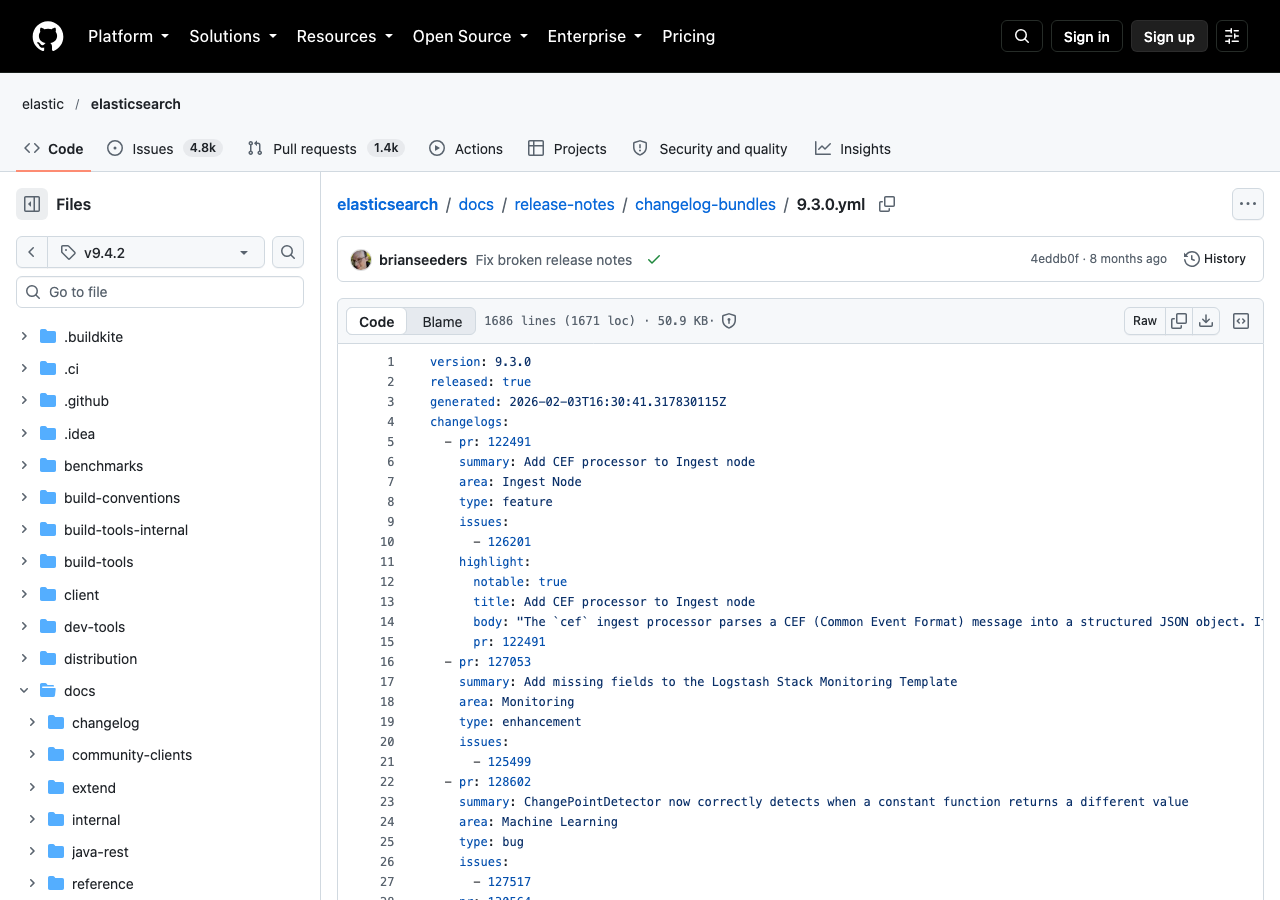
图 1:官方文件 9.3.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.3.0.yml
官方条目
9.3 的 changelog 标为 deprecation(9.3.0.yml 第 130–141 行 @ v9.4.2),area: ILM,关联 issue 130737。
details 说明了范围和替代项:
We have deprecated the
max_sizerollover condition, in favour ofmax_primary_shard_size, when used inPUT /_ilm/policy/{name}andPOST /{index}/_rolloverendpoints
impact 说了当前表现和未来:
Users can continue to use this condition however a warning will be issued via the response headers and in the server logs. The condition may be removed fully in a later version of Elasticsearch.
拆开:
- 弃用范围:
PUT /_ilm/policy/{name}和POST /{index}/_rollover这两个接口里的max_size条件; - 替代项:
max_primary_shard_size; - 当前:仍可使用,但响应头和服务器日志会告警;
- 未来:可能在后续版本被完全移除,届时这个条件就不能用了。
rollover 是什么
先说背景,不然这条改动没有落脚点。
Rollover(滚动) 是日志类索引的标准操作:当当前写入索引达到某个条件时,新建一个索引继续写,旧的转为只读。
常见触发条件有几个:
max_age——达到指定时长;max_docs——达到指定文档数;max_size——达到指定大小;max_primary_shard_size——主分片达到指定大小。
这次弃用的是第三条,推荐换成第四条。
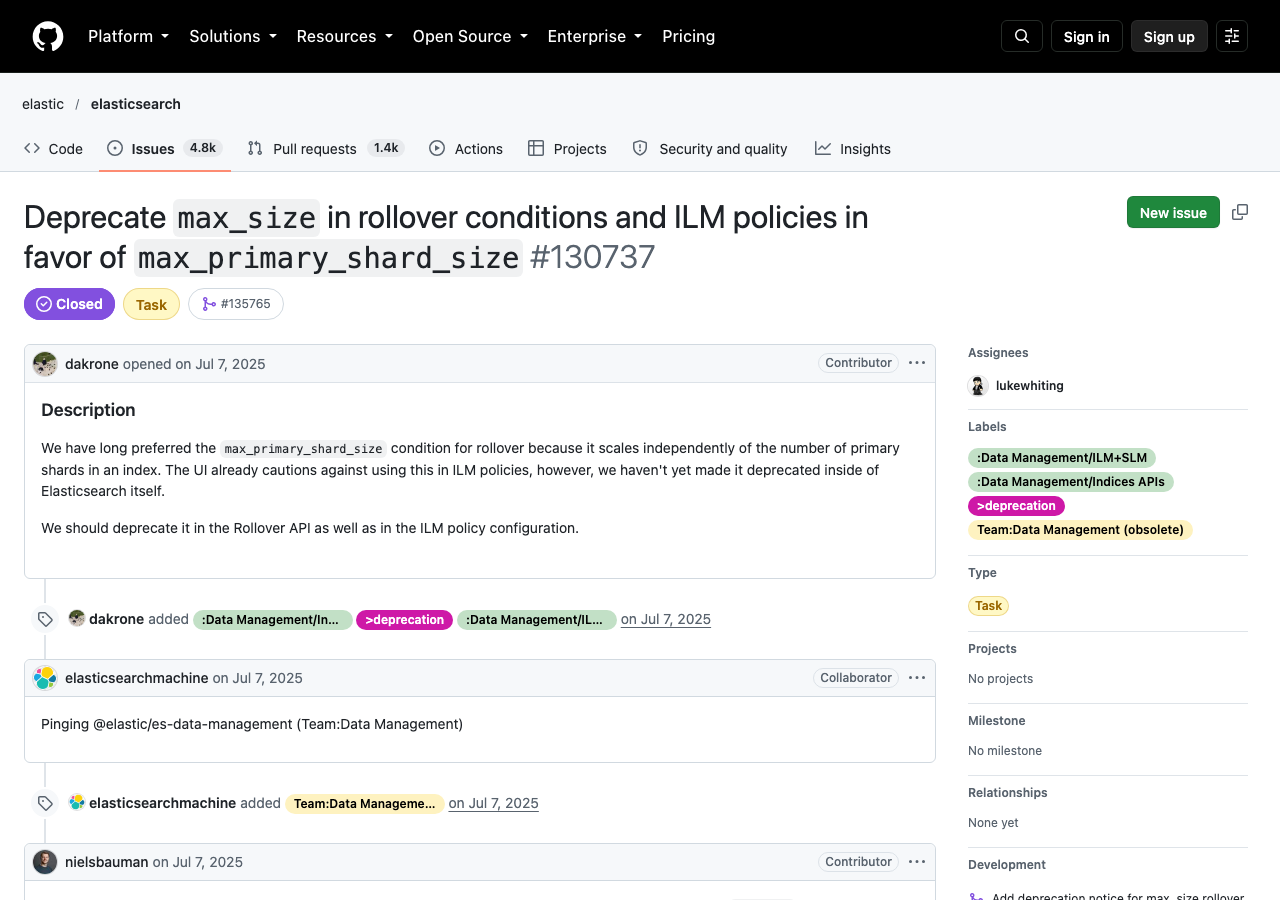
图 2:官方页面 Issue #130737。来源:GitHub elastic/elasticsearch issues/130737
两个条件的区别在哪
这是本篇最该说清楚的部分——它们不是同一个东西。
max_size:按索引的总大小判断。总大小通常包含副本分片。max_primary_shard_size:按主分片的大小判断,不含副本。
这意味着:同样的数值,两者触发时机不同。
举个例子:一个索引有 1 个主分片、1 个副本,那么总大小约等于主分片的 2 倍。设 max_size: 50gb 大约在主分片 25gb 时触发;而设 max_primary_shard_size: 50gb 要等主分片长到 50gb 才触发(此时总大小约 100gb)。
所以迁移时不能直接照抄数值——这一点是本篇最想传达的,也是把它单独写成一篇、而不是在弃用清单里一笔带过的原因。"改个配置名就算迁移完成"的做法,在等价替换时没问题,在这种非等价替换上就会出问题。
(说明:上面这个"约等于 2 倍"的推算依赖副本数,实际关系要看分片配置。未实测,只是说明两者的判定对象不同、数值不可直接照搬。)
为什么官方推荐后者?按理解——主分片大小更能反映"单个分片的健康度"。分片太大对性能和恢复速度都有影响,而控制主分片大小直接针对这一点。总大小受副本数影响,同样的数值在不同副本配置下实际分片大小不同,作为阈值不够精确。
(说明:这段"为什么推荐"是推断,官方 impact 没有解释理由,只说"in favour of"。)
谁会受影响
按判断,影响面中等偏大——比这轮写的其它几条都大,原因很简单:ILM 策略里用 max_size 是很常见的写法。
受影响的:
- ILM 策略里用了
max_size条件的; - 手动调
_rollover时传了max_size的。
当前没有功能影响——还是会照常触发 rollover。只是多了告警。
真正需要处理是在它被移除时(官方说"可能在后续版本")。所以和 Transform 通知索引别名 里总结的一样,这是"知道就行、按计划更新"的一类,不是紧急项。
但有个地方和其它兼容层收口不同:这条的迁移不是纯配置改名,要重新计算数值。所以它需要的准备时间比"改一行配置"长——建议提前做,并且留出观察期。倾向是在下一个主版本升级之前完成,而不是挤在同一次升级窗口里。
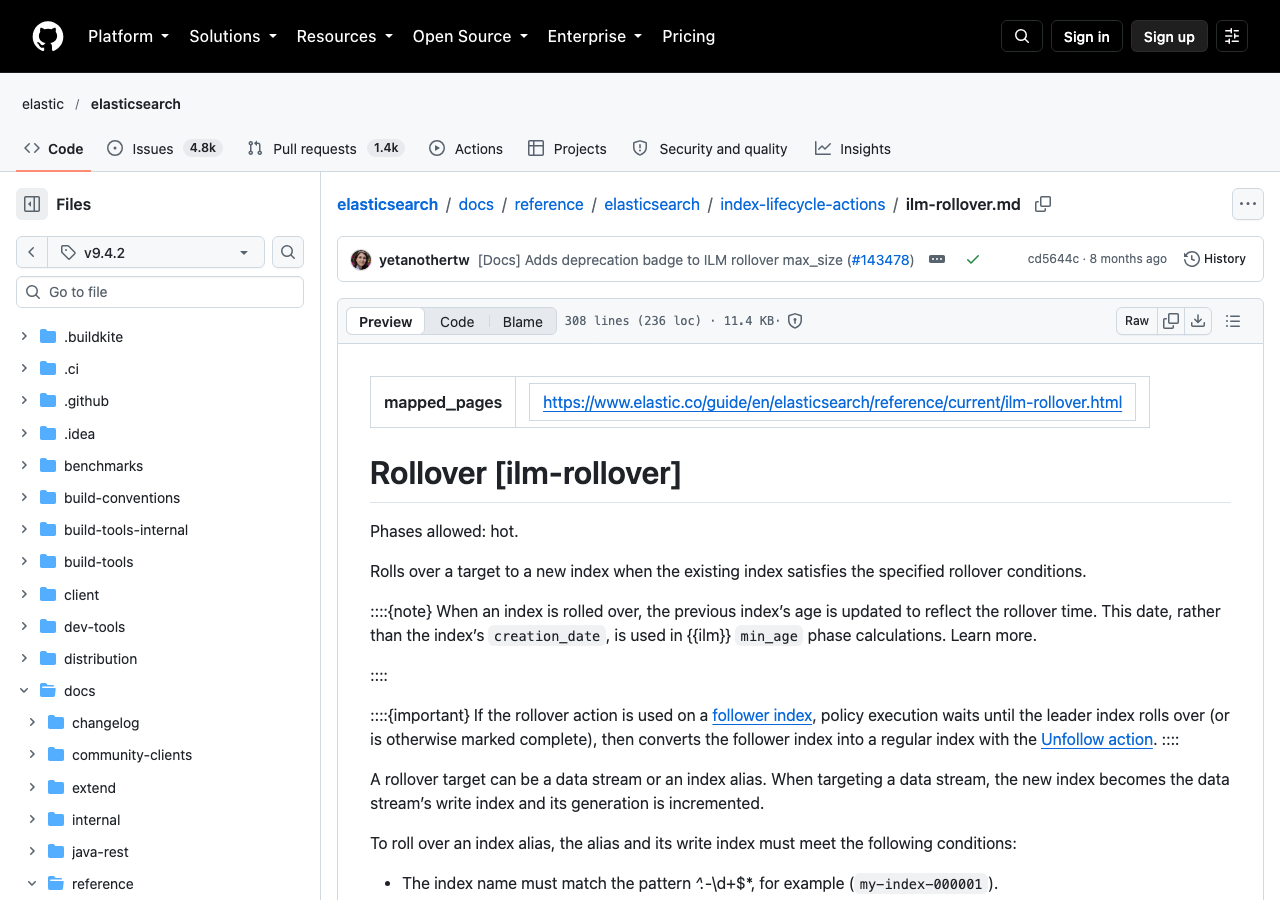
图 3:官方页面 ilm-rollover.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 docs/reference/elasticsearch/index-lifecycle-actions/ilm-rollover.md
迁移要注意什么
一,数值要重新算。 前面说过,两个条件的判定对象不同,不能直接照抄。
做法是先算出当前实际触发时的主分片大小,再以此为基准设 max_primary_shard_size:
# 看当前索引的分片大小和总大小
curl -s 'localhost:9200/_cat/indices/my-index-*?v&h=index,pri,rep,store.size,pri.store.size'
pri.store.size 是主分片大小,store.size 是总大小。看一批索引在 rollover 前的实际值,就能定出新阈值。
二,换过去之后观察一段时间。 换了阈值之后,rollover 的频率会变。要确认新的频率合适——别出现"索引变得太小导致分片数暴涨",或者"太大影响查询性能"。
观察的具体指标看两个:单个索引的大小(是否符合预期)以及分片总数(有没有明显变化)。前者反映阈值是否合适,后者反映集群负担。如果分片总数涨了很多,说明阈值设小了。
怎么找到用了 max_size 的地方
一,看 ILM 策略。 这是最直接的一处,策略定义里写了什么一目了然。
curl -s 'localhost:9200/_ilm/policy?pretty' | grep -B5 -A2 "max_size"
二,看代码里有没有调 _rollover。
grep -rn "max_size" --include=*.py --include=*.go --include=*.json . | grep -i "rollover\|ilm"
三,看服务器日志。 用了会产生警告:
grep -i "max_size" /var/log/elasticsearch/*_deprecation.log | head
三条都做,理由和前面几篇说的一样:代码 grep 只找得到你写的,日志反映实际发生过的。
告警出现在哪
impact 里说了两个位置:
- 响应头(
response headers); - 服务器日志(
server logs)。
响应头这点值得留意——和 Behavioral Analytics 弃用 里说过的一样,只看响应体看不到弃用提示。要检查响应头,或者看服务端日志。
如果你的 ILM 策略是通过索引模板自动生效的(不是每次手动调 API),那响应头这条路径基本用不上——因为没有人在看那个响应。这时候服务器日志是唯一可靠的观测点。
这一点值得强调:ILM 策略通常是配好之后自动跑的,没有人会去看每次执行的响应头。所以别指望靠响应头发现问题,要定期看日志。把 max_size 加进日志监控的关键词里是个省事的做法。
为什么分片大小这件事值得在意
顺着"控制主分片大小"再说一层,因为这关系到为什么要有 rollover 阈值。
分片太大有什么问题:
- 恢复慢。节点故障后要重新分配分片,分片越大拷贝越久;
- 迁移慢。做 rebalance 或者节点下线时同样受分片大小影响;
- 查询性能。单个分片过大时,某些查询模式的效率会下降。
所以控制分片大小是运维可恢复性,不是洁癖的问题。
从这个角度看,为什么按主分片算更合理:
- 恢复的代价由主分片决定——副本可以从主分片本地重建,真正要跨网络传输的是主分片的数据量;
- 总大小受副本数影响,而副本数是可以随时调整的。用一个会变的量做阈值,阈值本身就不稳定。
这个理由是推断(官方没解释),但它能解释为什么推荐后者——用一个更直接反映运维代价的指标做阈值。
分片大小的一般经验值
既然说到控制分片大小,提一下经验范围(这是行业通行的经验,不是 ES 官方文档的数值):
- 日志类索引的单分片通常在 10–50 GB 量级;
- 搜索类可能更大些。
超过这个范围不一定有问题,但恢复和迁移会变慢。具体多少合适取决于你的硬件和容忍的恢复时间。
建议是按恢复时间反推:算一下"一个分片要多久能恢复完",如果这个时间不能接受,就把分片控制得更小。这比照抄一个数字靠谱——因为恢复速度取决于你的磁盘和网络,别人的经验值未必适用。
顺着这个思路,本次的阈值设置也就有了依据:你希望 rollover 后的索引有多大,取决于这个大小在故障时需要多久恢复。把这个问题回答了,max_primary_shard_size 该填多少自然就清楚了。
(说明:这段经验值范围是按通用实践写的,未在 v9.4.2 文档里核实。ES 对分片大小的建议要看你版本的官方文档。)
和别的"给了替代项"的弃用放一起看
9.x 写过好几条弃用,按有没有替代项分过类:
| 条目 | 替代项 | 迁移性质 |
|---|---|---|
| force_source 移除 | 无 | 删配置 |
| 远程集群证书认证弃用 | API key 模式 | 换认证方式 |
| 本篇 | max_primary_shard_size |
换条件 + 调数值 |
本篇属于"有替代项,但替代项不是等价替换"——这是比前两种更容易出错的一类。前两种照着改就行,这一种要动脑算,而且算错了不会立刻暴露。
因为等价替换照抄就行(改个配置名),而非等价替换要重新计算。如果你把 max_size: 50gb 直接改成 max_primary_shard_size: 50gb,rollover 行为会明显变化,而这种变化不会报错——只是索引变大、分片变少,可能很久之后才被发现。
所以建议是:换的时候明确算一次数值,并且换完观察一段时间。 不要把它当成一次普通的"配置改名"来处理——这两类迁移的准备时间不是一回事,前者几分钟,后者要跨几个 rollover 周期才能确认。
rollover 条件可以组合
值得说一句:rollover 条件是可以同时配多个的,不是只能用一个。
常见的组合是"大小 + 时长":
{
  "actions": {
    "rollover": {
      "max_primary_shard_size": "50gb",
      "max_age": "30d"
    }
  }
}
任意一个条件满足就触发。这样既避免分片过大,也避免"数据少时索引永远不滚动"(那样会导致单个索引存活过久)。
倾向是推荐组合使用,因为只靠大小的话,低峰期可能很久不滚动;只靠时长的话,高峰期可能产生过大的分片。两个一起配能互相兜底。
本次改动只涉及大小那一项,时长那项(max_age)不受影响——所以如果你的策略里两个都配了,只需要改大小那一个。
写在最后
这条 deprecation 当前不影响功能,但影响面比这轮写的其它几条大——ILM 里用 max_size 是很常见的写法。
我的判断是:写它的核心理由就是那句警告——两个条件的判定对象不同,数值不能直接照搬,换了参数要重新定阈值。
一,替代项是 max_primary_shard_size,它按主分片算、不含副本。 直接照抄 max_size 的数值会让 rollover 时机明显变化——索引会变得更大才滚动。这个变化不会报错,只是行为悄悄变了。
二,换之前先算一遍数值。 用 _cat/indices 的 pri.store.size 看当前 rollover 前的实际主分片大小,以此为基准,而不是照抄老阈值。
三,换完观察一段时间。 rollover 频率会变,要确认新的索引大小和分片数量都在预期内。这类变化不报错,只看配置发现不了。
四,当前只是告警,不用紧急处理。 但这类"有替代项但非等价"的迁移要留足时间验证,别等到移除前才做——移除之后就没有"先观察"的机会了。
参考
- changelog 9.3.0:Add deprecation notice for
max_sizerollover condition(第 130–141 行)@ v9.4.2 - Elasticsearch issue 130737
本文对照 Elasticsearch
v9.4.2标签的 changelog 核对,引文逐字取自原文。关于两个条件判定对象差异的具体倍数关系(含副本时的换算)本文未实测,正文已说明为推算;"官方为何推荐 max_primary_shard_size"是推断,impact 未解释理由,已标注。撰写时未启动集群、未运行测试,文中命令按官方接口结构给出,未实际执行。

- 点赞
- 收藏
- 关注作者
评论(0)