考古|深分页在 ES 2.1 起被限到 10000,scan 也被 scroll 取代
2.1 里两件事一起发生:
scan这种 search type 被废弃,改成"按_doc排序的 scroll";同时from + size超过index.max_result_window(默认 10000)时直接报错,不再静默返回。前者是写法替换,后者是会让老代码失败的行为变更。
说明
来源和边界先交代:本文的依据出自 v2.4.6 标签下的官方文件(migrate_2_1.asciidoc、DefaultSearchContext.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
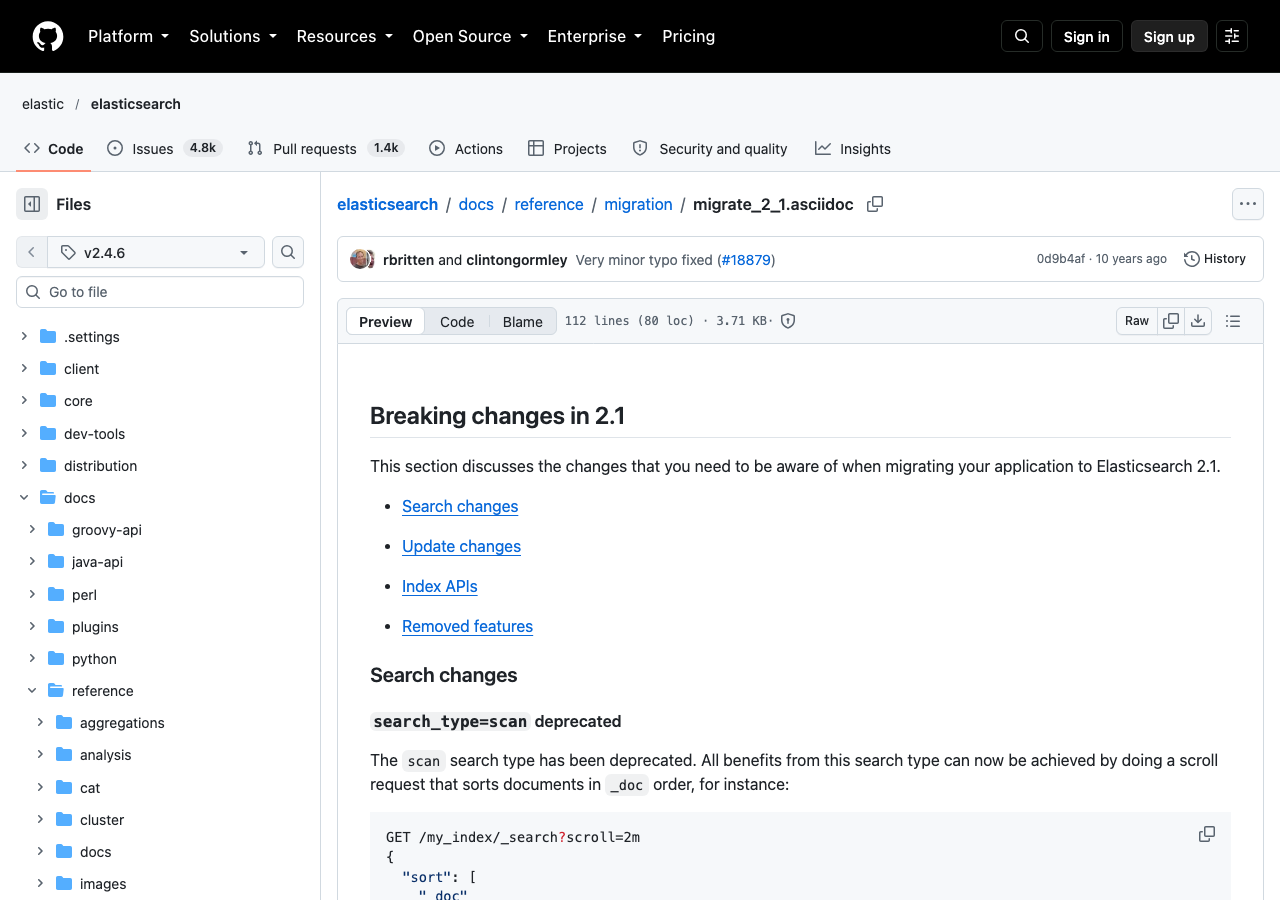
图 1:官方文件 migrate_2_1.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 migrate_2_1.asciidoc
这两件事其实是同一件事
2.1 的这一节把"废弃 scan"和"给 from+size 加上限"放在一起,两件事针对的都是深度遍历数据。这是对迁移文档的归纳,文档本身没有这样写。
区别只在于方向:
scan的替代方案是"想全量遍历就用 scroll",把这条路做顺、做到和 scan 一样的效率;max_result_window是把"用 from/size 硬翻到底"这条路堵上,因为它会把节点堆内存吃光。
两条里会让老代码失败的是第二条。第一条只是写法过时(scan 还能用,只是废弃),第二条是行为变更:以前深分页请求会一直处理,2.1 起超过上限直接返回错误。“能跑"变成"直接失败”,业务方看到的是接口报错,所以排查时它排在前面。
所以我的建议是先看有没有深分页调用,再改 scan 的写法,后者在废弃阶段还能用。
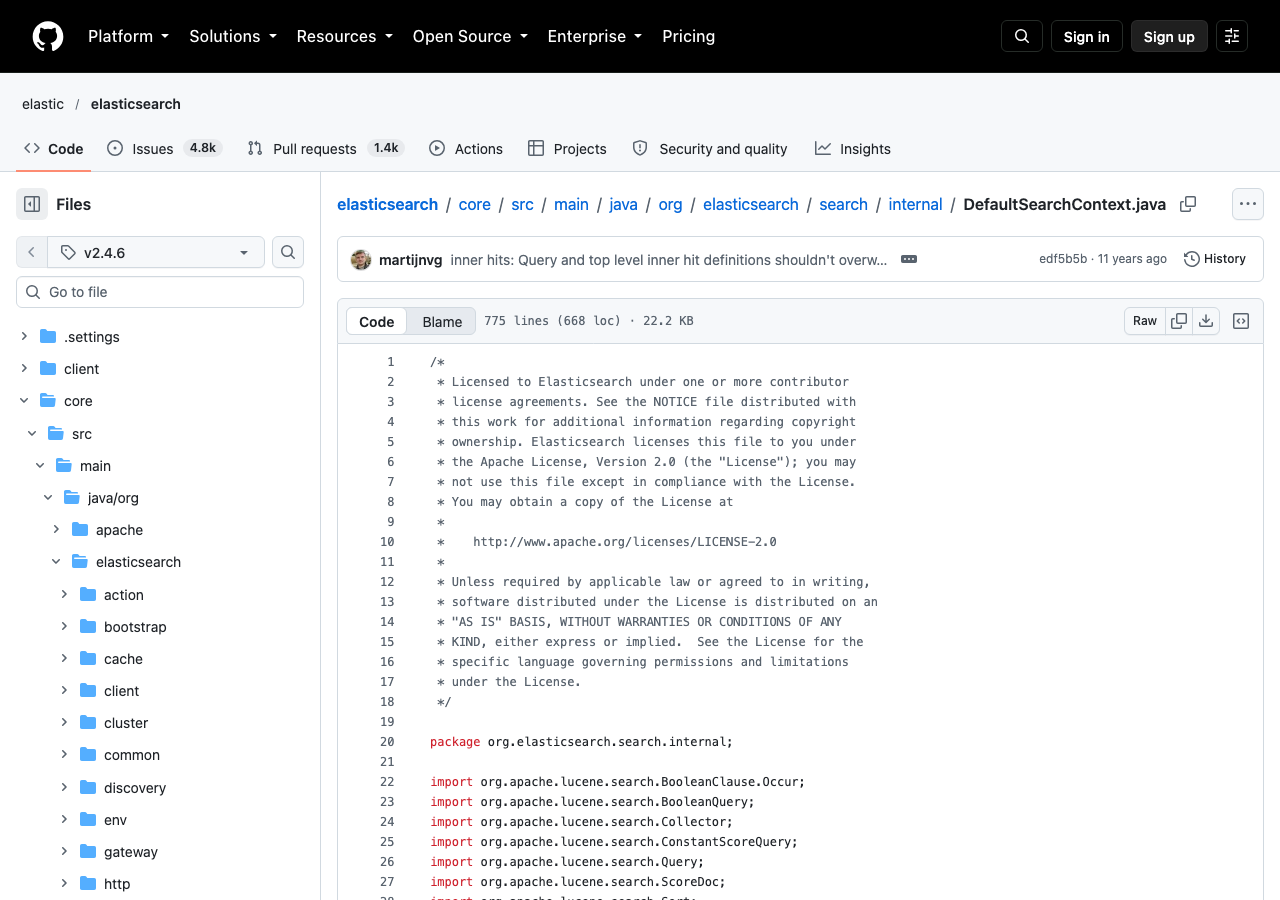
图 2:官方文件 DefaultSearchContext.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 DefaultSearchContext.java
search_type=scan 废弃
2.1 迁移文档(migrate_2_1.asciidoc @ v2.4.6)的说明:
The
scansearch type has been deprecated. All benefits from this search type can now be achieved by doing a scroll request that sorts documents in_docorder.
替代写法:
GET /my_index/_search?scroll=2m
{
  "sort": [
    "_doc"
  ]
}
官方补了一句性能上的保证:
Scroll requests sorted by
_dochave been optimized to more efficiently resume from where the previous request stopped, so this will have the same performance characteristics as the formerscansearch type.
也就是说,替代方案的性能特征与 scan 相同,不是用 scroll 将就。
scan 是一种特殊的 search type,请求要带 search_type=scan&scroll=...。按 scan 的设计,首个响应只返回 _scroll_id,需要再发 scroll 请求才拿得到数据,这是本文的理解,没有在 2.x 上实跑核对。若如此,改成 _doc 排序的 scroll 后,首个响应就是正常的搜索响应,客户端不用再处理"第一个响应没有数据"这个分支,迁移时可以删掉。
同一节里 search_type=count 也再次被标记废弃(2.0 已经说过一次),替代写法是 size: 0:
GET my_index/_search
{
  "aggs": {...},
  "size": 0
}
from + size 的上限
这是 2.1 里会让老代码失败的行为变更:
Elasticsearch will now return an error message if a query’s
from+sizeis more than theindex.max_result_windowparameter. This parameter defaults to 10,000 which is safe for almost all clusters.
在此之前,深分页请求不受这个限制。2.1 起超过阈值直接返回错误,默认值 10000,见 DefaultSearchContext 第 95 行。
为什么要限制:文档说,超过这个值会在每次搜索、每个分片上占用大量堆内存。机制上,每个分片都要先取出并排序 from + size 条,协调节点再合并这些结果,所以分页越深,单次请求占的内存越多,并发一多就会给节点造成压力。
文档给的建议很明确:
It’s safest to leave this value as it is and use the scroll api for any deep scrolling but this setting is dynamic so it can raised or lowered as needed.
index.max_result_window 是动态设置,可以调,但官方建议别调,深翻页改用 scroll。
图 3:官方页面 api-conventions.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 docs/reference/api-conventions.asciidoc
遇到这个错误怎么办
错误信息见 DefaultSearchContext 第 213–217 行,开头是 Result window is too large, from + size must be less than or equal to: [10000],后面还提示去看 scroll API,以及这个限制由索引级参数 index.max_result_window 设置。处理路径按场景分:
导出或遍历全量数据:不建议用 from/size 翻页,用按 _doc 排序的 scroll,也就是上面替代 scan 的写法。
产品上的"跳到第 N 页":先确认真有这个需求。如果访问日志里深页请求来自爬虫或循环写错,可以在应用层限制最大页码。确实要支持,2.x 里没有 search_after:在 v2.4.6 源码里搜过,它在 2.x 不存在,要到后续版本才引入。2.x 上要么限制页码,要么用 scroll 配合应用层缓存,要么调大 index.max_result_window 并接受相应的堆内存代价。
确实需要放宽阈值:动态调大 index.max_result_window:
PUT my_index/_settings
{
  "index.max_result_window": 50000
}
调之前先估算代价:窗口越大,每个分片的排序缓冲和协调节点的合并缓冲越大,一个深分页请求占的堆内存也越多。调完要观察节点堆使用和 GC。
这笔内存账怎么算
文档只说深分页会占堆内存,没给量级。下面按它的机制给一个估算方法,用来判断自己的集群能不能承受:协调节点要合并的结果约为 分片数 × (from + size) 条。假设索引有 5 个分片,请求是 from=9990, size=10:
5 个分片 × (9990 + 10) = 50000 条
为了返回 10 条数据,协调节点要合并约 5 万条的排序信息,这还只是一个请求;10 个并发就是 50 万条。每个分片本地还要各自排出前 1 万条,开销也按这个量级。
判断方法是把 分片数 × (from + size) 乘以并发数,看数量级能不能接受。这个公式来自机制推导,没有实测,每条结果实际占多少内存取决于排序字段和文档大小。
压垮集群的通常是循环写错的客户端,正常业务分页很少到这个量级:for (page=0; ; page++) 没有终止条件的话,from 会一路增大。有了 10000 的硬上限,这类请求第一次越界就会报错。我的建议是这个默认值不要动。
一份能跑通的全量遍历示例
文档只说"改用按 _doc 排序的 scroll",没给完整流程。下面补一个三段式的版本,没有在 2.x 上实跑,请先在测试环境验证:
# 1) 初始化:拿到第一批和 _scroll_id
curl -s -XGET 'localhost:9200/my_index/_search?scroll=5m&size=1000' -d '{
  "sort": ["_doc"],
  "query": { "match_all": {} }
}' > /tmp/p1.json

# 2) 续读:取下一批,直到 hits 为空;每次响应都会返回新的 _scroll_id,下一次要用最新的
SCROLL_ID=$(python3 -c "import json;print(json.load(open('/tmp/p1.json'))['_scroll_id'])")
curl -s -XGET "localhost:9200/_search/scroll?scroll=5m&scroll_id=$SCROLL_ID" > /tmp/p2.json

# 3) 用完清理:scroll 上下文占资源,不清理要等超时
curl -s -XDELETE "localhost:9200/_search/scroll" -d "{\"scroll_id\":[\"$SCROLL_ID\"]}"
第 2 步里,scroll 文档的说明是每次请求都会返回新的 _scroll_id,只有最新的那个有效,所以循环里要更新变量,不能一直用第一次拿到的 id。第 3 步要强调的是:scroll 上下文是服务端资源,不清理就要等超时才释放。遍历结束后立刻清理,用 try/finally 包住,异常路径也要清。
迁移检查(附排查命令)
# 找 scan 用法
grep -rn "search_type.*scan\|searchType.*scan" . | head -20

# 找深分页:from 大于几千的都要逐个看
grep -rn "\"from\"\|from=\|\.from(" --include=*.py --include=*.java --include=*.js . | head -30
- 搜
search_type=scan,改成sort: ["_doc"]的 scroll,并去掉"第一个响应为空"的客户端分支; - 搜分页逻辑,算一下最大
from + size会不会超过 10000; - 检查有没有依赖"深分页不会报错"的批量任务,这类任务升级 2.1 后会直接失败,而不是慢一点。
写在最后
全量遍历用 scroll(_doc 排序),不要用 from/size 翻到底。index.max_result_window 能调,但它是保护阈值,调大只是把出问题的时间往后推,深分页的需求本身应该换个做法。文档说默认值对"几乎所有集群"是安全的,同意这个判断,需要超过 10000 的分页多半是用法问题。
index.max_result_window 是索引级设置。要改的话,想清楚是只改当前索引,还是用索引模板批量改,只改当前索引的话,新建的索引仍是 10000。
文中命令按 2.x 的接口写的,跨版本使用前请用实际版本的手册核对一次。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。

- 点赞
- 收藏
- 关注作者
评论(0)