考古|升到 ES 2.0 后搜索结果结构变了,partial fields 和 count 要改
2.0 迁移文档的 Search changes 一节,单条看都不大,但升级后容易造成结果结构不一致:partial fields 被删除改用 source filtering;
search_type=count废弃,改用size=0;count API 内部变成 search API,失败时从"返回 count=0"变成抛异常;stored 元字段默认返回且移到顶层;另外require_field_match默认值改变会让高亮静默消失。
说明
来源和边界先交代:本文的依据出自 v2.4.6 标签下的官方文件(search.asciidoc),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
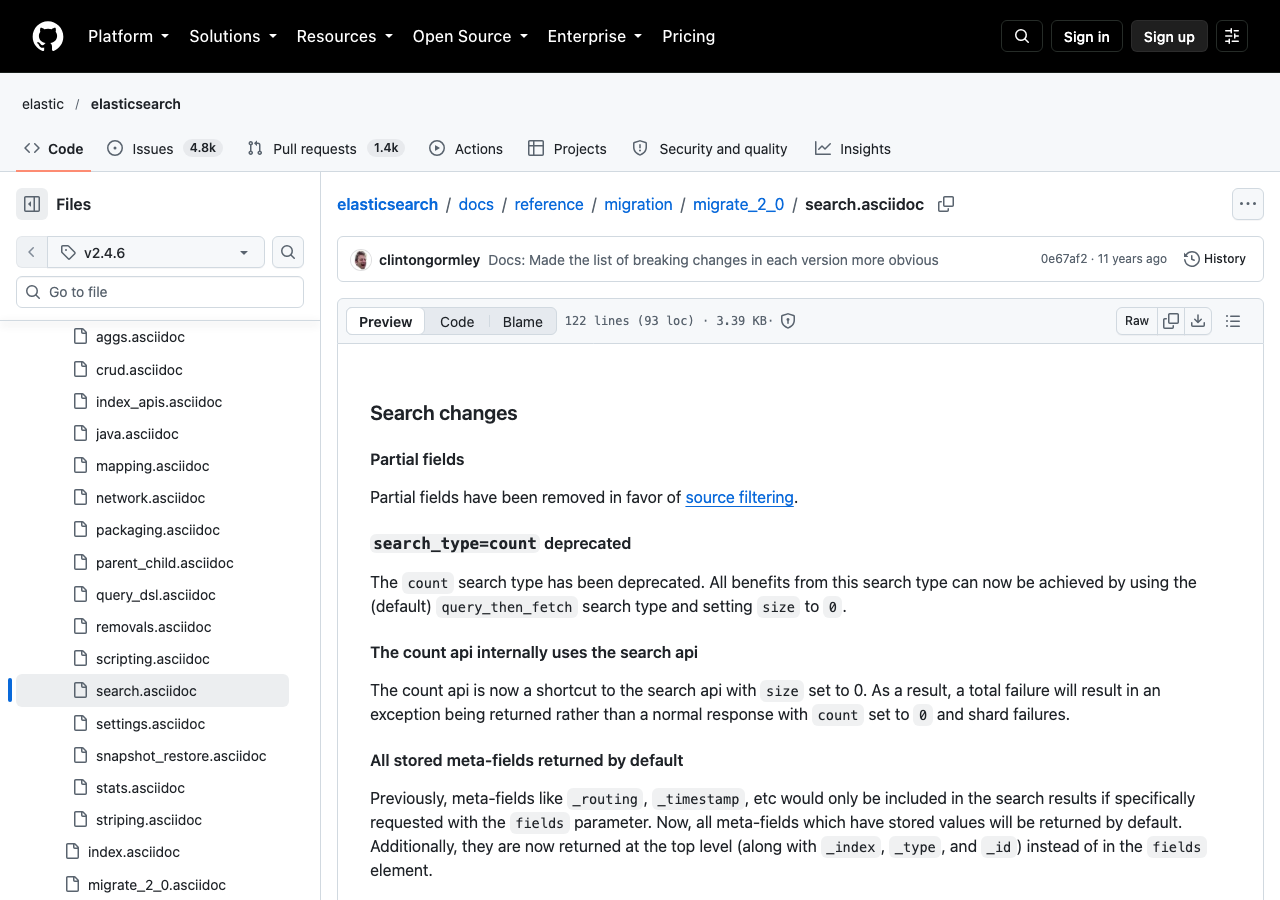
图 1:官方文件 search.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 search.asciidoc
这些改动为什么集中在 2.0
2.0 的定位是"清理版本":把 1.x 攒下的兼容包袱一次清掉——查询和过滤器合并(query 与 filter 合并)、facets 和 rivers 移除(2.0 的删除清单)、mapping 收紧(2.0 的 mapping 冲突检查)都在那一批里。Search changes 这一节属于其中"小而密"的部分:单独拆出来,哪一条都不足以单独发一个 breaking 公告,但加在一起,你升级后会发现响应结构、失败行为、参数名全对不上。
判断是:这类"小而密"的改动最容易被漏掉,因为每一条都不触发报错。会报错的改动(参数删了、字段没了)第一次调用就能发现;不报错但语义变了的(count 失败改抛异常、元字段挪位置、script field 少包一层数组),要等数据不对了才回头查,那时排查方向往往已经跑偏:先怀疑查询条件、数据、分片,最后才想到是版本行为变了。
所以大版本升级前,我建议把迁移文档里"没有报错但改了行为"的条目单独摘出来,一条条对照代码找;有报错的那批可以等运行时暴露。下面的检查顺序把 count API 的行为变化排在最前面,理由也在这里。
哪条改动最容易漏
这一节看着都是小改动,但风险不同。下面的等级是按"是否报错、是否只在失败时出现"排的:
- count API 的失败行为(最高):请求写法不变,只是把"返回 count=0"改成"抛异常"。代码一行没动,行为就变了,而且只在失败时出现,测试环境不容易触发,上生产才会暴露。
- 高亮的
require_field_match默认值(高):请求不报错,只是高亮片段消失,容易被当成数据问题。 - 元字段默认返回(中):语义不变,但响应结构变了,解析路径从
hit.fields.X变成hit.X。 search_type=count与 partial fields(低):这两个是显式的参数或字段移除,要么报错,要么结果不对,马上就能发现。
所以升级 2.0 时,检查顺序建议倒过来:先排查所有 count API 的调用点,再看高亮和响应解析,最后才是那两个会显式报错的。
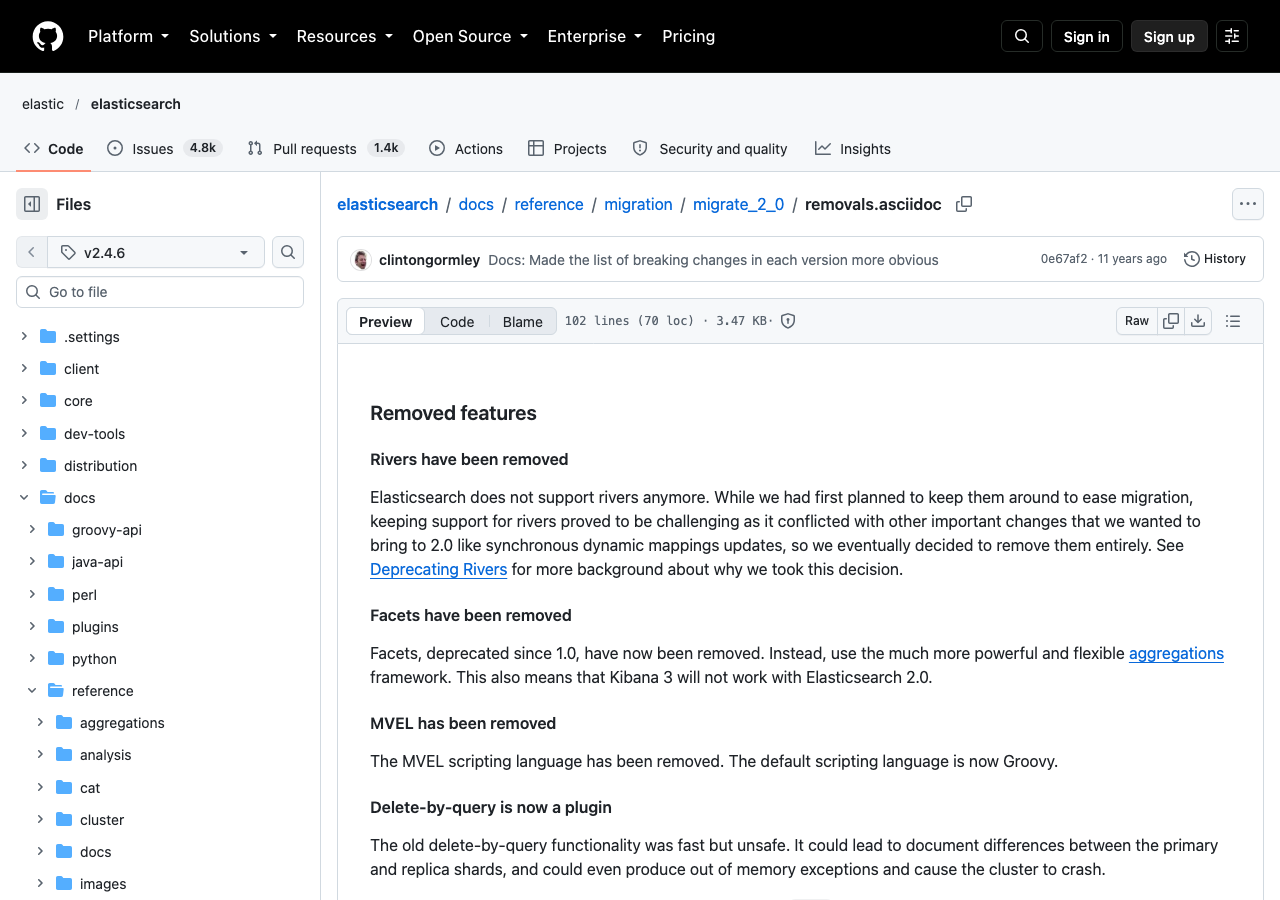
图 2:官方页面 removals.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 docs/reference/migration/migrate_2_0/removals.asciidoc
Partial fields 删除
2.0 移除了 partial fields,改用 source filtering(migrate_2_0/search.asciidoc @ v2.4.6):
Partial fields have been removed in favor of source filtering.
1.x 的 partial fields 靠 partial_fields 参数配合 include/exclude 的通配匹配抽取字段片段。2.0 统一到 _source 过滤:
GET my_index/_search
{
  "_source": { "includes": [ "obj1.*", "obj2.*" ], "excludes": [ "*.description" ] },
  "query": { "match_all": {} }
}
迁移文档只说了"改用 source filtering",没有给逐项对照。我的默认做法是改写后拿新旧两种请求各跑一遍,比较返回的字段是否一致。
search_type=count 废弃
count 这种 search type 被废弃。它带来的好处现在用默认的 query_then_fetch 加 size: 0 就能拿到:
GET my_index/_search
{
  "size": 0,
  "query": { "term": { "status": "published" } }
}
聚合场景尤其常见这个组合:只想要聚合结果,不要命中文档。
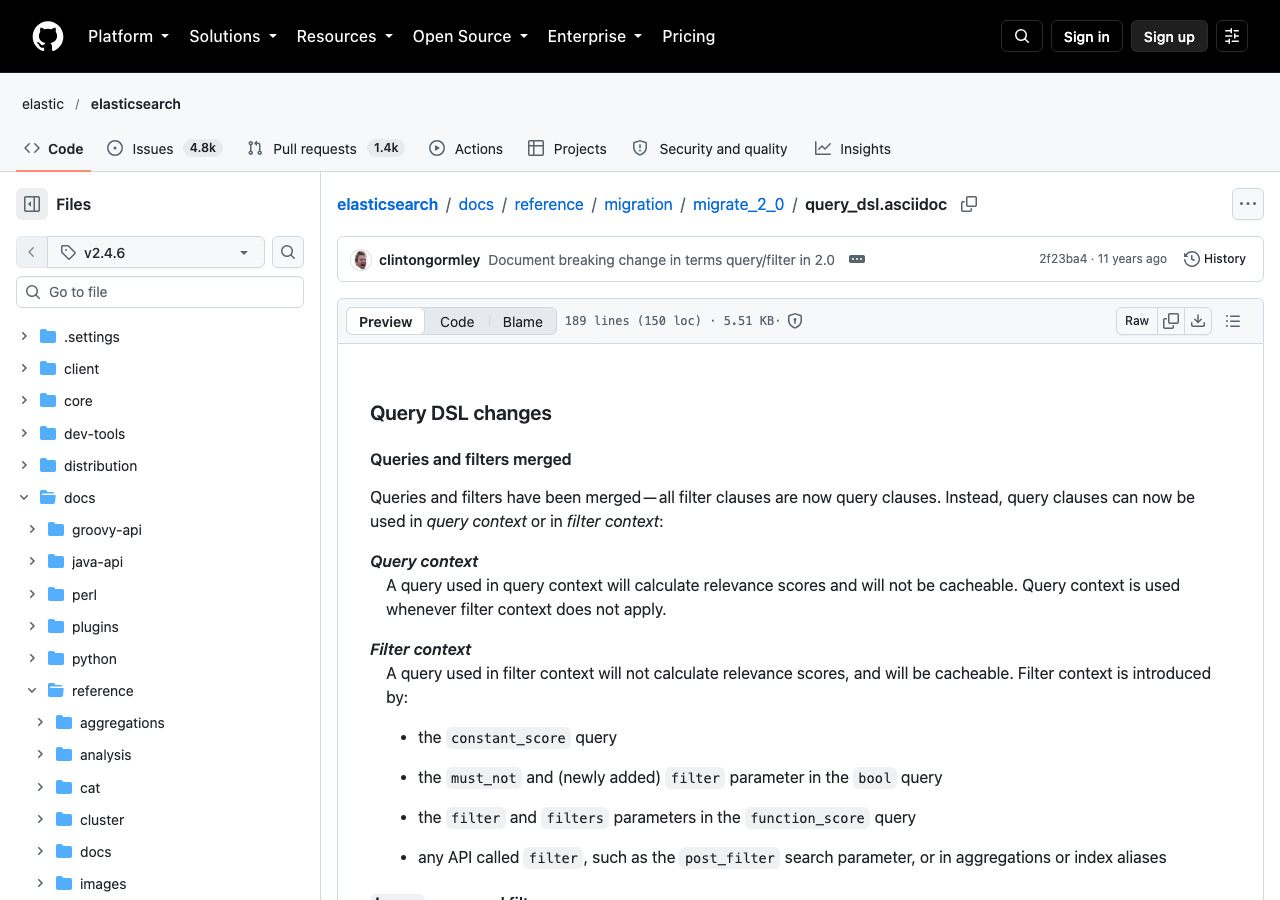
图 3:官方页面 query_dsl.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 docs/reference/migration/migrate_2_0/query_dsl.asciidoc
count API 的行为变化
count API 在 2.0 里变成了 search API(size=0)的快捷方式。由此带来一个容易被忽略的差异:
As a result, a total failure will result in an exception being returned rather than a normal response with
countset to0and shard failures.
1.x 里请求彻底失败时,count API 可能返回一个正常响应,只是 count 为 0 并带上 shard failures;2.0 会直接抛异常。这对调用方的错误处理是破坏性的——原来"只看 count 数字、不检查 shard failures"的代码,在 2.0 会收到 HTTP 错误码,如果该分支没做异常处理就会崩。
正确的适配是:显式捕获异常,或者像搜索一样检查 _shards.failed。
怎么验证这条行为差异
这条改动平时看不出来,需要主动造一次"所有分片都失败"的请求。文档没有给复现办法,下面是构造的思路:用一个无法解析的查询,让每个分片都失败。本文没有在 1.x 和 2.0 上跑过,预期来自文档那句"total failure 会返回异常",实际响应要以你的环境为准。
curl -i -XGET 'localhost:9200/my_index/_count' -d '{
  "query": { "no_such_query_type": {} }
}'
按文档,1.x 对整体失败可能回一个正常响应,count 为 0 并带 shard failures;2.0 起会返回异常。不存在的索引不适合当复现用例:它是否在两个版本都直接报错,文档没有说,本文没有验证。把这个差异写进集成测试,比读文档可靠。
适配时同时处理两条路径:捕获异常,也检查分片失败。
GET my_index/_count
{
  "query": { "term": { "status": "published" } }
}
拿到响应后检查 _shards.failed > 0,同时代码里包一层异常处理,1.x 和 2.0 的行为差异就被抹平了。
如果代码里有"count 为 0 就当作没有数据"这类逻辑,2.0 之后必须重看。"请求失败"和"确实没有数据"在 1.x 里表现相同(count=0),2.0 才把它们分开,旧代码往往正是靠这个混淆过得去的。
元字段默认返回,且位置变了
1.x 里 _routing、_timestamp 这类元字段只有用 fields 参数显式请求时才会出现在结果里。2.0 起,所有有 stored 值的元字段默认返回,而且位置从 fields 元素里挪到了顶层(和 _index、_type、_id 并列)。
例如这个请求:
GET /my_index/_search?fields=foo
返回结果里 _timestamp 会在 top level:
{
  "hits": {
    "total": 1,
    "max_score": 1,
    "hits": [
      {
        "_index":     "my_index",
        "_type":      "my_type",
        "_id":        "1",
        "_score":     1,
        "_timestamp": 10000000,
        "fields": {
          "foo": [ "bar" ]
        }
      }
    ]
  }
}
升级后解析响应的代码要改:原来去 hit.fields._timestamp 取值的地方改成 hit._timestamp。响应体也会变大:凡是有 stored 值的元字段都会带出来。批量 scroll 拉取的场景,升级后要重新看一遍超时和带宽。
Script fields 的数组行为
1.x 里 script field 永远返回单个值:即使脚本返回的是列表,也会被包成一个"数组里的数组"。2.0 起不再有这层多余包裹,脚本返回列表就直接返回列表。取值代码里如果写了 fields[0][0] 这种解包,升级后要改成 fields[0]。
time_zone、高亮、postings highlighter
这一节原文共 8 条,前面讲了 5 条。剩下三条同样不一定报错(原文):
time_zone 格式变严。date 字段的查询或聚合里,time_zone 参数必须是 ISO 8601 的 UTC 偏移量或时区 ID,+1:00 要写成 +01:00。代码里拼时区字符串的地方要检查补零。
高亮默认只管被查询的字段。require_field_match 的默认值从 false 改为 true,高亮器默认只处理被查询到的字段。文档特别点明:查询 _all 字段时,对 _all 以外的字段做高亮,不会产生任何高亮片段。解决办法是查询需要高亮的同一批字段,或者把 require_field_match 设回 false,这样高亮时完全不看字段名。postings highlighter 不再支持这个选项,只高亮被查询的字段。这条是上面排第二的原因:请求不报错,只是高亮消失。
postings highlighter 不支持 match_phrase_prefix。match 查询的类型设为 phrase_prefix(或 match_phrase_prefix 查询)时,postings highlighter 不返回高亮片段。
升级检查清单(附可以直接跑的排查命令)
按上面的风险排序,不按文档顺序:
第一步,先找 count API 的调用点(最安静、最容易漏):
# 代码里所有 /_count 的调用
grep -rn "_count" --include=*.java --include=*.py --include=*.go --include=*.js . | head -30
找到之后逐个确认:调用方有没有异常处理?有没有把 count == 0 当成"无数据"?这两处是重灾区。
第二步,查响应解析里的 fields 路径:
grep -rn "fields\[\|_source.*fields\|hit.*fields" --include=*.py --include=*.java . | head -20
确认元字段(_routing、_timestamp 等)的取值路径是不是还写在 fields 里,是的话改到顶层。
第三步,再查那两个会显式报错的:
grep -rn "partial_fields" . | head -20
grep -rn "search_type.*count\|searchType.*count" . | head -20
partial_fields→ 改成_source过滤,并确认字段是否store: true;search_type=count→ 改成size: 0;- script field 的解包逻辑去掉一层数组(
fields[0][0]→fields[0]); - 高亮请求:查询字段和高亮字段不一致的,补查询字段或把
require_field_match设回false。
写在最后
这一节的改动都不难改,但都改得隐蔽。迁移文档里 Search changes 只有寥寥几条,真正的工作量在"你的代码里有多少处依赖旧行为",这只能靠上面的 grep 一条条找,读文档读不出来。
建议升级前先在测试环境把三步 grep 跑一遍,把命中点列成表再逐个改。2.0 之后看到的症状往往是"数据不对"或"高亮没了",而不是报错,事后排查的方向很容易跑偏。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。

- 点赞
- 收藏
- 关注作者
评论(0)