目标检测和图像分类到底有什么区别

目标检测和图像分类到底有什么区别
做图像识别项目时,很容易遇到一个选择:我只是想让程序认出画面里的东西,到底该训练分类模型,还是检测模型?
比如识别传送带上的零件。相机每次拍到一个摆正的零件,判断型号,用分类往往就够了;换成俯拍一堆混放的零件,还要知道各自的位置和数量,任务就变成了检测。
区别不在于哪个名字听起来更高级,而在于:你希望模型交付什么结果。 这个选择会直接影响标注工作量、模型输出、评估方法,以及上线后会踩的坑。
同一张图,两种不同的答案
图像分类以整张图为判断单位。输入一张照片,模型输出它属于哪些类别。目标检测则以图中的目标实例为判断单位,既要识别类别,也要给出位置,通常用矩形框表示。
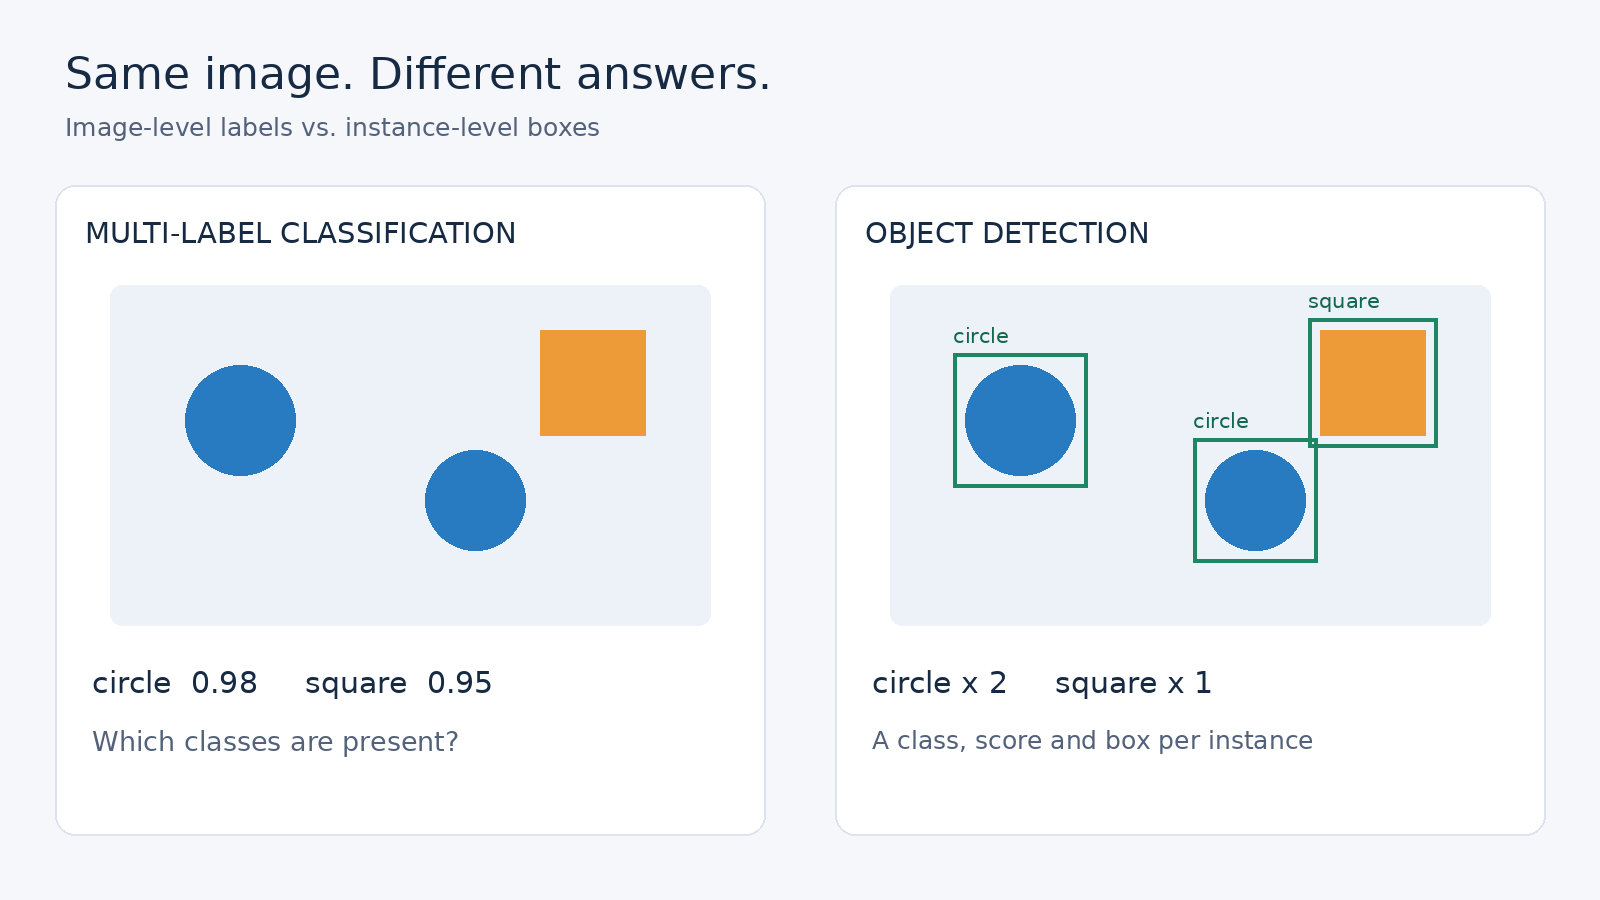
图中用几何图形代替真实物体:分类回答“画面中有哪些类别”,检测进一步回答“每一个在哪里”。图里的分数仅用于示意。
| 对比项 | 图像分类 | 目标检测 |
|---|---|---|
| 判断单位 | 整张图像 | 图中的每个目标实例 |
| 典型输出 | 类别及其分数 | 多组类别、分数和边界框 |
| 是否提供目标位置 | 通常不提供 | 提供 |
| 同类目标出现多次 | 通常仍只表达类别存在 | 可以输出多个同类实例 |
| 常见标注 | 每张图对应类别标签 | 每个目标对应类别和框 |
这里有个常见误解:分类并不等于“一张图片只能有一个物体”。单标签分类通常要求选出一个类别,多标签分类则可以同时判断“有猫、有狗”。但即使多标签分类知道两者都在,也不能据此知道有几只猫,更不能知道它们分别在哪。
“数量”和“位置”是新的输出需求,不是给分类模型多加几个类别就能自然获得的能力。
从代码看,输出结构已经不同了
假设图片里有两个螺丝和一个螺母,多标签分类结果可以表达为:
# 示意数据,不代表特定框架的返回格式
classification = {
    "screw": 0.98,
    "nut": 0.93,
    "washer": 0.04,
}
这些分数分别表示类别存在的预测。多标签任务常用 sigmoid,各类别分数不需要加起来等于 1;互斥的单标签分类则常用 softmax,把分数归一化到各个候选类别上。
检测结果需要保留每个实例:
# bbox 使用原图像素坐标:[xmin, ymin, xmax, ymax]
detections = [
    {"label": "screw", "score": 0.96, "bbox": [20, 30, 90, 150]},
    {"label": "screw", "score": 0.91, "bbox": [130, 45, 200, 165]},
    {"label": "nut", "score": 0.94, "bbox": [240, 80, 300, 140]},
]
业务代码可以根据这些框画出识别结果,也可以按类别计数。不过要注意,统计的是“模型检出的数量”:漏检会少算,重复框会多算。视频里逐帧把框数相加,更不能得到经过的物体总数,那通常还需要跟踪和跨帧去重。
另外,0.96 不代表这个预测在任何场景下都有 96% 的正确率。分数是否可靠,需要用实际业务数据验证,必要时再做校准。
检测为什么比分类多出这么多工作
两类模型都需要提取视觉特征,比如边缘、纹理和形状。常见分类网络会把空间特征汇总,再输出整张图的类别分数;检测网络则需要保留并利用空间信息,预测类别和位置。
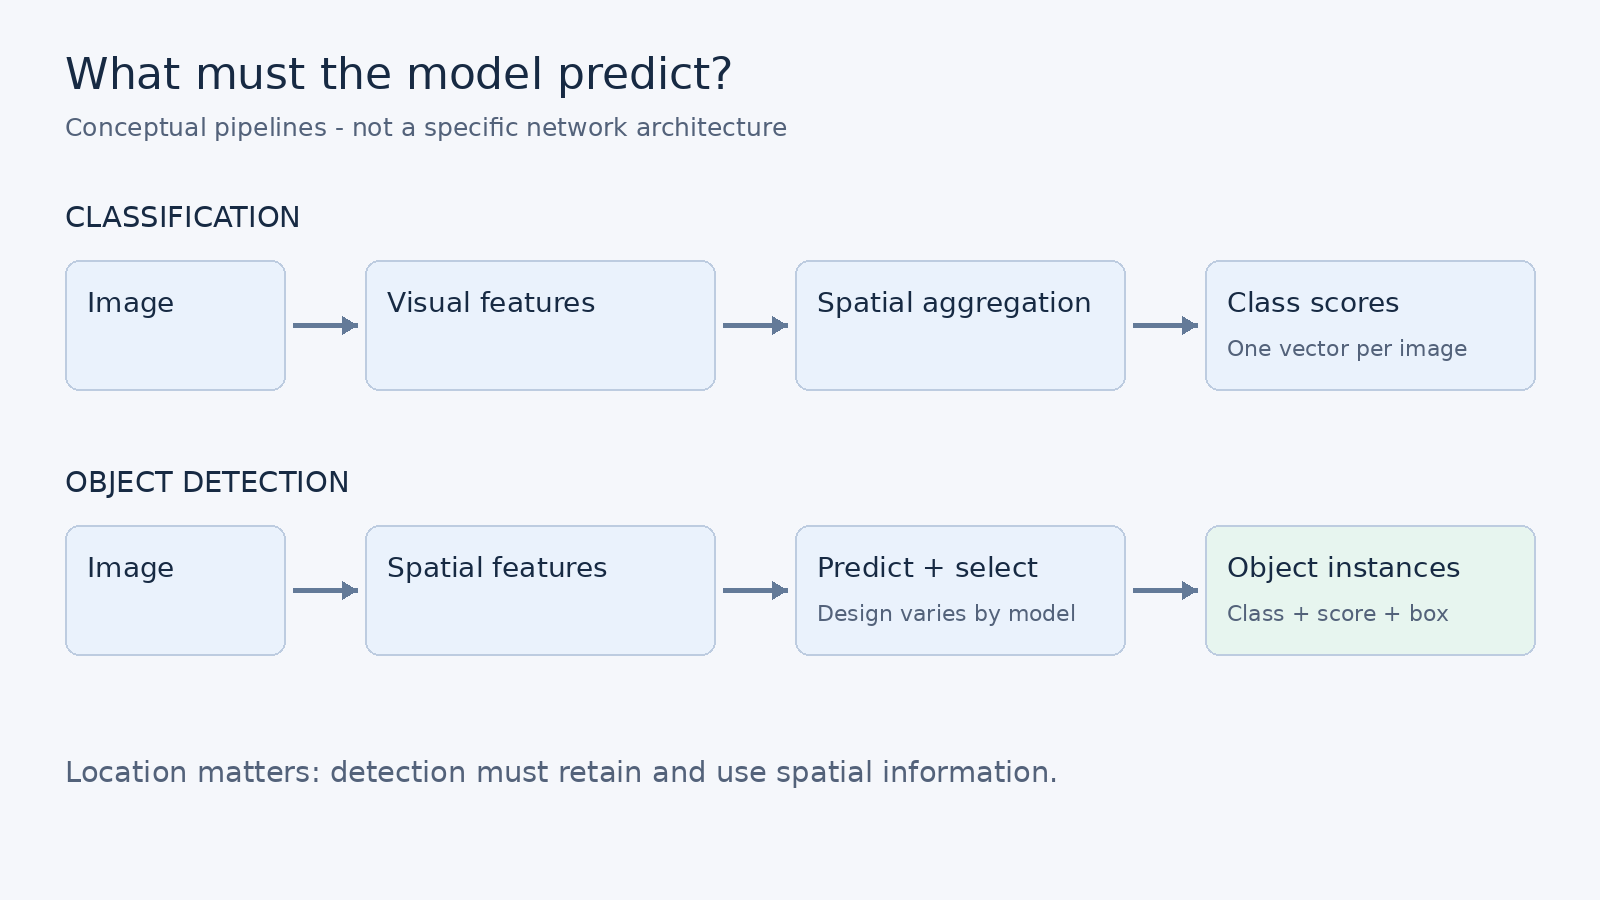
这张图表达的是任务层面的数据流,不是某个网络的完整结构。实际检测器有不同路线:Faster R-CNN 一类方法先产生候选区域,再做分类和框的细化;YOLO 一类方法通常直接进行密集预测;DETR 一类方法把结果组织成目标集合预测。
所以,把检测概括成“在图片上滑动分类器”可以帮助直觉理解,却不足以描述现代检测器。它还要处理目标尺度变化、背景干扰、实例匹配,以及可能出现的重复预测。
不少检测器会用非极大值抑制,也就是 NMS,筛掉同类目标附近的重复框。但并非所有检测器都必须依赖它。对于需要 NMS 的模型,阈值过严可能误删挤在一起的真实目标,过松则容易留下重复框。
这种复杂度也体现在训练数据上。分类通常给图片一个或多个标签就行;检测要明确框出每个需要识别的目标,还要统一标注规则:被遮挡的物体怎么框?只露出一角要不要标?很小的目标是否纳入范围?
同一批数据里,有人只框可见部分,有人按完整轮廓估计,模型学到的定位目标就会不一致。漏标也不是小事:在许多训练设置下,没标出来的真实目标可能被当作背景处理。
分类看准确率,检测为什么常看 mAP
分类的判断相对直接:预测类别是否与标签一致。类别均衡时可以看准确率;如果“正常”占了 99%,只看准确率就很容易自我安慰,还需要关注异常类别的精确率、召回率、F1,以及混淆矩阵。
检测除了“认对”,还要“框对”。常用的定位指标是交并比 IoU:
IoU = 预测框与真实框的交集面积 / 两个框的并集面积
预测框与真实框完全重合时,IoU 为 1;完全不相交时为 0。评估时通常要求类别正确、IoU 达到指定阈值,并按规则把预测与真实目标匹配。同一个真实目标不能因为被预测出三个框,就算识别成功三次。
AP 基于预测分数排序形成的精确率—召回率关系计算;mAP 通常再对类别取平均。有些评估还会在多个 IoU 阈值上平均。因此,看到“mAP 80%”,要先确认它指的是 AP50、AP75,还是 COCO 风格的 AP@[0.50:0.95],这些数字不能直接混着比较。
落到业务里,指标还要对应代价。流水线漏掉缺陷的代价高,就要重点看缺陷召回率;自动告警误报太多会让人疲劳,就要检查精确率。模型总分不错,不代表关键类别、远处小目标或夜间画面也表现不错。
选模型之前,先看相机怎么拍
判断任务类型,有时不用先研究网络结构,先看看输入就能省下不少工作。
如果每张图都是一个居中的零件,你只想判断型号或者合格与否,分类通常更容易落地。若画面里可能同时出现多个零件,还要分别定位和计数,就应该考虑检测。
还有一种实用方案是“检测加分类”:先把物体找出来,裁剪目标区域,再交给分类模型识别细分型号。它适合定位目标相对统一、细分类别复杂的场景,但不是免费提升:检测漏掉的目标,后面的分类器根本看不到;裁剪偏了,分类也可能受影响,还会增加推理耗时。
| 业务问题 | 优先考虑 |
|---|---|
| 一张商品主图属于哪个品类 | 图像分类 |
| 一张照片中是否出现安全帽,不要求位置 | 可先验证多标签分类 |
| 每个人是否正确佩戴安全帽 | 检测并结合人员关联、佩戴关系判断 |
| 找出表面缺陷并标出位置 | 目标检测;需要精确轮廓时考虑分割 |
| 计算裂纹覆盖面积 | 分割,并结合尺度标定与测量规则 |
尤其是“是否戴安全帽”:检测到画面里有一个人和一顶帽子,不等于这个人戴了帽子。模型输出到业务结论之间,往往还隔着关联规则,或者需要直接训练合适的状态类别。
也不要认为检测模型一定比分类模型慢。耗时还取决于输入分辨率、模型规模、硬件和后处理。更现实的比较方法,是在同一设备上,用相同业务样本测量准确性和端到端延迟。
真正要分清的是任务边界
图像分类解决整张图的类别判断;目标检测把判断细化到每个实例,并给出位置。如果矩形框还不够,业务需要物体轮廓、面积或者像素归属,那就继续考虑分割。
做项目时,可以先写出一条期望返回的数据:只要一个标签,还是需要一组带坐标的目标?再用真实样本检查遮挡、小目标和背景变化。把输出定义清楚,后面的标注方案、模型选择和验收标准才有落点。

- 点赞
- 收藏
- 关注作者
评论(0)