NPU、GPU 和 CPU 跑 AI 到底有什么区别

NPU、GPU 和 CPU 跑 AI 到底有什么区别
现在看电脑、手机的宣传页,经常能看到一个数字:AI 算力多少 TOPS。CPU、GPU 已经够让人纠结了,又来了一个 NPU。它是不是专门跑 AI 的,所以一定比显卡快?电脑没有 NPU,是不是就不能本地运行大模型?
都不是。真正决定体验的,往往是模型能不能适配、数据搬得够不够快,以及你到底要它做什么。
AI 的计算,究竟特殊在哪
拿图片分类来说,一张图片进入神经网络后,会经过一连串卷积、矩阵乘法、激活等运算。大语言模型结构不同,但同样有大量矩阵运算。它们的共同点是:需要对很多数字反复执行相似的计算。
例如矩阵乘法 Y = XW,输出中的不同元素,包含许多可以并行计算的乘加操作。硬件如果能同时处理大量乘加,并让数据在计算单元附近重复利用,就有机会把速度提上去。
不过,模型不是只有矩阵乘法。输入处理、索引、归一化、内存分配,以及生成过程中的调度,也会影响最终耗时。只盯着最擅长加速的那部分,很容易高估实际效果。
CPU:灵活,很多时候也是最省事的入口
CPU 擅长处理复杂控制逻辑、条件分支和各种通用任务。它不仅能跑神经网络,还负责读文件、处理请求、准备输入和调用其他设备。
“CPU 只能串行计算”是一个常见误解。多核、SIMD 向量指令,以及部分处理器提供的矩阵计算扩展,都能加速 AI。只是相比专门堆叠大量并行计算资源的加速器,CPU 的设计还要照顾更多类型的程序。
它的优势很实际:部署路径通常比较直接,不必额外配一张加速卡。小型文本分类、轻量图像识别,或者请求量不大的服务,CPU 就可能够用。一些量化后的语言模型也能在 CPU 上运行,只是速度取决于模型大小、内存带宽和实现。
所以,先在 CPU 上跑通并测出基线,是很有价值的一步。任务总共只需要几十毫秒时,换设备带来的调度和数据搬运开销,可能吃掉不少收益。
GPU:把大量相似计算一起做
GPU 原本服务于图形处理,后来成为 AI 计算的重要平台。它擅长吞吐大量并行任务;现代 GPU 还可能包含针对矩阵运算优化的单元,例如 NVIDIA 的 Tensor Core。
训练模型时,需要反复执行前向计算、反向传播和参数更新。大量可并行的运算,加上高带宽显存,让合适的 GPU 很有发挥空间。推理中的批量图片处理、大模型服务,也经常受益于这种能力。
但“有独显”不等于“什么模型都能飞快运行”。显存装不下、算子实现不合适、任务太小,都会限制效果。不同厂商的软件栈、驱动和框架支持也有区别,支持 CUDA 的程序并不能原样调用所有 GPU。
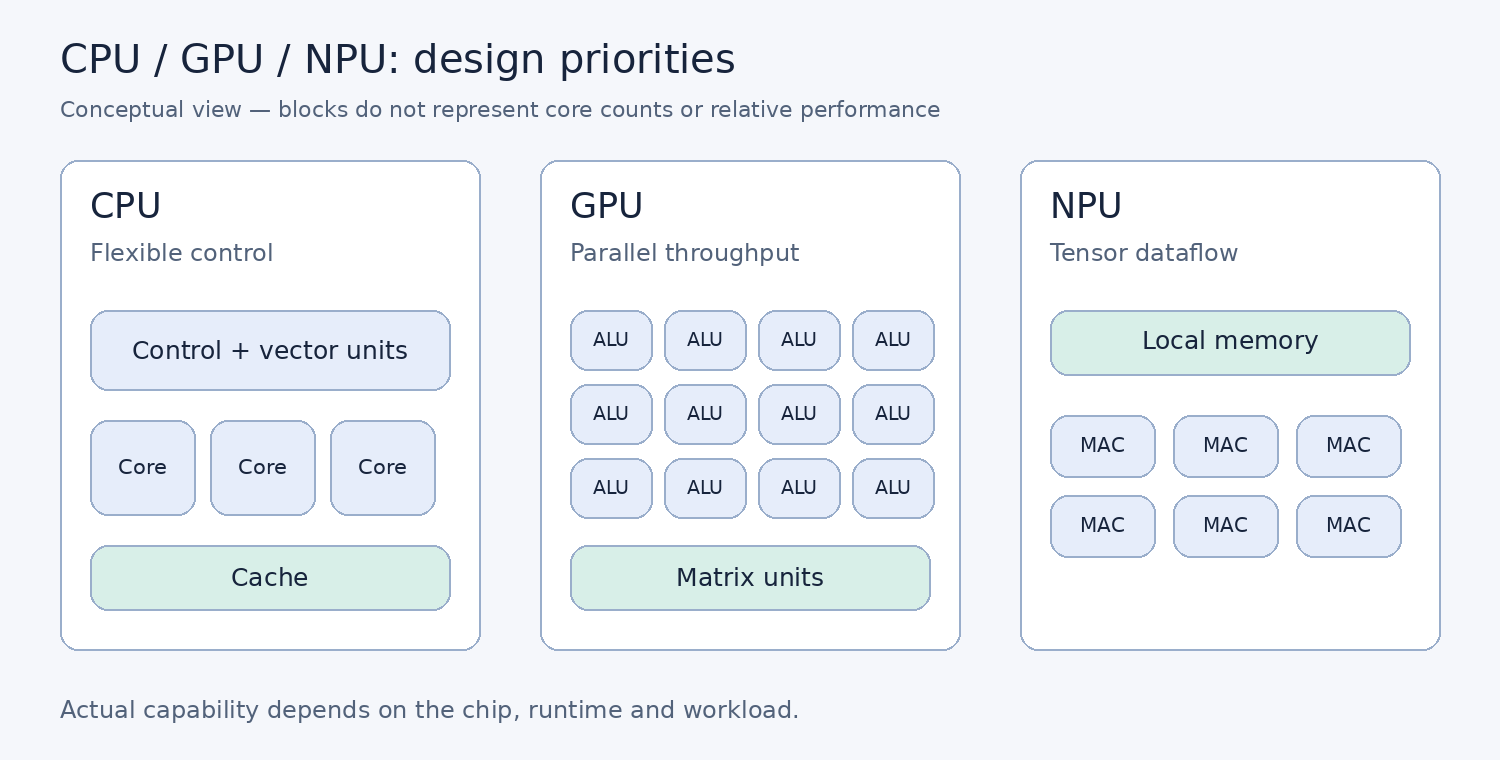
图 1:三类处理器的设计侧重点。方块只是功能示意,不代表真实核心数量、面积或性能比例。
NPU:围绕神经网络的数据流做优化
NPU 通常指面向神经网络计算设计的处理器。常见思路是提供高效的矩阵或张量计算单元,配合片上存储、数据复用和编译器优化,减少反复访问外部内存的开销。
它与 GPU 的区别,不是“一个懂 AI、一个不懂 AI”。两者都在加速数值运算,只是架构取舍和软件接口不同。
手机、轻薄本里的 NPU,往往着重于功耗敏感的本地推理:摄像头画面处理、语音识别、视频会议背景分割等。持续运行时,能在满足延迟要求的同时少耗电,比瞬间跑出最高吞吐更重要。
但不能把所有 NPU 都理解成低功耗小芯片,更不能说 NPU 只能推理。数据中心也有面向大规模训练和推理的专用 AI 处理器,昇腾体系就包含相应产品和软件方案。[1]
NPU 的实际门槛经常在适配上。模型里的算子、数据类型、输入形状,必须符合目标设备和工具链的支持范围。有的模型需要转换格式、编译,或者先做量化。名称都叫 NPU,也不意味着它们能共用同一套部署文件。
| 观察角度 | CPU | GPU | NPU |
|---|---|---|---|
| 设计侧重点 | 通用计算与复杂控制 | 大规模并行计算 | 神经网络计算与数据流优化 |
| 常见合适场景 | 小模型、低并发、流程控制 | 训练、批量推理、大模型计算 | 已适配模型的高效推理,也有训练产品 |
| 部署时要关注 | 指令集、线程、内存带宽 | 软件生态、显存、算子性能 | 算子覆盖、编译、精度和形状限制 |
这张表不是性能排名。同一个模型,在不同产品、功耗设置和软件版本下,结果可能完全不同。
为什么 TOPS 高,跑起来却不一定快
TOPS 表示每秒万亿次操作,通常描述某种计算条件下的峰值能力。比较之前,至少要看清精度、是否使用稀疏计算,以及操作次数的统计口径。
INT8 的数字不能直接拿来和 FP16 比。标注稀疏条件的峰值,也不代表任意模型都能达到。同样叫一次矩阵乘加,常见口径会把乘法和加法计作两次操作。
更关键的是,峰值不包含整个应用的所有成本。假设一个流程原本花 100 毫秒,其中只有 60 毫秒能够加速;即使这部分快了 10 倍,总耗时仍是 40 + 6 = 46 毫秒。整段流程只快了约 2.17 倍。
大模型还有一个容易忽略的限制:搬数据。以稠密的 70 亿参数模型为例,FP16 权重的原始体积约为 14 GB;4 bit 权重理论上约 3.5 GB。实际运行还需要量化元数据、临时缓冲区和 KV Cache,不能只按权重体积准备内存。
低批量逐 token 生成时,性能经常受内存带宽限制;处理输入提示词的阶段则更容易体现并行计算能力。这是常见倾向,具体瓶颈还会随模型、上下文长度和批量变化。[2] 因此,“多久开始出字”和“出字之后每秒多少 token”,应当分开测。
选了 NPU,为什么 CPU 还在忙
实际应用中,通常不是让某块芯片独自包办全部工作。
以图片识别为例,CPU 可能先读取和缩放图片,把张量交给 GPU 或 NPU,再接收输出并整理结果。具体分工取决于应用实现,预处理也可以被放到其他设备上。
更隐蔽的是模型内部的分工。部分运行时会把支持的子图交给加速器,不支持的部分留给 CPU。例如 ONNX Runtime 通过 Execution Provider 分配可执行的节点或子图,并提供默认 CPU 执行能力。[3] 这不代表所有工具都能自动兜底:有的编译或部署路径会直接报错。
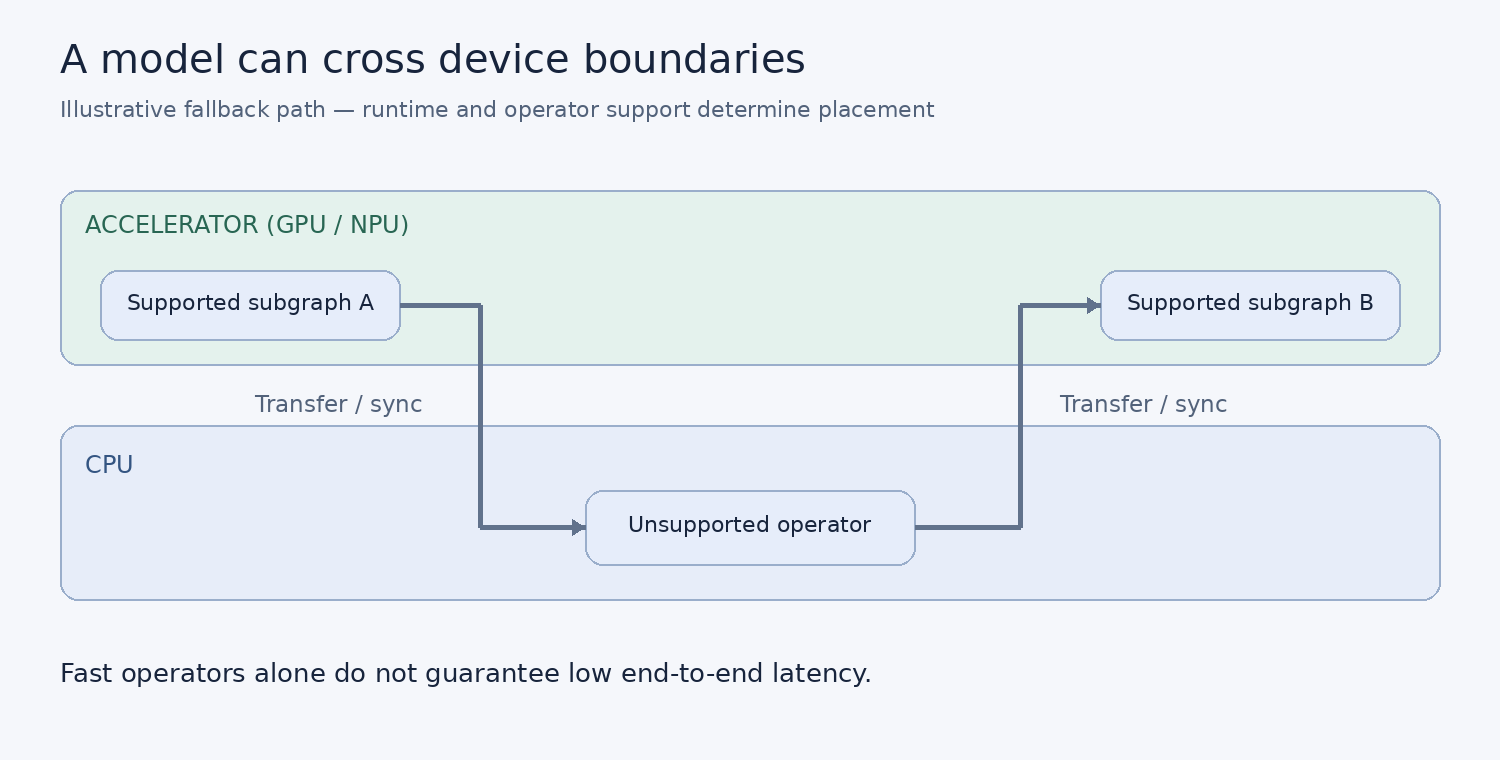
图 2:一种可能的执行方式。中间算子回到 CPU 后,设备边界可能引入数据拷贝、格式转换或同步;共享内存也不意味着这些成本全部消失。
如果模型频繁跨设备执行,某几个算子快很多,也未必能挽回整体损失。排查时不能只看“设备已启用”,还要通过运行时日志或性能分析确认:哪些算子真的运行在目标设备上,时间花在了哪里。
真要部署,怎么选更靠谱
可以从手里的任务倒着选硬件。
- 验证想法、小模型、低并发服务:先用 CPU 跑通,看看延迟是否已经够用。
- 训练、微调或大量并行推理:重点检查 GPU 或训练型 AI 加速器的框架支持、内存容量和实际吞吐。
- 手机、轻薄本上的持续 AI 功能:如果模型已适配 NPU,重点比较持续功耗、温度和延迟。
- 本地语言模型:先确认能否完整部署,再看内存或显存、带宽、量化方式,以及运行时对硬件的支持。
测试时要固定模型、输入长度和批量。不同精度的版本还应检查输出质量,不能把量化造成的变化也算成纯粹的硬件优势。把首次加载或编译耗时与预热后的运行耗时分开,并记录端到端延迟、吞吐和功耗,比只抄一个算力数字有用。
CPU、GPU、NPU 不是依次淘汰的三代产品。做一个实际项目,常见的情况是 CPU 负责组织流程,加速器承担适合它的计算。选型时真正需要回答的是:这个模型通过哪套软件,能在这块硬件上以什么成本,达到我需要的速度和质量?

- 点赞
- 收藏
- 关注作者
评论(0)