搜索结果只有干巴巴一行,用结构化数据让摘要多出评分和目录
【摘要】 结构化数据(Structured Data)是用标准词汇把页面内容告诉搜索引擎的"说明书"。本文讲清 JSON-LD 是什么、怎么嵌进页面 head、以及 Article / Breadcrumb / FAQ 几种常用 schema 的写法,让搜索结果展示更丰富。
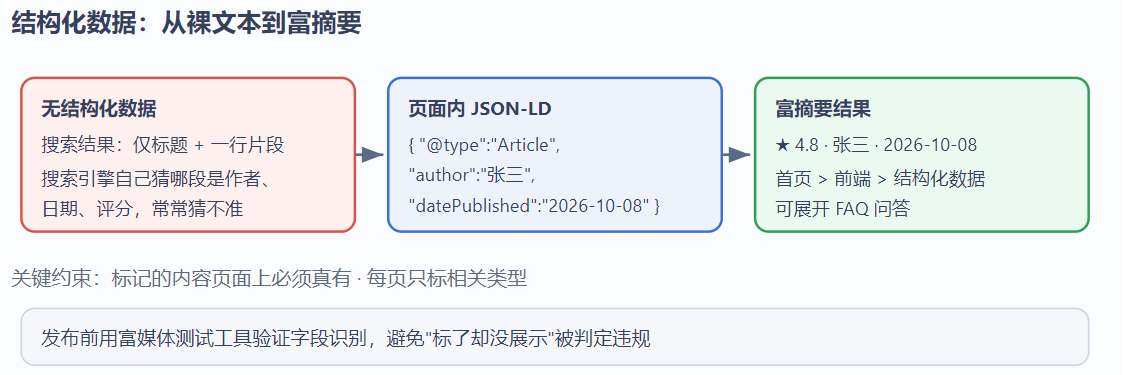
有时候你辛辛苦苦写了篇文章,搜出来却只有标题加一句抓取的片段,而别人的结果旁边带着星级评分、发布日期、面包屑导航,甚至展开能直接看常见问题。差距不在内容质量,而在你有没有给搜索引擎递一张"内容说明书"——这张说明书就是结构化数据。
一、结构化数据到底是什么
简单说,普通网页的文字是写给"人"看的,搜索引擎得自己猜哪段是标题、哪段是作者、哪段是价格。结构化数据是用一套通用词汇表把这些信息显式标出来,相当于你直接告诉它:“这一段是作者名,这一段是发布日期,这一段是评分”。
实现方式有三种:Microdata(嵌在 HTML 标签里)、RDFa、JSON-LD。现在业界基本只推荐 JSON-LD——它是一段独立的 <script> 块,不污染页面结构,改起来也方便。
二、把 JSON-LD 放进 head 就行
以一篇博客文章为例,最基础的 Article schema 长这样:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "用结构化数据让搜索摘要更丰富",
  "author": { "@type": "Person", "name": "张三" },
  "datePublished": "2026-10-08",
  "dateModified": "2026-10-08",
  "publisher": { "@type": "Organization", "name": "我的技术博客" }
}
</script>
只要这段 JSON-LD 出现在页面里,搜索引擎抓取时就能读走这些字段。很多框架(Next.js、Nuxt、Hexo 插件)都支持在 <head> 里注入,静态站也可以在构建时把数据写进去。
三、几种常用的 schema 类型
| 类型 | 作用 | 典型字段 |
|---|---|---|
| Article | 文章类页面 | headline、author、datePublished |
| Breadcrumb | 面包屑导航 | 层级路径 itemListElement |
| FAQPage | 问答折叠 | question + acceptedAnswer |
| Product | 商品页 | name、offers、aggregateRating |
| Recipe | 菜谱 | cookTime、nutrition |
面包屑用好了,搜索结果里会出现"首页 > 前端 > 本文"这样的路径,帮用户一眼定位;FAQ 用好了,结果能直接展开你写的问答,占据更多版面。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    { "@type": "ListItem", "position": 1, "name": "首页", "item": "https://blog.example.com" },
    { "@type": "ListItem", "position": 2, "name": "前端", "item": "https://blog.example.com/fe" },
    { "@type": "ListItem", "position": 3, "name": "结构化数据", "item": "https://blog.example.com/fe/jsonld" }
  ]
}
</script>
四、两个容易踩的坑
- 内容和标记要对得上。你标了
aggregateRating说评分 4.8,页面上却看不到任何评分,这种"标记了但没展示"会被判违规,严重的还会被处罚。标记什么,页面上就得真有什么。 - 别堆无关 schema。每页只标和当前内容直接相关的类型,一篇文章塞进 Product、Recipe、JobPosting 一大堆,反而显得不自然。

总结
搜索结果干巴巴,多半是缺了结构化数据这张"说明书"。用 JSON-LD 把 Article、Breadcrumb、FAQ 等类型写进页面,搜索引擎就能读出作者、日期、评分、层级,把摘要展示得更丰满。记住两点:标记的内容页面上必须真有,别虚构评分;每页只标和当前内容相关的类型,别乱堆。

【声明】本内容来自华为云开发者社区博主,不代表华为云及华为云开发者社区的观点和立场。转载时必须标注文章的来源(华为云社区)、文章链接、文章作者等基本信息,否则作者和本社区有权追究责任。如果您发现本社区中有涉嫌抄袭的内容,欢迎发送邮件进行举报,并提供相关证据,一经查实,本社区将立刻删除涉嫌侵权内容,举报邮箱:
cloudbbs@huaweicloud.com
- 点赞
- 收藏
- 关注作者
评论(0)