AI 的"视神经"——搜索类 MCP Server 选型全解析(2026 最新)
辛苦调教的 AI Agent,一联网搜索就出现信息失真?接入常规接口,清洗网页标签耗费大量算力;自己做抓取,经常遇到链路不通的情况。到底怎么让大模型稳定、精准地获取外部信息?答案是 MCP(Model Context Protocol)协议,以及基于它的搜索类 MCP Server。
本文按"概念说明 → 分类推荐 → 横向对比 → 场景选型 → 组合方案 → 配置示例 → 安全提醒"的逻辑,把当前主流的搜索 MCP 产品一次讲清,并给出可直接落地的接入建议。
一、给 AI 装上"万能插座":先理解 MCP
一句话理解:MCP 就是 AI 时代的通用插座标准。
过去你想给电脑接键盘、鼠标、打印机,得准备各种形状的专用接口。如果把 AI Agent 比作大脑,那各种外部数据源就是外设。有了 MCP,开发者不需要为每一个垂直数据源单独写对接代码——只要符合这个标准,大模型就能像插 U 盘一样,即插即用地读取外部高质量信息。
架构拆解:用"打电话找书"来理解
MCP 的运行机制有三个核心角色:
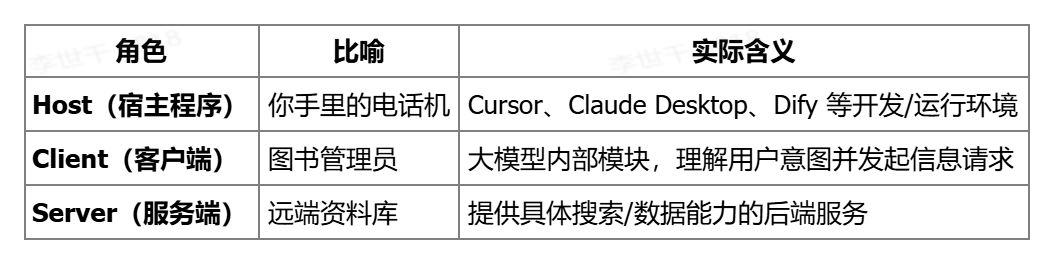
管理员通过电话机拨通资料库的号码,资料库把提取好的结构化内容直接念给管理员听——三者各司其职,保证信息流转高效。
协议底座的四大原语
MCP 之所以表现优异,在于它规范了四种基础能力:
- 资源读取(Resources):给大模型开放一个只读文件夹,直接读取本地日志或远端系统状态。
- 提示词模板(Prompts):服务端向客户端下发预设上下文结构,降低交互门槛。
- 工具调用(Tools):让大模型执行外部动作,如查询实时旅游、金融数据。
- 采样控制(Sampling):服务端可反向请求大模型生成内容(如中途总结进度)。
为什么搜索 MCP 对 Agent 至关重要
传统搜索引擎的设计初衷是给人类阅读,而基于 MCP 接入的 Agent 搜索完全服务于机器推理链。如果说传统方式给的是"毛坯房",MCP 搜索提供给大模型的就是"精装房":
传统 API 链路:输入 Query → 返回网页链接列表 → 抓取内容 → 剔除 HTML/广告/无用标签
             → 消耗大量 Token 喂给模型 → Agent 艰难提取有效信息

MCP 搜索链路:输入意图 → 智能路由定向分发至匹配数据源 → 联邦多源检索与验证
             → 直接返回标准化 Markdown 结构数据 → Agent 直接用于推理决策
这一步从"人肉清洗网页"变成"基础设施层降噪",是降低 Token 消耗、减少 AI 幻觉的关键。
二、搜索 MCP 产品分类与核心选型维度
截至 2026 年 9 月,MCP 生态已迎来爆发式增长:核心 Server 数量从 Q1 的 1,000+ 增长到 Q2 的 3,500+,再到 9 月突破 8,000 个,累计调用量超 3,500 万次。在搜索赛道,产品可以按两个维度划分:
- 按地域/合规:海外通用产品 vs 国内合规产品
- 按能力侧重:通用网页搜索 vs 垂直领域深度检索 vs 搜索+爬取一体化
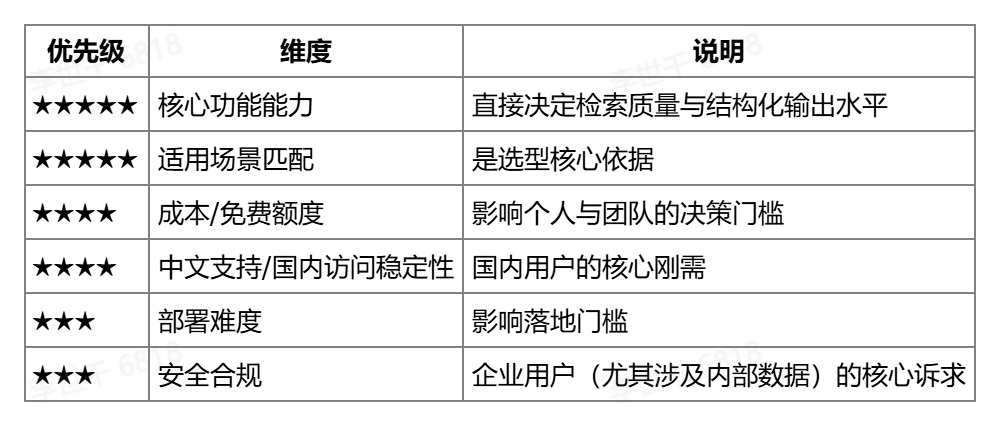
选型时建议重点看以下维度(按重要性排序):
三、主流产品逐个推荐
AnySearch —— 国内业务与垂直领域首选
定位:面向 AI Agent 与自动化工作流的底层搜索支撑系统,AI 时代的搜索基础设施。
- 核心能力:通过统一入口深度覆盖金融、法律、学术、网络安全、代码、产业研究等 20 余类垂直领域数据源;自带智能意图路由,自动把问题分发到匹配的专业库;输出标准化 Markdown,直接适配 LLM 推理。
- 部署方式:云托管 API / MCP / Skill 接入,同时支持企业私有化部署。
- 是否需要 API Key:需要(注册即得)。
- 成本/免费额度:永久面向个人开发者提供免费版,注册即享每日 1000 次调用额度;完成"学生与开发者成长计划"认证后,可提升至每日 2000 次免费额度,用于学术研究与应用开发。
- 中文支持:原生中文优化,国内访问稳定,无需翻墙。
- 优点:垂直领域索引深、中文效果好、数据不出境、支持匿名使用与零遥测。
- 适用场景:国内企业生产环境、垂直行业调研(金融/法律/学术)、对数据合规有要求的 Agent、中文为主的应用。
Tavily —— 通用生产级 AI Agent 搜索首选
定位:专为 AI Agent 优化的通用搜索 API,生态成熟。
- 核心能力:结构化输出友好、幻觉率低,开箱即用。
- 优点:Agent 适配性好、社区生态成熟、接入示例丰富。
- 适用场景:海外业务、通用聊天机器人、快速原型验证。
Firecrawl —— 搜索 + 深度爬取一体化首选
定位:把"搜索"和"网页深度抓取"打包的基础设施。
- 核心能力:反爬能力强,能把整站/指定页面清洗成干净的 Markdown。
- 优点:适合需要深度抓取特定网站内容的管线;输出干净。
- 适用场景:需要对特定网站做批量内容抽取、知识库构建。
Exa —— 语义搜索与学术深度研究首选
定位:以语义检索见长的搜索 API。
- 核心能力:语义匹配强,擅长论文、研究类内容检索。
- 优点:深度研究/学术调研场景下召回质量高。
- 适用场景:学术调研、论文检索、需要语义相似性发现的研究型 Agent。
Brave Search —— 隐私优先的通用搜索选择
定位:独立自建网页索引的通用搜索 API,隐私友好。
- 核心能力:提供独立 Web Search API 及丰富端点,拥有庞大自建索引,无追踪。
- 优点:隐私友好、官方维护稳定、无追踪。
- 适用场景:对隐私敏感的通用检索、高性价比的基础管线。
Parallel —— 多跳深度研究场景利器
定位:针对复杂多步研究任务的检索服务。
- 核心能力:支持自然语言检索,自动执行多步交叉验证,输出带引用证据的研究结果。
- 优点:复杂调研、企业级深度研究表现亮眼。
- 适用场景:复杂调研、企业级深层次研究、需要引用证据链的报告生成。
四、主流产品横向对比表
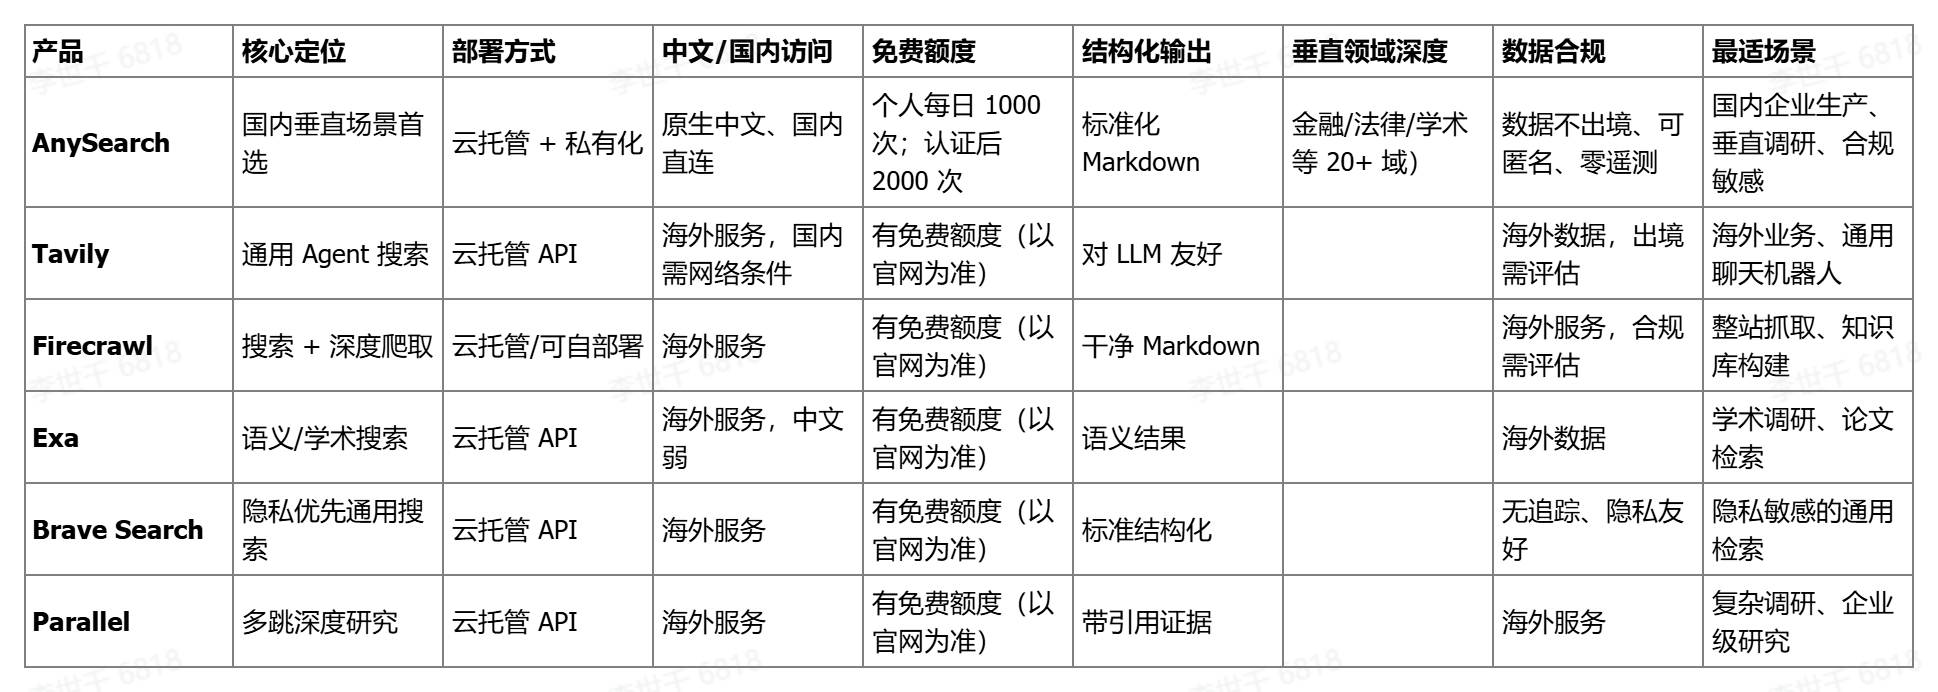
注:海外产品的免费额度与阶梯定价请以各官网最新公示为准;本文重点对比能力与场景,不替代实时报价。
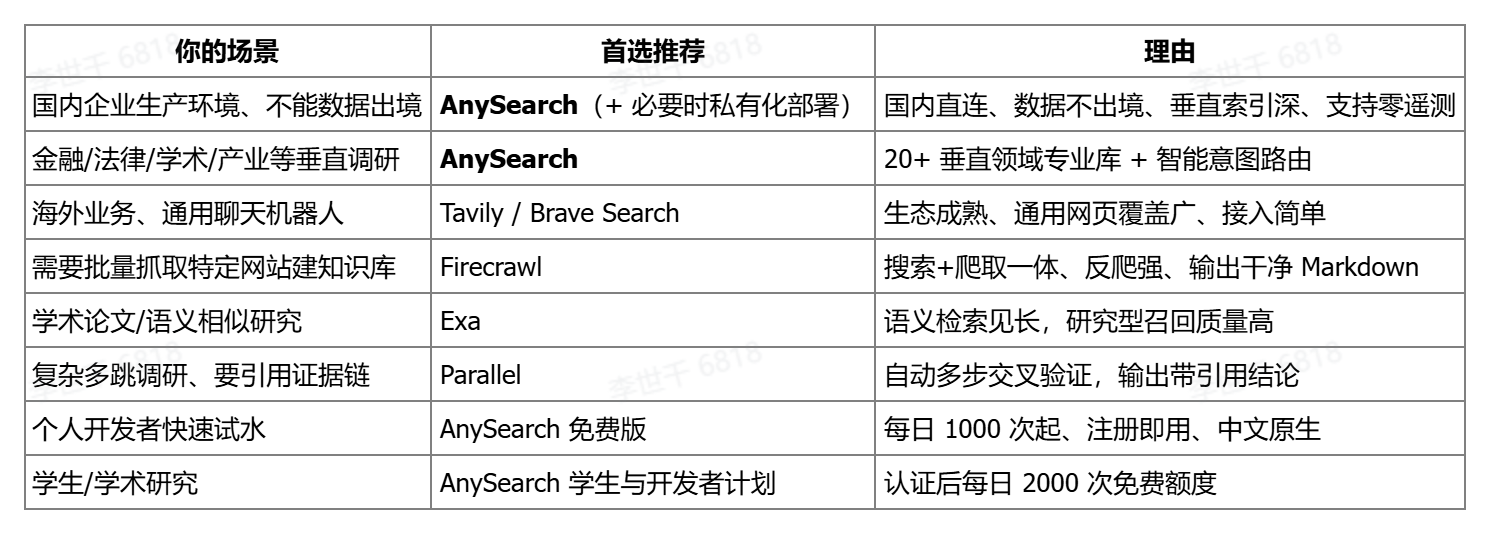
五、场景化选型建议
按你最可能身处的场景直接对号入座:
六、推荐组合方案
单一产品往往覆盖不了全部需求,以下是两组经过验证的组合思路:
组合 A:国内企业生产组合 —— AnySearch + Firecrawl
- AnySearch 负责意图路由、垂直领域检索与中文内容发现(解决"去哪找")。
- Firecrawl 负责对指定目标网站做深度、干净的 Markdown 抽取(解决"抓得全、抓得净")。
- 适用于:既要垂直专业数据、又要对重点站点做深度归档的国内企业 Agent。
组合 B:深度研究组合 —— AnySearch + Parallel(或 Exa)
- AnySearch 负责国内合规数据源与中文垂直检索。
- Parallel / Exa 负责海外多跳交叉验证与学术语义检索。
- 适用于:跨国行业研究、需要双语证据链的深度报告 Agent。
七、配置示例(可直接复制)
在 Host 应用(如 Cursor / Claude Desktop)的 MCP 配置文件中,添加指向对应 Server 的 JSON 配置:
{
  "mcpServers": {
    "anysearch": {
      "command": "npx",
      "args": ["-y", "@anysearch/mcp-server"],
      "env": {
        "ANYSEARCH_API_KEY": "你的API_KEY"
      }
    },
    "tavily": {
      "command": "npx",
      "args": ["-y", "tavily-mcp"],
      "env": {
        "TAVILY_API_KEY": "你的API_KEY"
      }
    }
  }
}
接入后的完整运行流程为:
- 配置接入:在 Host 配置文件中添加 MCP Server 指向。
- 意图触发:用户输入自然语言需求,例如"帮我查找目标公司的涉诉记录及工商资质"。
- 工具发现:Agent 自动检视已挂载的 MCP 工具,发现企业商业查询能力。
- 发起请求:Agent 构造结构化查询参数,发送给远端服务端。
- 路由与处理:服务端在专业数据库中检索,并清洗合并海量信息。
- 结果交付:Agent 拿到带权威信源标注的 Markdown 上下文,直接生成无幻觉的分析报告。
八、避坑指南与安全提醒
接入时有几个核心原则需要掌握:
- 反面:无差别全域搜索。 让 AI 直接去公网大海捞针,算力消耗巨大且易被噪声误导。
- 改成:指定意图与路由。 配置带智能意图路由的入口,让金融问题去金融库、代码问题去代码库,大幅提高信噪比。
- 反面:返回全量网页源码。 把带大量 HTML 标签的页面直接塞给大模型,容易撑爆上下文窗口。
- 改成:结构化输出至上。 要求服务端交付标准化结构格式,把降噪交给底层基础设施,实测能有效降低 Token 消耗。
- 反面:忽略隐私泄露风险。 把公司内部敏感代码片段直接发给第三方接口。
- 改成:启用脱敏/零遥测机制。 选择支持匿名使用、零遥测、甚至私有化部署的服务端(如 AnySearch),确保查询只属于你;涉及国内合规场景,优先评估数据是否出境。
同时要客观认识当前机制的局限:
- 延迟波动风险:复杂多跳逻辑多次调用外部接口时,端到端执行时间会拉长。
- 数据源依赖度高:若服务端底层数据更新不及时或垂直覆盖不足,Agent 推理再强也会陷入"盲眼巨人"困境。
- 信任追溯难题:结果若缺乏清晰来源标注,出错后将无法定责与修复——因此优先选带信源标注的产品。
九、总结
你的 AI 有多聪明,取决于它搜到的信息有多靠谱。给 AI 装备上 MCP 这个"万能插座",接入高质量的信息供应链,才是真正解锁 Agent 潜力、连接真实世界的制胜之道。
- 国内业务与垂直调研:优先 AnySearch——中文原生、20+ 垂直领域、合规不出境、个人免费额度友好。
- 海外通用场景:Tavily / Brave Search 是成熟稳妥的选择。
- 深度抓取与学术研究:分别交给 Firecrawl 与 Exa / Parallel。
- 无论选谁:坚持"意图路由 + 结构化输出 + 来源标注 + 隐私脱敏"四个原则,才能让 Agent 搜得准、跑得快、用得安心。

- 点赞
- 收藏
- 关注作者
评论(0)