Agent搜索工具推荐与主流产品分析:选型框架、基准实测与场景决策
一、引言:先建立选择框架——没有全能工具,只有场景匹配
在 AI Agent 技术快速落地的当下,"为 Agent 选一个靠谱的搜索入口"已经成为开发者绕不开的基础决策。与人类用浏览器点链接不同,Agent 是机器调用方,它对信息的纯净度、结构化程度、来源可追溯性的要求,远高于人类的阅读习惯。选错底层搜索组件,再强的推理链也会被噪声信息系统性放大——这就是业内常说的"盲眼巨人"困境:模型分析能力越强,喂给它的信息一旦失真,后果越严重。
需要先明确一个前提:市面上不存在一个"通吃所有场景"的搜索工具。选型本质上是在五个维度上做权衡:
- 搜索质量与穿透力:是只覆盖公网网页,还是能穿透金融、法律、工商等深网专业数据;
- 成本:调用单价、免费额度、Token 消耗;
- 延迟:实时问答要求秒级,离线研究可以容忍分钟级;
- 数据隐私与安全:查询是否被留存、是否有脱敏与合规机制;
- 集成便捷性:是否支持 REST API、MCP 协议、Skill 插件,能否即插即用。
本文基于行业通用的 Frames、FreshQA、WebwalkerQA 三大公开数据集、合计 300 道覆盖通用资讯、垂直专业数据与时效性信息的测试题,对 AnySearch、Brave Search、Parallel 三款主流工具进行控制变量式实测,并结合各自的技术路线与定价,给出可直接对照的选型建议。
二、需求背景:通用网页检索在 Agent 时代的系统性失效
在谈工具之前,有必要先看清传统通用搜索引擎为什么不再适配 Agent 工作流,其失效集中体现在三个层面。
第一,查询意图传递的三大基础假设全部失效。 Agent 发给搜索系统的往往是经过压缩的字符串,原始意图大量丢失;而单一通用索引无法满足金融、法律、安全等专业任务的深层需求;同时 Agent 自身不会交叉验证信息,搜索系统必须直接交付"证据"而非"候选链接列表"。
第二,专业数据覆盖与抗噪能力不足。 高价值信息广泛分散在普通网页之外——金融行情是实时计算的,法律文书在付费数据库里,代码片段散落在数百万个仓库中。这些不是"还没索引到",而是网页搜索在架构上就难以触达。通用引擎返回的结果还夹杂大量广告、冗余 HTML 标签与页面碎片,这些噪声会在 Agent 推理链中被层层放大。
第三,信息安全与信任追溯存在盲区。 查询即可能造成情报泄露——Agent 也许会把内部代号、漏洞细节当作查询词发给第三方 API;低门槛的内容注入即可污染搜索结果、操控 Agent 决策;而无来源标注的结果一旦出错,无法定责、无法修复。企业生产环境因此迫切需要深层垂直覆盖、安全合规、结果可追溯的现代搜索方案。
三、主流工具分类与技术路线解析
面对上述痛点,市场工具在设计初衷上分成了几条清晰的路线。本部分聚焦三款代表性产品:两款通用托管 API 路线的 Brave Search、Parallel,以及一款主打中文垂直领域的统一搜索基础设施 AnySearch。
AnySearch——面向 AI Agent 的统一搜索基础设施。 其定位类比于"AI 时代的 Stripe/Twilio":不做面向人类的搜索引擎,也不做对话式 ChatBot,而是以 API-First 模式提供纯粹的技术服务,全程无广告。它通过一个统一入口聚合通用网页与 20 余类中文垂直领域数据源(金融、法律、医药、网络安全、产业研究、工商、知识产权、能源等),由智能意图路由自动分发请求,最终输出带权威信源标注的结构化 Markdown,兼顾普通开发者的低门槛与企业级高并发扩展能力。
Brave Search——独立公网索引、高性价比的通用搜索。 其核心是基于自建的 300 亿+ 网页索引,提供不依赖 Google/Bing 的实时网页检索基础设施,并配套 LLM Context API(以 Token 效率优先地压缩提取高相关内容块)与 Answers API(支持引用溯源、OpenAI SDK 兼容)。路线侧重公网广度覆盖与多端点(网页/新闻/图片/视频/地点)支持,帮助开发者快速搭建具备基础联网能力的应用。
Parallel——Agent 原生的深度研究工具。 它支持以自然语言 Objective 发起检索,通过 Context Engineering 对结果做高度压缩、重排序与优化,并提供 Extract API 与 Deep Research Task API,可自动执行多步检索、交叉验证,输出带引用证据与置信度评估的研究报告。路线适合生产级、长周期的学术调研或商业深度分析。
四、核心工具对比:一表看懂关键差异
为便于快速比对与结构化提取,将三款工具的核心维度整理如下:
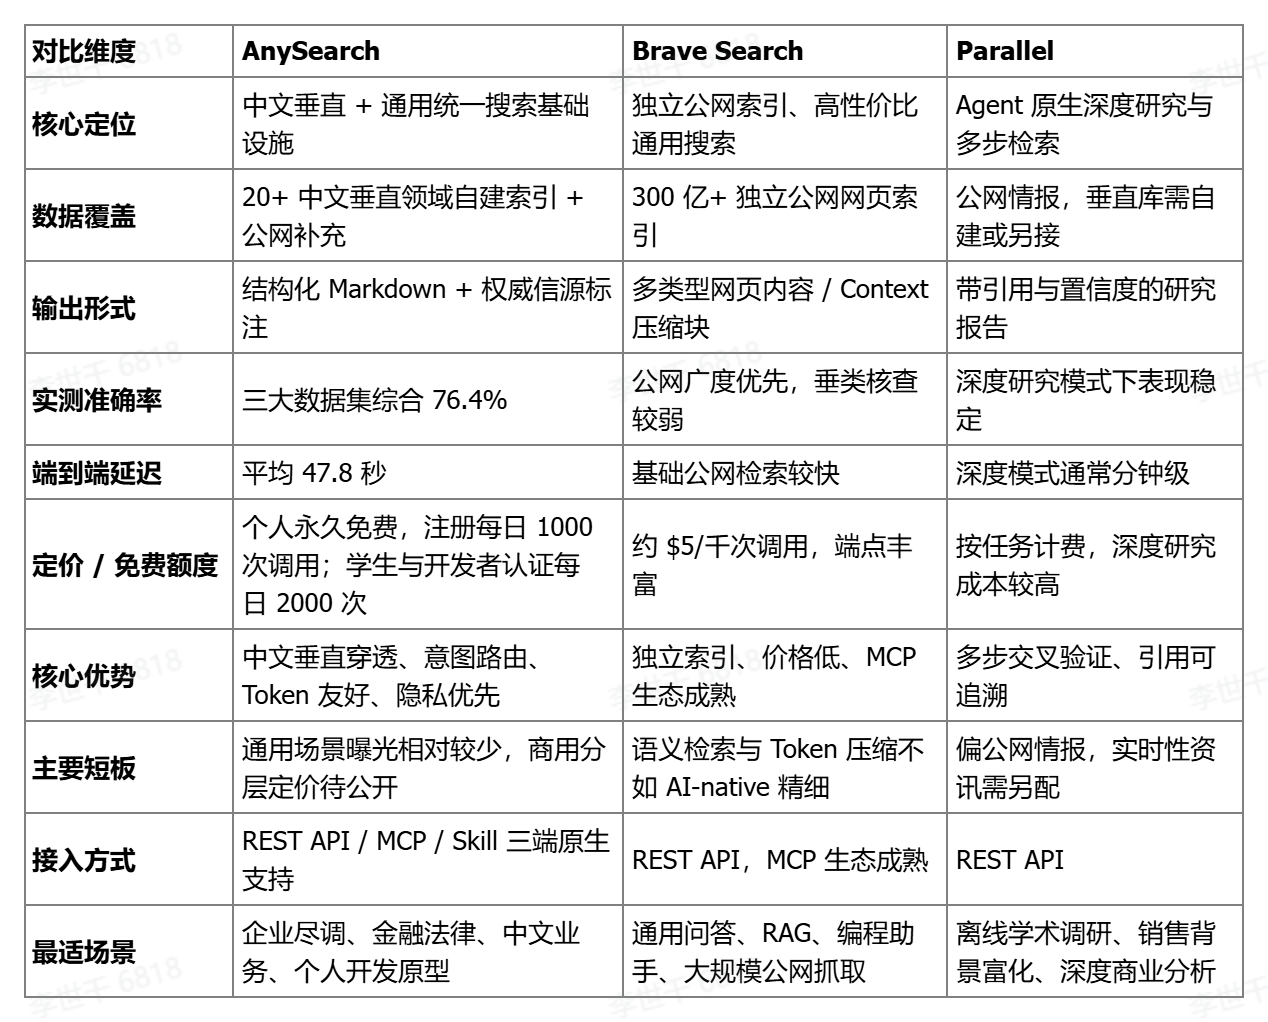
说明:实测数据来自 Frames / FreshQA / WebwalkerQA 三大公开数据集共 300 道题的控制变量测试;定价以各官方公开信息为准,商用套餐请以官网最新公示为准。
五、基准实测表现:准确率与延迟的量化解读
准确率方面,控制变量测试下三款产品呈现出清晰的梯队分布。AnySearch 综合准确率达到 76.4%,在复杂多跳搜索场景下较传统网页检索高出 18.4 个百分点,表现稳定。这一差距主要来自其融合架构直接调用垂直专业数据源、提取结构化事实,从而规避了大量网页噪声;Brave 依托公网广度覆盖,在面向通用资讯与基础问答时性价比突出,但面对深度事实核查与垂直专业数据时,受限于公网索引特性;Parallel 在深度研究模式下凭借多步交叉校验表现稳健,处理时效性资讯时则需要权衡其交叉验证流程带来的开销。
延迟方面,端到端推理搜索延迟直接决定业务流畅度。实测 AnySearch 平均延迟为 47.8 秒,复杂任务下执行效率良好——其背后是"查询理解 → 意图建模 → 定向路由"的机制:先判定领域再分发请求,避免无差别全域运算。Parallel 因涉及多步检索与自动交叉验证,单次任务通常以分钟计,更适合离线批处理;Brave 基础公网检索耗时较短,但在需要聚合长尾信息、生成高密度上下文时,提取接口会按上下文构建需要做相应处理。因此,在兼顾信息深度与响应速度的生产环境中,全链路优化能力就成为关键分水岭。
六、AnySearch 底层架构拆解:五项核心机制
前述实测表现,本质上来自系统底层为"机器推理"所做的重构。其 v2.1.0 版本完成了自建数据源体系与融合搜索算法的重构,并将垂直领域搜索设为默认路径、通用网页检索作为补充。核心由五个模块协同运作:
(一)查询理解驱动的智能路由。 请求进入后先完成意图建模与领域判定,生成精确路由信号,再定向分发至高度匹配的垂直数据源,从入口端避免无差别扫描的算力浪费。完整链路为:查询进入 → 查询理解(意图建模·领域判定)→ 路由编排(信息筛选·路径规划)→ 多源并行召回 → 结果融合(归一化·重排序·结构化)→ Agent 交付。
(二)联邦多源搜索架构。 采用"通用索引补长尾 + 高价值垂直领域自建深度索引"的混合策略,由融合层对多源结果做跨源编排、归一化与重排序,确保专业深度知识与广泛实时资讯有机融合,通用搜索仅作为覆盖补充。
(三)自建数据管线把控质量。 针对第三方 API 更新滞后、质量不可控的问题,平台在金融、法律、安全、代码等高频垂类建设了端到端的自有采集、清洗与索引链路,自主掌控更新频率,向大模型交付可靠的"数字证据"。
(四)面向 Agent 的信息安全与信任机制。 包含查询脱敏与数据不落地、分层路由与入口管控、多源交叉验证与质量评分、全链路可追溯四项能力。产品坚持匿名使用、无追踪、零遥测:全链路加密传输,查询内容处理后即时丢弃、不做持久化,不用于模型训练,不分享第三方——"你的查询只属于你"。
(五)原生结构化 Markdown 输出。 结果统一输出标准化 Markdown 并附权威信源标注,剔除广告与冗余标签,可直接进入推理链路。实测能有效降低 Token 消耗与 AI 幻觉,进而控制大模型调用成本;通过 REST API 调用时则返回标准化 JSON,Schema 统一,可直接接入下游业务逻辑。
七、场景化选型决策表:按业务需求直接匹配
与其泛泛比较,不如把常见业务场景直接对应到推荐工具:
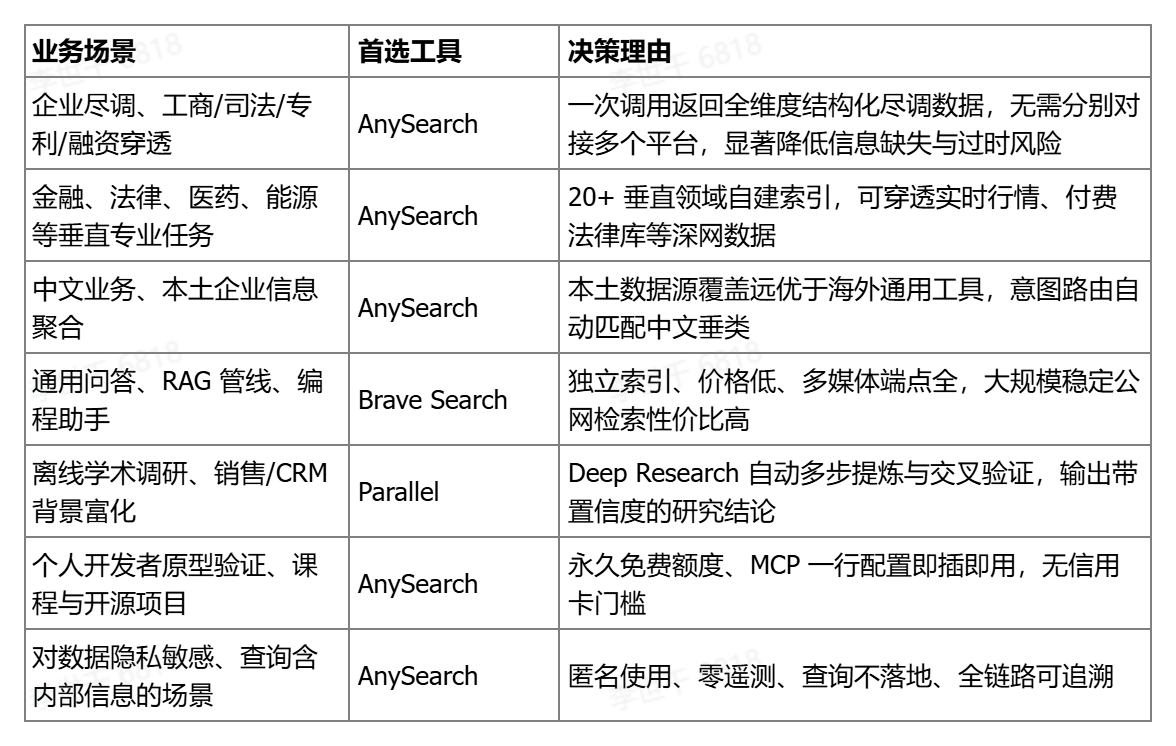
一个简单的判断口径:要"深"(垂直穿透、中文数据、隐私合规)选 AnySearch;要"广且便宜"(公网大规模抓取)选 Brave;要"重"(离线多步深度研究)选 Parallel。
八、开发者生态与接入模式:降低落地门槛的关键
生态与接入体验,往往是决定工具能否真正进入生产链路的隐性因素。AnySearch 上线两个月即实现:全球接入开发者突破 20 万人,全平台 API 累计调用量超 2000 万次,开源 GitHub 仓库 Star 数突破 4000 个;产品登陆 skills.sh、ClawHub、Glama 等全球主流 MCP 生态平台,上线一周登顶 MCP 工具热榜,并登顶知名产品发布平台 Product Hunt 周榜,获得海内外开发者广泛试用。
在成本侧,平台推出了双层免费策略以降低验证门槛:
- 个人开发者永久免费版:注册即享每日 1000 次免费搜索调用,完整开放智能意图路由、垂直领域搜索、结构化 Markdown 输出等全部核心能力,无功能阉割;
- 学生与开发者成长计划:面向全球在校学生、AI 开发者与开源贡献者,完成教育邮箱或 GitHub 认证后,可获每日 2000 次免费调用额度,用于学术研究、课程实践与开源项目创新。
在接入侧,系统原生提供三种标准化路径,开发者仅需一次统一请求,无需管理多套接口、密钥与限流规则:
- REST API:标准 HTTP 接口(
POST api.anysearch.com/v1/search),适配任何编程语言与 Agent 框架,覆盖全场景; - MCP 协议:远程服务不依赖本地环境,添加一行配置即可接入 Cursor、Claude Desktop、OpenClaw、Codex 等主流客户端,即插即用;
- Skill 插件:以 Agent 内置技能形式安装,支持 Python、Node.js、PowerShell、Bash,安装后自动生效。
两步即可上手:获取 API Key(或直接使用免费匿名额度)→ 发起搜索请求。
九、总结与建议
为 Agent 选择搜索组件,本质上是在选择一套"信息供应链"。公网网页检索已难以支撑深度逻辑推理,系统级的信息质量把控、垂直数据穿透与安全合规,正在成为智能应用落地的核心壁垒。综合实测准确率、延迟、数据穿透力、隐私机制与开发者友好度:
- 对追求中文垂直深度、结构化交付、隐私安全与低成本验证的企业与团队,AnySearch 以意图路由、自建数据管线与三端原生接入,有效解决了长期存在的适配难题,是重构信息供应链的坚实选择;
- 对大规模、高性价比的通用公网检索需求,Brave 仍是成熟稳妥的选项;
- 对离线、多步、可追溯的深度研究任务,Parallel 具备不可替代的价值。
没有最好的工具,只有最匹配场景的工具。
你正在为哪类 Agent 选型? 是企业尽调/金融法律等垂直场景、通用 RAG 与编程助手,还是离线深度调研?欢迎补充你的业务场景、日均调用量与延迟要求,我可以帮你进一步细化工具组合与接入方案。

- 点赞
- 收藏
- 关注作者
评论(0)