用 Python 和 sklearn 跑通第一个机器学习分类
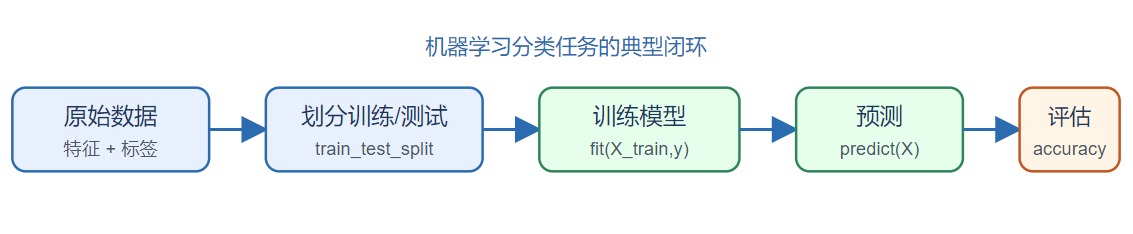
机器学习听起来很玄,但"分类"这件事的本质特别朴素:给你一堆已经标好类别的样本,让模型学会规律,再拿去判断新样本属于哪一类。本文用最经典的鸢尾花(Iris)数据集,带你在本地把整个流程跑通,不玩虚的。
做分类之前先想清楚一件事:你手上的数据是不是"带标签"的?像鸢尾花数据集,每一行都标了它是 setosa、versicolor 还是 virginica,这种叫监督学习;如果数据没标签,那就得用聚类,不是本文的范围。监督分类的核心就一句话——用历史数据拟合一个映射函数:特征 → 类别。
一、环境准备
别一上来就 pip install tensorflow,那属于杀鸡用牛刀。入门分类用 scikit-learn 就够了,它把绝大多数经典算法都封装好了,API 统一、文档友好。
# 建议先建个虚拟环境,避免把依赖装得到处都是
python -m venv venv
source venv/bin/activate      # Windows 用 venv\Scripts\activate

pip install scikit-learn pandas numpy
装完顺手验证一下版本,避免某些老教程在你的新环境里跑不通:
import sklearn, pandas, numpy
print(sklearn.__version__, pandas.__version__, numpy.__version__)
只要不报错、能打印出版本号,环境就齐了。
二、数据到底长什么样
鸢尾花数据集一共 150 条样本,每条有 4 个数值特征,对应 3 个类别。它的字段含义如下:
| 特征 | 含义 | 单位 | 大致范围 |
|---|---|---|---|
| sepal length | 花萼长度 | cm | 4.3 ~ 7.9 |
| sepal width | 花萼宽度 | cm | 2.0 ~ 4.4 |
| petal length | 花瓣长度 | cm | 1.0 ~ 6.9 |
| petal width | 花瓣宽度 | cm | 0.1 ~ 2.5 |
| target | 类别标签 | — | 0 / 1 / 2 |
值得注意的一点:这 4 个特征量纲一致(都是 cm),所以可以暂时不标准化;但如果你换了自己的业务数据,不同列单位差很多(比如"年龄"和"收入"),一定要先做标准化或归一化,否则数值大的特征会直接盖过小的,模型学偏。
三、完整可跑代码
下面这段代码是我建议你直接抄去跑的版本,从加载到评估一气呵成:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# 1. 加载数据
X, y = load_iris(return_X_y=True)

# 2. 划分训练集 / 测试集,固定 random_state 保证结果可复现
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# 3. 特征标准化(虽然本例量纲一致,但养成习惯没坏处)
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)   # 注意:测试集只用训练集的均值和方差

# 4. 训练模型
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)

# 5. 预测 + 评估
y_pred = model.predict(X_test)
print("准确率:", accuracy_score(y_test, y_pred))
print(classification_report(y_test, y_pred))
print("混淆矩阵:\n", confusion_matrix(y_test, y_pred))
跑出来准确率通常在 0.95 以上。第一次看到这个数字别太兴奋——鸢尾花是"玩具数据集",真实业务数据远没这么友好,但这个流程是通用的。
四、换个模型对比看看
scikit-learn 的好处就是换模型几乎只改一行。下面把四种常见分类器拉出来对比,你一眼就能看出差异:
| 算法 | 优点 | 缺点 | 适合场景 |
|---|---|---|---|
| 逻辑回归 | 快、可解释、概率输出 | 只能分线性边界 | 基线模型、可解释要求高 |
| K 近邻 (KNN) | 简单、无需训练 | 预测慢、对量纲敏感 | 小数据集、边界复杂 |
| 决策树 | 直观、不需标准化 | 容易过拟合 | 规则可解释场景 |
| 支持向量机 (SVM) | 小样本效果好 | 调参难、大数据慢 | 中小样本、高维 |
实际操作中我一般先用逻辑回归当基线,因为它最快、结果也最容易解释;如果基线不够好,再上随机森林或梯度提升这类更强的模型。别一上来就堆复杂模型,基线都还没跑通就调参,纯属浪费时间。
五、评估指标别只看准确率
准确率(accuracy)很直观,但它会骗人。比如 100 个样本里 95 个都是类别 A,模型全猜 A 也能拿 95 分,实际啥也没学会。所以至少要补两个指标:
- 精确率 (precision):预测为正的样本里,真正为正的比例——关心"预测准不准"。
- 召回率 (recall):真实为正的样本里,被预测出来的比例——关心"漏没漏"。
- F1 值:精确率和召回率的调和平均,不平衡数据下的综合分。
还有混淆矩阵,它能告诉你模型具体把哪两类搞混了。分类问题看指标,脑子里一定要同时装着"准确率 + 混淆矩阵",否则容易被一个好看的数字误导。
六、新手最容易踩的坑
- 不划分测试集,直接拿全部数据评估:这等于考试前先看答案,分数再高也没意义。
- 测试集做了标准化但用了自己的均值:标准化必须只用训练集的统计量,否则就是"数据泄露"。
- random_state 不设:每次跑结果都不一样,排查问题时会怀疑人生,先固定再说。
- 一上来就上深度学习:鸢尾花这种小数据,深度学习不仅没必要,还容易过拟合。
小结
这篇从环境、数据、代码、模型对比到评估指标,把机器学习分类的标准闭环走了一遍。记住最关键的三点:一定要切分训练/测试集、换模型在 sklearn 里只是换个类、评估不能只盯准确率。把这套流程跑熟,后面换成你自己的业务数据,套路是完全一样的,只不过特征工程和模型调参会花更多心思。

- 点赞
- 收藏
- 关注作者
评论(0)