辛苦开发的页面结果搜不到,用 SSR、预渲染和静态生成给爬虫开了三扇门,提高SEO
做过 SPA(单页应用)的人都遇到过这个场景:本地跑得好好的,上线后去搜索引擎一搜,结果页 snippet 里只有一句"Loading…"或者一堆 JS 变量名。原因很简单——你返回给爬虫的第一份 HTML 里没有正文,正文是浏览器跑完 JS 之后才塞进去的。老一代爬虫不执行 JS,自然抓不到内容。这不是 SEO 玄学,是渲染方式的锅。
一、四种渲染方式,先看清楚差别
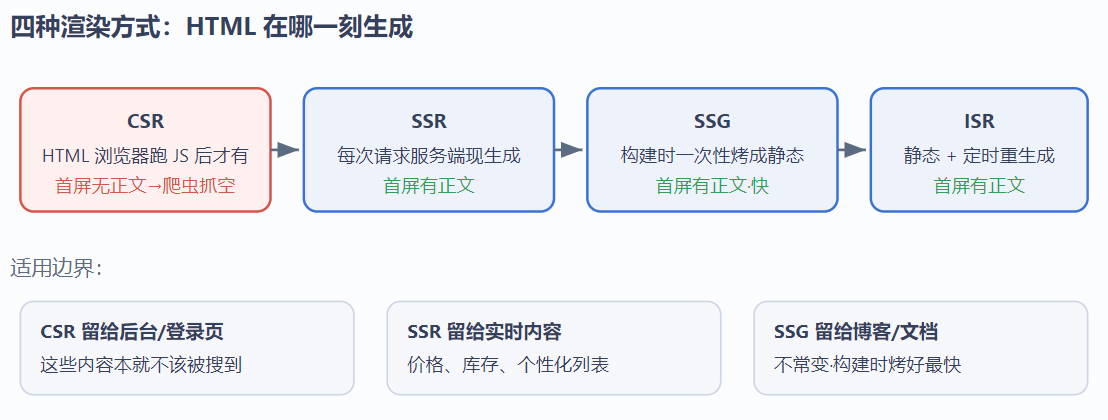
| 方式 | 谁生成 HTML | 首屏有内容吗 | 适合什么 |
|---|---|---|---|
| CSR(客户端渲染) | 浏览器 JS | 否,先白屏后渲染 | 后台系统、登录后才看得到的页面 |
| SSR(服务端渲染) | 服务器每次请求现生成 | 是 | 内容频繁变、要实时性的页面 |
| SSG(静态生成) | 构建时生成 | 是 | 博客、文档、营销页等不常变的内容 |
| ISR(增量静态) | 构建生成 + 定时重新生成 | 是 | 大量页面、偶尔更新 |
CSR 不是不能用,是别把它用在需要被搜到的公开页面上。后台管理系统搜不到无所谓,因为本来就不让搜;但产品介绍页、博客文章如果被 CSR 包了,等于主动放弃了搜索流量。
二、SSR:每次请求都现做一份 HTML
以 Next.js 为例,给页面加一个 getServerSideProps,框架就会在每次请求时于服务端把数据取好、把 HTML 生成好再返回:
// pages/post/[id].js
export async function getServerSideProps({ params }) {
  const res = await fetch(`https://api.example.com/posts/${params.id}`);
  const post = await res.json();
  return { props: { post } };  // 服务端已拿到数据,HTML 里直接有正文
}

export default function Post({ post }) {
  return (
    <article>
      <h1>{post.title}</h1>
      <div dangerouslySetInnerHTML={{ __html: post.content }} />
    </article>
  );
}
爬虫拿到的第一份 HTML 里就已经有 <h1> 和正文了,不用等 JS。代价是每次请求都走一遍服务端,QPS 高时要做好缓存。
三、SSG 和预渲染:构建时就把页面烤好
如果你的内容不常变(比如这篇博客),完全没必要每次请求都现生成。SSG 在构建阶段就把页面渲染成静态 HTML,用户和爬虫拿到的都是现成的文件,速度快还省服务器:
// pages/post/[id].js
export async function getStaticProps({ params }) {
  const post = getPostFromDisk(params.id);  // 构建时从磁盘/CMS 读
  return { props: { post } };
}
export async function getStaticPaths() {
  const ids = getAllPostIds();
  return { paths: ids.map(id => ({ params: { id } })), fallback: false };
}
对于纯 CSR 的老项目,不想大改架构,也可以用预渲染(prerendering):在构建后用无头浏览器把关键路由跑一遍,把生成的 HTML 存下来。相当于给少数公开页面单独"烤"一份快照,其余页面仍是 CSR。这是一种低成本过渡方案。
总结
页面搜不到,根因多半是首屏 HTML 里没有正文,爬虫空手而归。解决思路就是别让公开内容走纯 CSR:实时内容用 SSR 每次现生成 HTML,不常变的内容用 SSG 在构建时烤好,老项目嫌改造大就用预渲染给关键路由存快照。CSR 本身没错,只该留给登录后才看得到的后台页面。选对渲染方式,爬虫拿到的第一份 HTML 就有完整正文,搜索收录自然就上来了。

- 点赞
- 收藏
- 关注作者
评论(0)