多模数据库收敛实践:判断维度、场景边界与混合负载隔离
大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。
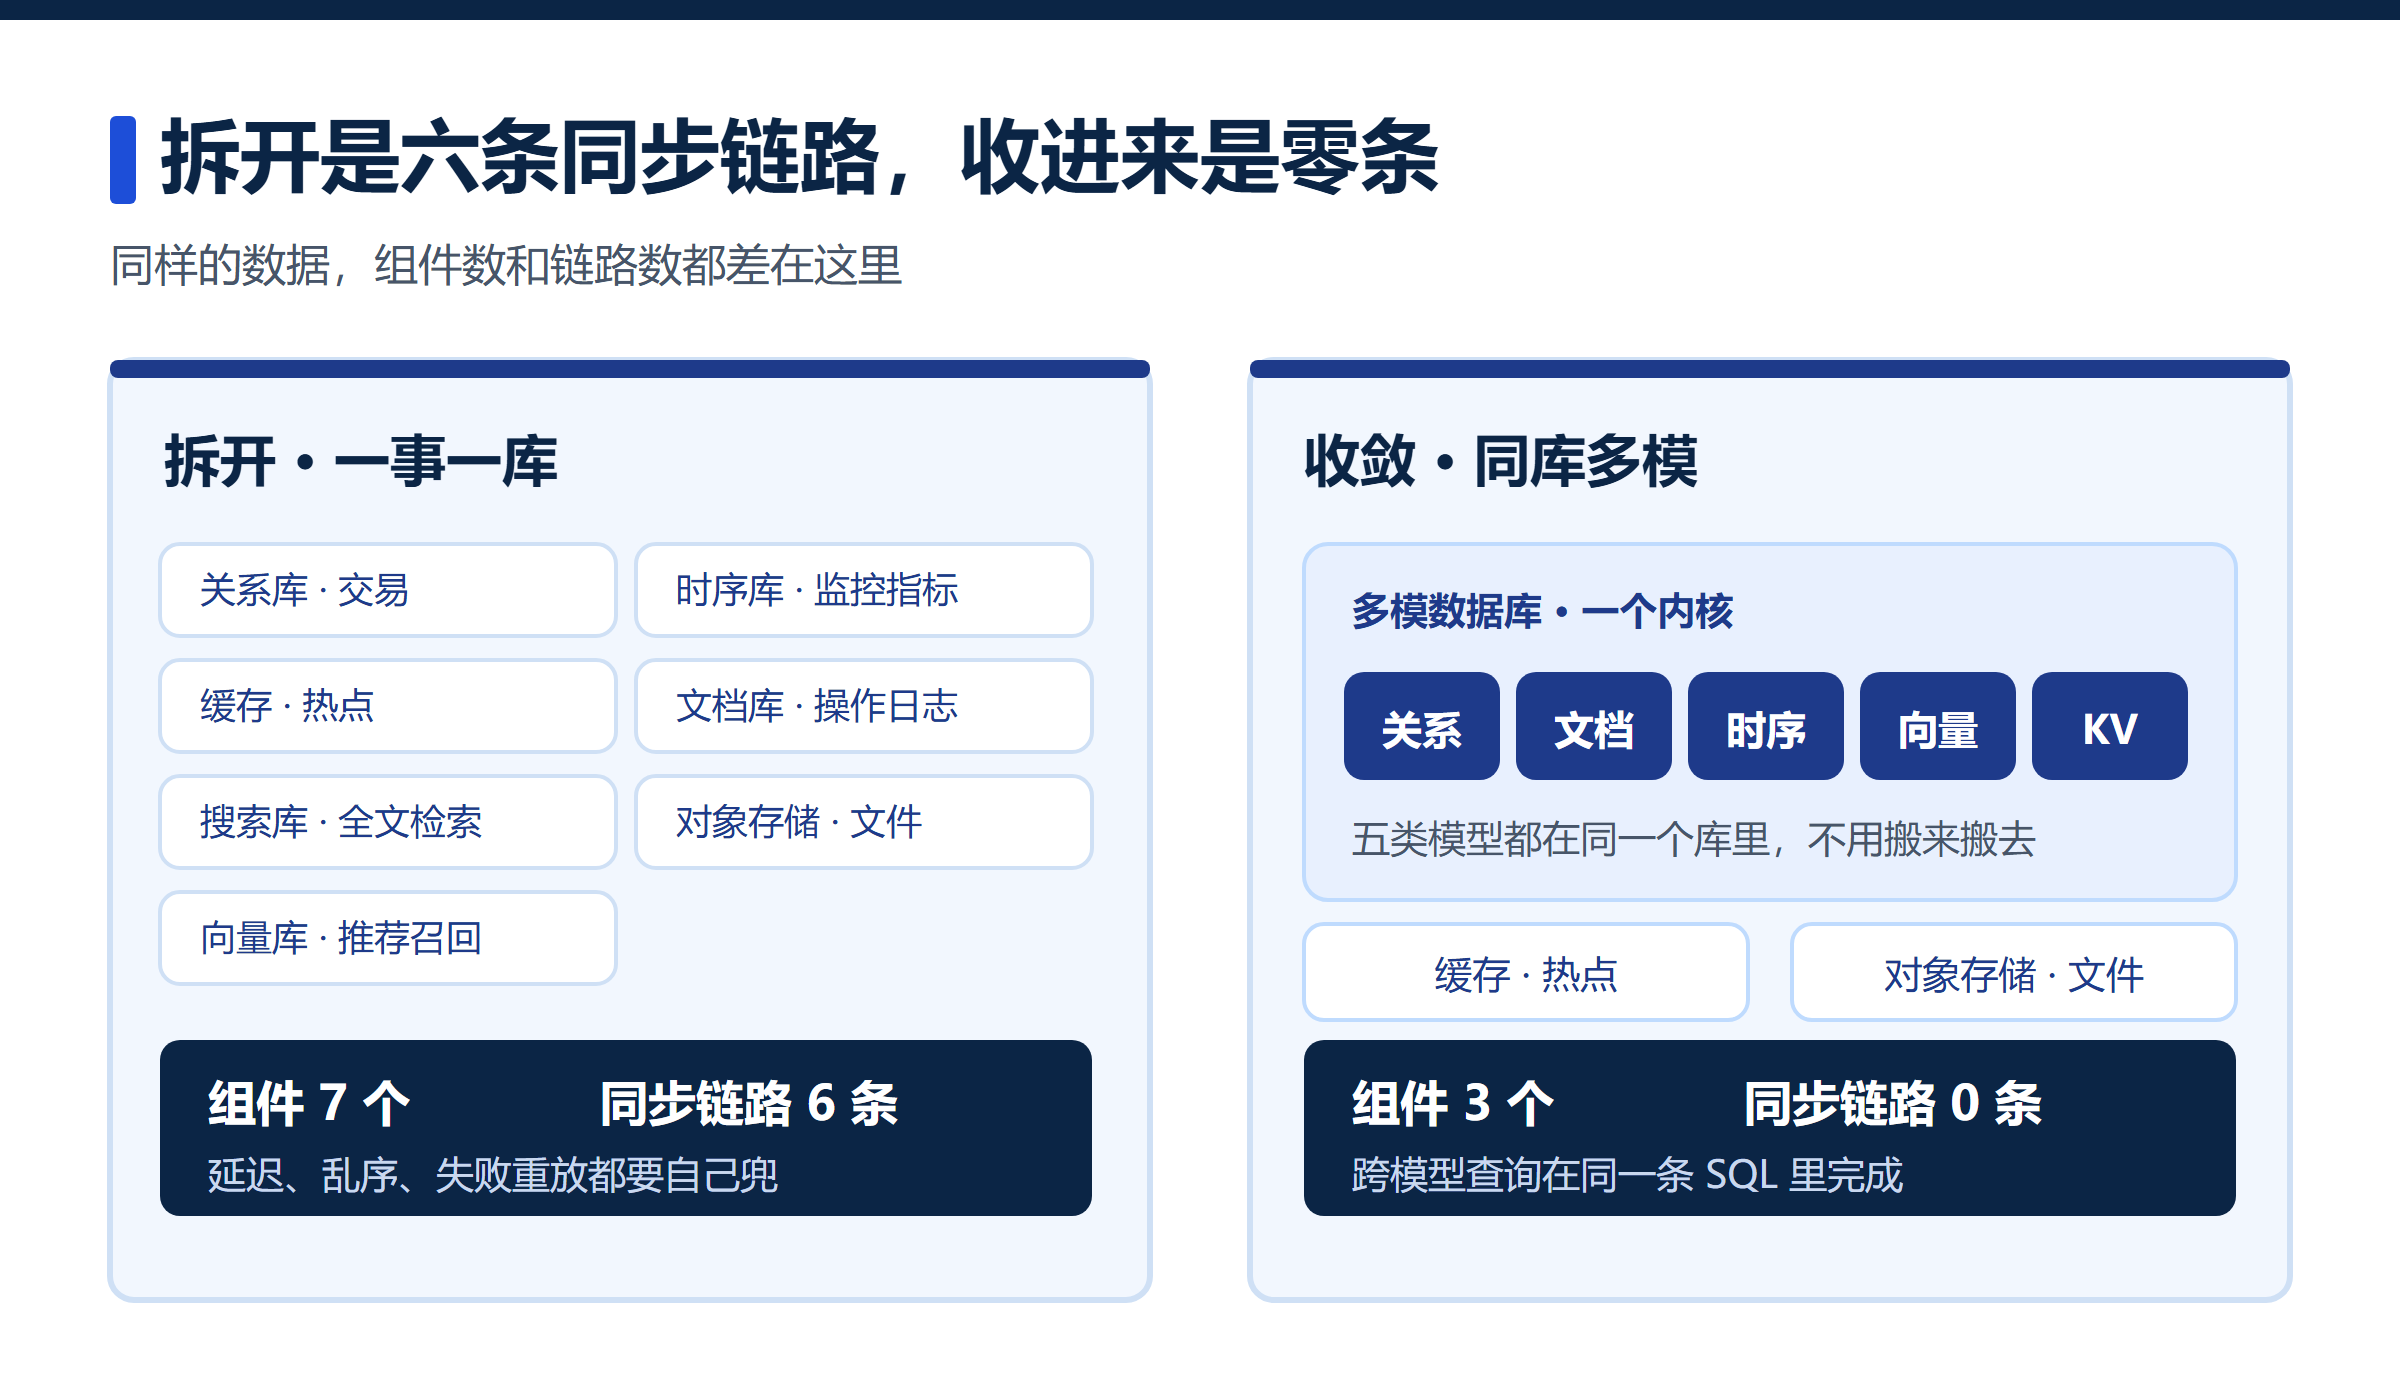
我接手过一个系统,第一件事是数它到底用了多少个数据组件。数出来七个。关系库存交易,缓存存热点,搜索引擎做全文检索。还有一个向量库做推荐召回,一个时序库存监控指标。以及文档库存操作日志,对象存储放文件。
每个组件单拎出来都选得有道理。搜索引擎的倒排索引确实比通用库快,列存的压缩率确实高。问题是这七个东西之间,靠六条同步链路连着。
有一次业务要查一批用户。条件有三个,最近 30 天买过某类商品,给过好评,画像跟种子用户相似。这条需求跨了三个库。关系库出订单,搜索引擎出评价,向量库出相似度。三份结果拉回应用层求交集,代码写了一百多行。上线后发现分页不对。相似度排序没法下推到另外两个库。
那次之后我认真想过一件事。这些数据之间到底需不需要互相看。如果需要,把它们拆在七个地方,是不是反而给自己加了活。
我做过设计,这件事在设计系统里早吵过一轮。每个页面各搞一套按钮,做的时候都挺顺手。后来的结果是,没人能统一改任何一个东西。数据库的技术栈,是同一个故事。
先把话说在前面
我不否定专用库,免得被理解成"专用库都该砍掉"。
单一场景下,专用库确实强。向量索引的召回效率,通用库短时间追不上。列存的压缩比和扫描速度,行存结构比不了。倒排索引做全文检索,也是通用库的弱项。
所以这不是"能不能用"的问题。专用库在它的主场依然是最优解。要讨论的是另一件事。你这个场景,是不是真的需要把数据搬到一个独立的地方去。
判断的起点只有一个。这些数据之间,需不需要互相看。
拆开之后要付的五笔账
为每一种数据模型挂一个独立库,看着是各用各的长处。实际会开出五笔账。
| 代价 | 具体表现 |
|---|---|
| 同步链路 | 每多一个库就多一条 ETL,延迟、乱序、失败重放都要自己兜 |
| 跨库关联 | 跨模型的关联做不了,只能在应用层拼装,拼装次数随维度上升 |
| 运维体系 | 每个库一套备份、监控、扩缩容、升级路径 |
| 技能栈 | 团队要维护 N 套知识,招人、交接、故障找人都是成本 |
| 故障面 | 组件一多,任意一个挂掉都可能断链路,故障组合数成倍上升 |
第一笔账最容易低估。同步链路不是配一次就完了。源库改了表结构,同步任务要跟着改。网络抖一下可能产生乱序,要自己做幂等。链路断了要重放,重放期间两边的数据是不一致的。
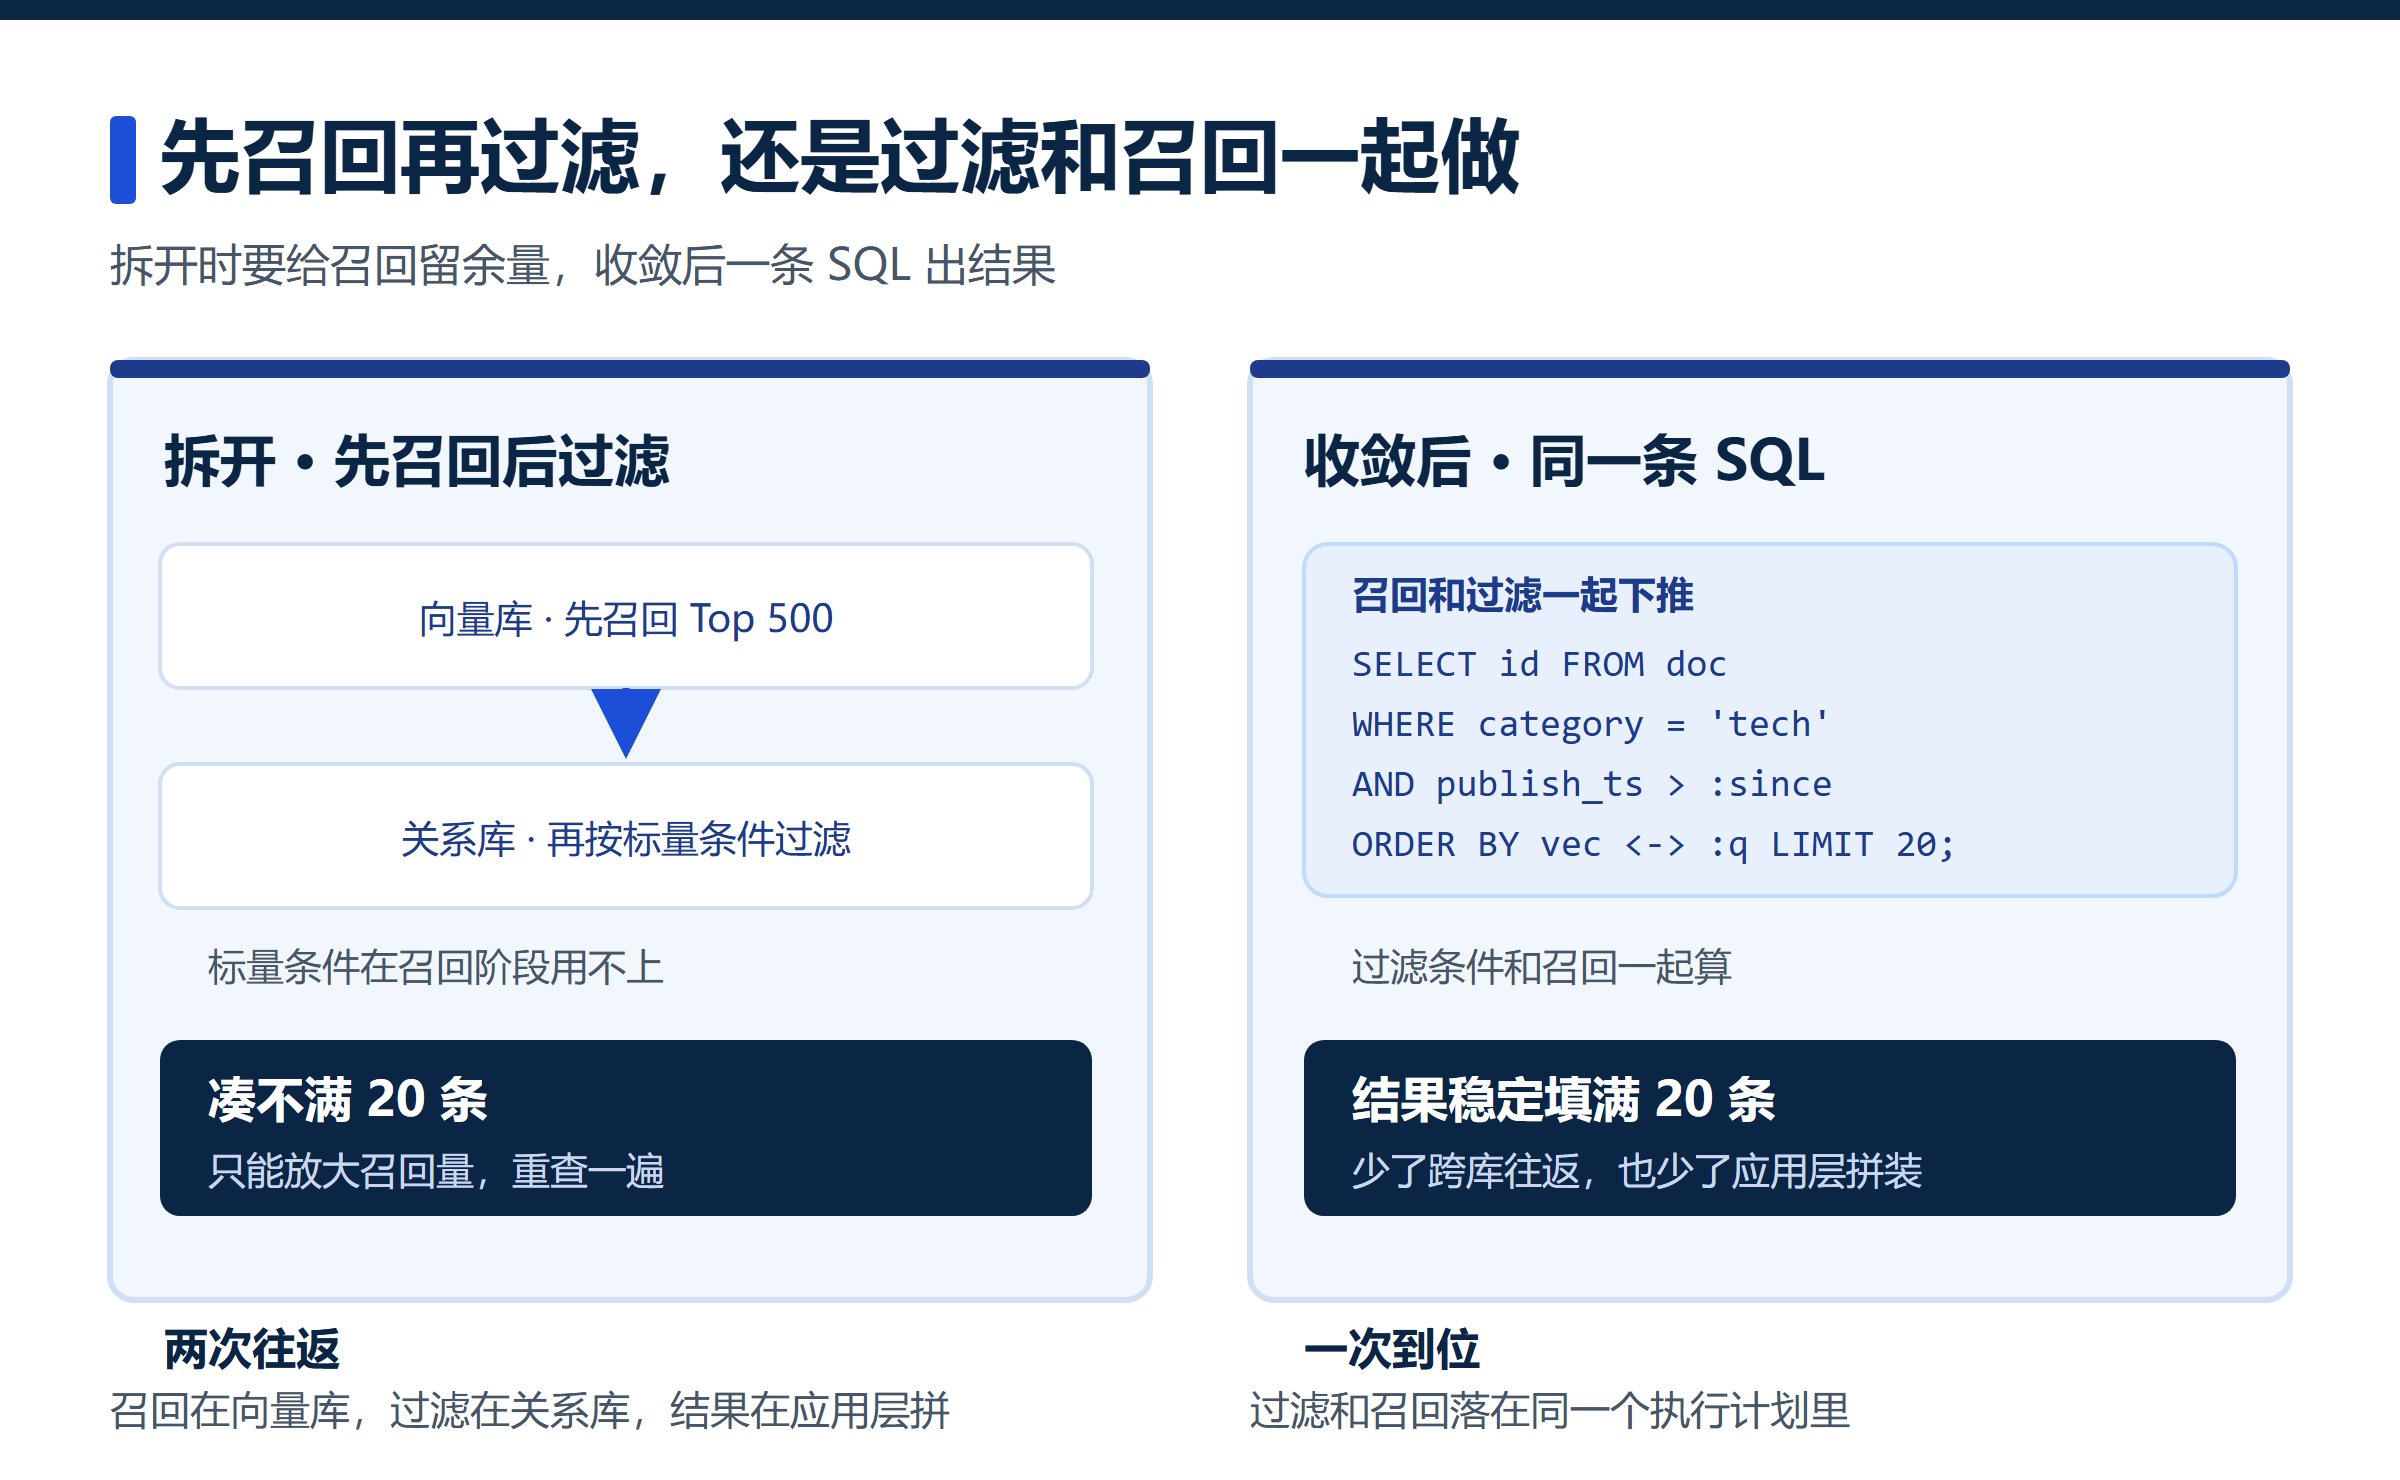
跨库关联这笔,我用前面那个用户查询说透。收敛之后,标量过滤和向量召回可以在一条 SQL 里一起做。
-- 收敛后:标量条件和向量相似度在同一条 SQL 里完成混合过滤
SELECT id, title, embedding <-> :query_vec AS dist
FROM article
WHERE category = 'tech' AND publish_ts > :since
ORDER BY dist
LIMIT 20;
拆开之后,同一件事要分两步。
-- 拆开时:向量库先召回 Top 500,再回关系库过滤标量条件
-- 向量库不认识 category 和 publish_ts,关系库不认识相似度
-- 两次查询加应用层求交集,过滤后可能凑不满 20 条,只能加大召回量重查
这就是常说的先召回后过滤问题。过滤条件越苛刻,那 500 条越不够用。只能把召回量往上抬。召回量一抬,延迟跟着涨。省事的做法是让过滤和召回落在同一个执行计划里完成。
什么该收敛,什么该独立
同一个决策,落到不同的数据上,答案不一样。我一般看四个维度。
| 判断维度 | 倾向收敛 | 倾向独立 |
|---|---|---|
| 要不要跨模型关联 | 经常一起查 | 从来不 join |
| 一致性要求 | 要在事务内一致 | 能接受最终一致 |
| 延迟预算 | 紧,省一次往返有意义 | 松 |
| 团队规模 | 小,维护不起多套 | 大,有人分头管 |
按这四个维度过一遍,我遇到过的场景大致分两类。
该收敛的,是那些跟业务标量数据绑在一起用的模型。向量最典型,检索时几乎总要带业务过滤条件,前面那个例子就是。文档也是,订单里嵌一段 JSON。改状态和改明细要在一个事务里,拆出去就没法保证。时序如果要做设备指标、台账和位置信息的联合分析,也一样。KV 里那些会话和配置,生命周期跟主数据绑定,放同库能省一条同步。
仍该独立的,是两类。一类是极致规模的检索,几亿文档的倒排,专用引擎的分片和压缩压得过通用库。另一类是已经有成熟生态、确实没有关联需求的。团队跑得稳,数据也从来不跟别的东西 join,那就没必要动它。
这类能力在通用数据库里已经不算新鲜。现在不少国产库一个内核就能同时承载关系、文档、时序、向量和 KV,金仓是其中一家。所以真正要判断的,不是引擎有没有,而是你的数据之间要不要互相看。
同库多模的代价,别默认它没问题
收敛不是免费的。把多个模型塞进一个内核,会带来两样东西。
一样是资源争抢。多模同库共用一套缓冲池和 IO。一条分析型的大查询,能把缓冲池占满,把交易查询的命中率拉下来。交易那边的 P99 会跟着抖。这种抖在数据库层面看不出明显异常,得对比两个负载的曲线才发现。
另一样是执行引擎的差异。同一份数据,走交易路径和走分析路径,隔离级别和可见性语义要理清楚。数据在长事务里改了,只读路径什么时候能看到,这个口径要提前定。
隔离手段有三层,都要提前配。资源组把 CPU 和 IO 的配额分开。只读副本把分析流量引过去。连接池分层,交易和分析各走各的池,互相限流。等分析查询把交易打慢再回头加,代价高得多。
收敛前后,账目差在哪
| 对比维度 | 拆开(一事一库) | 收敛(同库多模) |
|---|---|---|
| 一次跨模型查询 | 多次查询加应用层拼装 | 一条 SQL |
| 端到端延迟 | 多一次往返与拼装开销 | 少一次往返 |
| 同步链路 | 六条要维护 | 不需要 |
| 组件数 | 七个 | 三个 |
| 一致性 | 最终一致,受 ETL 延迟影响 | 事务内一致 |
| 运维体系 | 每库一套 | 一套 |
| 隔离要求 | 天然隔离 | 必须手工做资源隔离 |
最后一行是收敛的代价所在。拆开的时候,隔离是免费的,因为本来就分着。收进来之后,隔离要自己搭。
避坑清单
多模同库一定要提前做资源隔离。别等分析查询把交易打慢,才回头去加资源组和只读副本。隔离这件事,事前配置的成本和事后补的成本差好几倍。
别为了收敛把本来无关的数据硬塞进一个库。收敛的前提是数据之间有关系。两份从来不一起查的数据放一起,等于把两个问题合成了一个。
最后一条是我自己搞错的。我第一次做收敛,想着长痛不如短痛,挑了个周末把搜索和向量一起切了进去。周一早高峰就出事了。一条画像分析查询把缓冲池占满,交易那边的 P99 直接翻倍。回退的时候更麻烦,那两天两边都写过,得先把差异补齐才能切回去。后来我改成一次只迁一个模型。迁完观察一个完整的业务周期,隔离和性能都稳了,再动下一个。
写在最后
选型的第一步不是比功能,是先数一遍这些数据之间需不需要互相看。需要互相看,就不该拆开。确认真不需要,独立部署才成立。
收敛是一个方向,不是一个动作。它值不值得做,取决于你的数据之间的关系有多密。关系密的,收进来省事。关系松的,硬收只是给自己找麻烦。
所以我现在看技术栈,先画一张数据关系图,再决定哪个库该留、哪个该并。顺序反了,收完还得拆。
你手上的系统,跑着几个数据组件?评论区聊聊。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋

- 点赞
- 收藏
- 关注作者
评论(0)