openGauss日常运维指南:备份恢复与故障快速处理实战

📝 文章摘要:数据库运维的核心不是出了问题能修,而是出了问题能最快恢复。本文汇总了 openGauss 集群日常运维中最常见的场景:备份恢复策略、健康巡检脚本、磁盘写满处理、主备切换后修复、慢查询应急等。所有操作都是运维团队在过去一年中反复踩坑后的总结,每一条都有实际发生过的事故作为背景。
⏱ 预计阅读时间:15 分钟
🎯 运维哲学:高可用不是靠运气,是靠预案
我们团队有个原则:任何故障的恢复步骤,都必须写成脚本,并且每季度演练一次。
过去一年,openGauss 集群经历了:
| 故障类型 | 发生次数 | 平均恢复时间 | 有无预案 |
|---|---|---|---|
| 磁盘写满 | 2 | 8min | ✅ 有 |
| 主备切换后原主库重搭 | 3 | 15min | ✅ 有 |
| 慢查询导致连接池打满 | 4 | 5min | ✅ 有 |
| WAL 损坏 | 1 | 45min | ❌ 无 → 事后补了 |
下面把经过验证的运维脚本和流程都放出来。
📦 备份策略
全量备份(每周)
#!/bin/bash
# /opt/scripts/full_backup.sh — 每周日凌晨 2:00 执行

BACKUP_DIR="/data/backup/full"
DATE_TAG=$(date +%Y%m%d_%H%M%S)
BACKUP_PATH="${BACKUP_DIR}/${DATE_TAG}"
RETENTION_DAYS=30

mkdir -p $BACKUP_PATH

# 执行全量备份
gs_basebackup -D $BACKUP_PATH \
    -h localhost -p 5432 -U backup_user \
    -X stream -z -P -v \
    --label="full_backup_${DATE_TAG}"

if [ $? -eq 0 ]; then
    echo "[OK] 全量备份完成: ${BACKUP_PATH}"
    # 备份大小统计
    du -sh $BACKUP_PATH
else
    echo "[ERROR] 全量备份失败"
    exit 1
fi

# 清理旧备份
find $BACKUP_DIR -maxdepth 1 -type d -mtime +$RETENTION_DAYS -exec rm -rf {} \;
增量备份(每天)
WAL 归档已经每 5 分钟做一次(见前面容灾篇),这里不再重复。
备份验证
备份不可恢复 = 没有备份。
#!/bin/bash
# /opt/scripts/verify_backup.sh — 每次全量备份后执行

LATEST_BACKUP=$(ls -td /data/backup/full/*/ | head -1)
VERIFY_DIR="/tmp/backup_verify"

# 清理旧的验证目录
rm -rf $VERIFY_DIR
mkdir -p $VERIFY_DIR

# 解压备份文件
tar -xzf ${LATEST_BACKUP}/base.tar.gz -C $VERIFY_DIR

# 启动验证实例(使用临时端口)
gs_ctl init -D $VERIFY_DIR -X
gs_ctl start -D $VERIFY_DIR -p 15432 -o "-c port=15432"

# 验证数据完整性
gsql -p 15432 -d postgres -c "SELECT count(*) FROM orders;"
gsql -p 15432 -d postgres -c "CHECKPOINT;"

# 关闭验证实例并清理
gs_ctl stop -D $VERIFY_DIR
rm -rf $VERIFY_DIR

echo "[OK] 备份验证通过"
💥 踩坑:全量备份只保留一份,坏了才意识到
第一次做备份策略时,我们只保留了一份全量备份。结果磁盘坏了,备份跟主库一起没了。
修复:全量备份要满足 3-2-1 原则 —— 3 份副本、2 种介质、1 份离线(异地)。
# 新增异地备份
OBS_BUCKET="obs://company-db-backup"
BACKUP_FILE="${DATE_TAG}.tar.gz"

# 压缩后上传到 OBS
tar -czf /tmp/$BACKUP_FILE -C $BACKUP_PATH .
obsutil cp /tmp/$BACKUP_FILE ${OBS_BUCKET}/full/ --acl-private
🔍 健康巡检脚本
每天早上 8:00 自动跑一遍,有问题提前发现。
#!/bin/bash
# /opt/scripts/health_check.sh — 每日巡检

PGHOST="localhost"
PGPORT="5432"
PGUSER="monitor"
PGDB="postgres"
REPORT_FILE="/tmp/db_health_$(date +%Y%m%d).html"

echo "<html><body><h2>openGauss 巡检报告: $(date)</h2>" > $REPORT_FILE

# 1. 数据库连接
echo "<h3>1. 连接状态</h3>" >> $REPORT_FILE
CONN_COUNT=$(gsql -h $PGHOST -p $PGPORT -U $PGUSER -d $PGDB \
    -t -c "SELECT COUNT(*) FROM pg_stat_activity WHERE state = 'active';" | tr -d ' ')
echo "<p>活跃连接数: ${CONN_COUNT} / ${MAX_CONN}</p>" >> $REPORT_FILE

# 2. 复制状态
echo "<h3>2. 复制状态</h3>" >> $REPORT_FILE
gsql -h $PGHOST -p $PGPORT -U $PGUSER -d $PGDB \
    -t -c "SELECT application_name, sync_state, write_lag, replay_lag
           FROM pg_stat_replication;" >> $REPORT_FILE

# 3. 表膨胀率
echo "<h3>3. 表膨胀检查</h3>" >> $REPORT_FILE
gsql -h $PGHOST -p $PGPORT -U $PGUSER -d $PGDB <<SQL >> $REPORT_FILE
    SELECT schemaname, tablename,
        ROUND(100 * n_dead_tup / GREATEST(n_live_tup + n_dead_tup, 1), 2) AS dead_pct
    FROM pg_stat_user_tables
    WHERE n_dead_tup > 0
    ORDER BY dead_pct DESC
    LIMIT 20;
SQL

# 4. 磁盘使用率
echo "<h3>4. 磁盘使用率</h3><pre>" >> $REPORT_FILE
df -h /data >> $REPORT_FILE
echo "</pre>" >> $REPORT_FILE

# 5. 慢查询(过去 1 小时)
echo "<h3>5. 过去 1 小时慢查询(> 1s)</h3>" >> $REPORT_FILE
gsql -h $PGHOST -p $PGPORT -U $PGUSER -d $PGDB \
    -t -c "SELECT query, total_time / calls AS avg_ms, calls
           FROM pg_stat_statements
           WHERE query_start > now() - interval '1 hour'
             AND total_time / calls > 1000
           ORDER BY total_time DESC LIMIT 10;" >> $REPORT_FILE

# 6. 未使用索引
echo "<h3>6. 未使用的索引</h3>" >> $REPORT_FILE
gsql -h $PGHOST -p $PGPORT -U $PGUSER -d $PGDB \
    -t -c "SELECT schemaname, tablename, indexrelname, idx_scan
           FROM pg_stat_user_indexes
           WHERE idx_scan = 0
           ORDER BY tablename;" >> $REPORT_FILE

echo "</body></html>" >> $REPORT_FILE

# 发送报告
mail -s "openGauss 巡检报告 $(hostname) $(date +%Y-%m-%d)" \
    -a $REPORT_FILE dba@company.com
💥 磁盘写满应急
现象
# 突然所有写入失败
ERROR:  could not write to file "pg_wal/xxx": No space left on device
应急步骤
#!/bin/bash
# /opt/scripts/disk_full_emergency.sh

echo "[$(date)] 磁盘写满紧急处理"

# 1. 快速腾空间:删除最旧的 WAL 归档
find /data/opengauss/archive/ -name "*.gz" -mtime +7 -delete
echo "[STEP 1] 清理 7 天前的 WAL 归档..."

# 2. 如果还不够,清理审计日志
find $PGDATA/pg_audit/ -name "*.csv" -mtime +30 -delete
echo "[STEP 2] 清理 30 天前的审计日志..."

# 3. 查看磁盘空间
df -h /data
echo "[STEP 3] 请确认磁盘使用率已下降..."

# 4. 检查是否有大文件可以清理
du -sh $PGDATA/pg_wal/
du -sh $PGDATA/pg_log/
预防措施
# 磁盘使用率超过 80% 自动告警
# 已经在日志篇的脚本里配置了
# 加上自动清理策略
💥 踩坑:rm 删了 WAL 文件却没释放空间
# 删了 pg_wal 下的文件
rm $PGDATA/pg_wal/0000000100000000000000AB

# 但磁盘空间没释放!
# 原因是 WAL 文件被 openGauss 进程打开了
正确做法:
# 方式 1:重启数据库(会重新创建 WAL 文件,但会造成中断)
gs_ctl restart -D $PGDATA

# 方式 2:让 openGauss 自己回收(触发 checkpoint)
gsql -d postgres -c "CHECKPOINT;"
gsql -d postgres -c "SELECT pg_switch_wal();"
或者直接 truncate 而不是 rm:
# 不安全但紧急时可用的办法
: > $PGDATA/pg_wal/0000000100000000000000AB  # 清空但不删除文件句柄
🔧 主备切换后修复
Keepalived 切换后,原主库恢复后需要作为备库重新加入集群。
#!/bin/bash
# /opt/scripts/rejoin_as_standby.sh

OLD_MASTER_IP="192.168.100.10"
NEW_MASTER_IP="192.168.100.20"
PGDATA="/data/opengauss/data"

echo "[$(date)] 将原主库重建为备库..."

# 1. 确认原主库不是主库状态
HOST=$OLD_MASTER_IP   # 或者本机
IS_IN_RECOVERY=$(gsql -h $HOST -U omm -d postgres \
    -t -c "SELECT pg_is_in_recovery();" | tr -d ' ')

if [ "$IS_IN_RECOVERY" = "f" ]; then
    echo "当前节点是主库,需要先停掉..."
    gs_ctl stop -D $PGDATA
fi

# 2. 备份原数据目录
mv $PGDATA ${PGDATA}_old_$(date +%Y%m%d)

# 3. 从新主库重建
mkdir -p $PGDATA
gs_ctl build -D $PGDATA -M standby \
    -h $NEW_MASTER_IP -p 5432 -U omm

if [ $? -eq 0 ]; then
    echo "[OK] 备库重建完成"
    gs_ctl start -D $PGDATA
else
    echo "[ERROR] 备库重建失败,恢复旧目录"
    rm -rf $PGDATA
    mv ${PGDATA}_old_* $PGDATA
fi
🐌 慢查询应急
当慢查询导致连接池打满时,不要谈"优化"——先止血。
-- 1. 找到打满连接池的"凶手"
SELECT pid, state, now() - query_start AS duration,
       LEFT(query, 100) AS short_query
FROM pg_stat_activity
WHERE state = 'active'
ORDER BY duration DESC
LIMIT 20;

-- 2. 干掉它(确信这是罪魁祸首后)
SELECT pg_terminate_backend(pid)
FROM pg_stat_activity
WHERE state = 'active'
  AND now() - query_start > interval '30 seconds'
  AND pid <> pg_backend_pid();

-- 3. 创建索引(如果缺失索引是根因)
CREATE INDEX CONCURRENTLY idx_orders_status_created
ON orders(status, created_at);
紧急限流
# 临时降低最大连接数(防止新的慢查询涌入)
gs_guc reload -D $PGDATA -c "max_connections = 200"  # 原值 500

# 等慢查询处理后,恢复
gs_guc reload -D $PGDATA -c "max_connections = 500"
📊 日常巡检表
--- 每日巡检 ---
□ 数据库运行状态(pg_isready)
□ 复制延迟(write_lag < 1s)
□ 磁盘使用率(< 80%)
□ 表膨胀率(dead tuple < 20%)
□ 过去 1 小时慢查询
□ 备份任务执行状态

--- 每周巡检 ---
□ 全量备份验证(恢复到一个测试实例)
□ 检查未使用的索引(idx_scan = 0 的可以考虑删除)
□ 检查缺失的索引(通过 pg_stat_statements 分析)
□ 检查异常增长的表

--- 每月巡检 ---
□ 主备切换演练(至少每季度一次)
□ WAL 目录清理情况
□ 审计日志归档与清理
□ 运行日志归档与清理
□ 备份异地同步验证
❓ 常见问题
Q1:gs_ctl build 重建备库需要多长时间?
跟数据量成正比。我们 800GB 的全量数据,从主库拉取大约需要 40-60 分钟(1Gbps 内网)。重建期间不影响主库运行。
Q2:巡检发现表膨胀率超过 50% 怎么办?
-- 手动 VACUUM
VACUUM (VERBOSE, ANALYZE) orders;

-- 如果有大量死元组且 VACUUM 不够快,考虑
-- 1. 调整 autovacuum_vacuum_scale_factor
-- 2. 增加 autovacuum 工作进程
ALTER TABLE orders SET (autovacuum_vacuum_scale_factor = 0.01);
Q3:慢查询 kill 掉之后怎么防止它马上又跑起来?
kill 只是治标,治本需要:
# 在数据库层加黑名单
# postgresql.conf
# curtail_functions 参数可以限制某些函数的执行
# 但更直接的方式是在应用中熔断
我们在 APM 系统里做了 SQL 级别的熔断:如果某个 SQL 连续 3 次执行超过 5 秒,自动加入黑名单 10 分钟。
Q4:全量备份失败了怎么办?
先看错误原因。最常见的是磁盘空间不足。紧急方案:
# 如果全量备份来不及,至少先用 gs_dump 导出逻辑备份
gs_dump -h localhost -p 5432 -U backup_user -F c \
    -f /tmp/emergency_backup.dump -d order_db
逻辑备份虽然恢复慢,但总比没有强。
✅ 运维清单自查
□ 全量备份(每周)+ 自动上传 OBS
□ WAL 归档(每 5 分钟)+ 自动清理 7 天前归档
□ 备份验证(每次全量备份后恢复到测试实例)
□ 每日健康巡检脚本 + 邮件报告
□ 磁盘使用率监控告警(80% / 90% / 95% 三级)
□ 复制延迟监控告警(> 10s)
□ 慢查询自动捕获与告警(> 5s)
□ 主备切换演练脚本(含 rejoin)
□ 原主库重建备库脚本
□ OOM 应急脚本(清理空闲连接)
□ 磁盘写满应急脚本
🔄 日常运维巡检流程
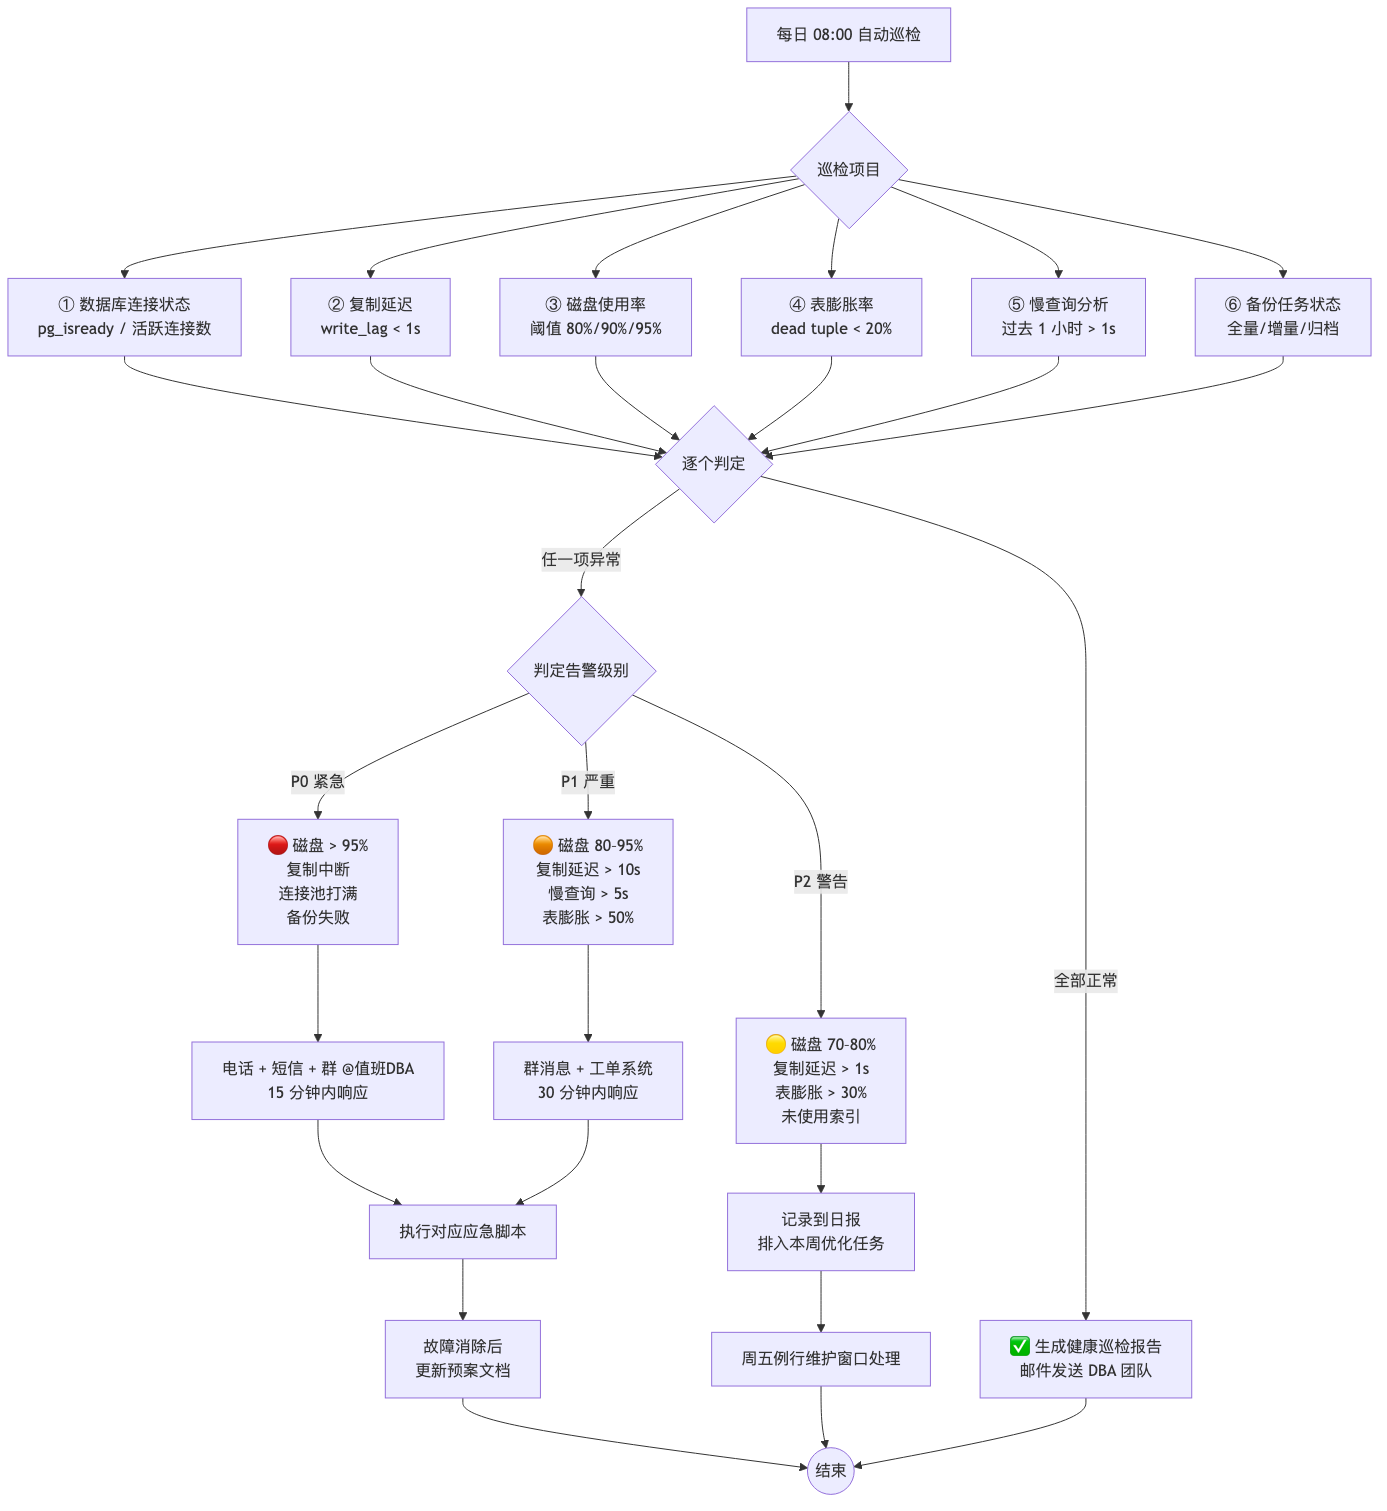
🔀 故障恢复方案选择决策树

📝 总结
从 DBA 的角度看 openGauss 的运维,跟 MySQL 没有本质区别。核心就是三件事:
备份要能恢复(不能恢复的备份等于没有,每个备份都要验证)、监控要能提前发现问题(等出事了再查日志就晚了)、预案要经过演练(没演练过的预案等于没有)。
再好的架构也扛不住运维疏忽。做好上面这些,openGauss 的生产运维是可以很安心的。
数据库篇到这里就全部结束了。从下一篇开始,我们将进入操作系统与基础设施篇 —— CentOS 停服在即,如何安全迁移到 openEuler?
💬 互动:你的数据库运维生涯中,最惊险的一次故障是什么?用了多长时间恢复?

- 点赞
- 收藏
- 关注作者
评论(0)