用Loki把服务日志收拢查询的方案
【摘要】 机器一多,tail 日志就不现实了;上 ELK 又觉得重。这篇用 Loki + Promtail + Grafana 搭一套轻量日志方案:Promtail 在各机采集、Loki 按标签存、Grafana 用 LogQL 查,重点讲清标签模型、查询语法和几个容易踩的坑。
服务一多,查问题就变成"先 ssh 到哪台机器、再 tail 哪个文件",几台还好,几十台就别想了。很多人第一反应是上 ELK,但 ELK 对中小团队偏重。后来我用了 Loki,它的思路很取巧:只索引标签、不索引全文,成本低、和 Prometheus/Grafana 同一套生态。这篇把最小可用的玩法讲清楚。
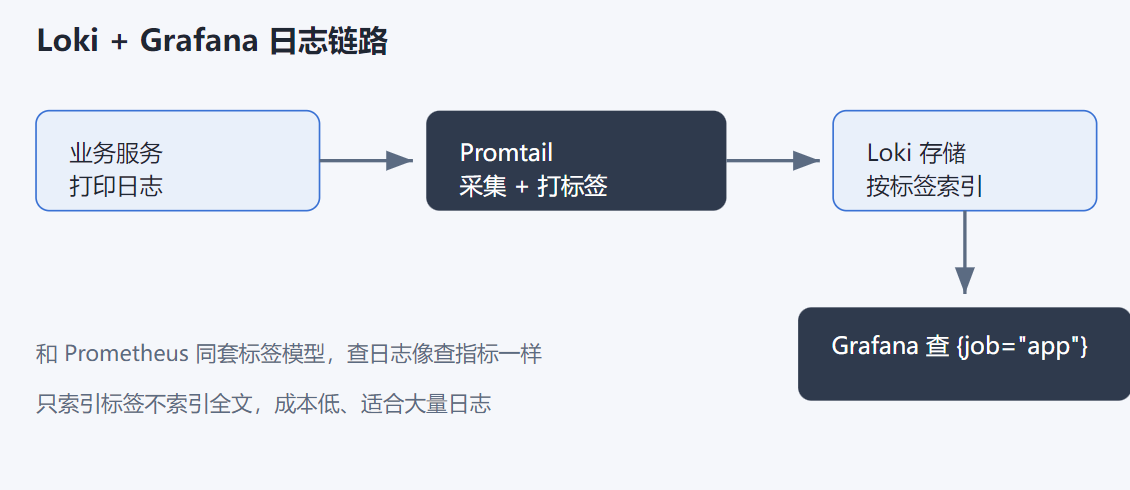
一、三个组件各管啥
- Promtail:部署在被采集机器上,读日志文件、打上标签(job、app 名),推给 Loki。
- Loki:接收并存储,按标签建索引。
- Grafana:连上 Loki 数据源,用 LogQL 查询、画面板。
最快的起法是用 docker-compose 一把拉起 Loki + Promtail + Grafana,本地就能调通。
二、Promtail 怎么配
核心是 scrape_configs,告诉它"盯哪些文件、打什么标签":
scrape_configs:
  - job_name: app
    static_configs:
      - targets: [localhost]
        labels:
          job: app
          app: order-service
          __path__: /var/log/order/*.log
__path__ 是 Promtail 约定的字段,表示要采集的文件路径;其余标签(job、app)会跟着每条日志走,后面查询就靠它们过滤。
三、在 Grafana 里查
连好 Loki 数据源后,查询框里写 LogQL。最基础:
{job="app", app="order-service"}
只看 error 级别,用管道过滤:
{job="app"} | json | level="error"
| json 会把日志当成 JSON 解析出字段,level="error" 再过滤。要算每分钟错误数:
count_over_time({job="app"} | json | level="error" [1m])
Loki 和 ELK 的取舍:
| 维度 | Loki | ELK |
|---|---|---|
| 索引方式 | 只索引标签 | 全文索引 |
| 存储成本 | 低 | 高 |
| 查询语言 | LogQL | KQL/Lucene |
| 生态 | 与 Prometheus/Grafana 一体 | 自成体系 |
| 全文模糊搜 | 弱(靠标签+管道) | 强 |
所以 Loki 适合"按服务/级别快速定位日志",如果你要做全文内容检索,ELK 仍更合适。
几个容易踩的
- label 别打太多太细。比如把
user_id当标签,基数爆炸,Loki 索引会撑爆。标签只放"有限枚举"的维度(服务名、环境、级别),用户级维度放日志内容里用管道查。 - 只索引标签意味着全文搜弱。别指望
|= "某段罕见文本"很快,它本质是在标签过滤后的结果里做行内匹配。定位思路应该是"先用标签缩小范围,再在结果里搜"。 - 保留期要设。Loki 存多久、多大,配置里定好,不然磁盘慢慢被日志吃满。
- 时钟要同步。多机日志靠时间排序,机器时间差太多,查出来的顺序会乱,NTP 同步别省。
Loki 的价值在于"轻量地把分散日志聚起来、用标签快速筛"。它不是 ELK 的替代品,但对多数"按服务查日志"的场景已经够用,还顺手和你的 Prometheus 监控共用一套 Grafana。先把 Promtail 标签打对,后面查询就顺了。

【声明】本内容来自华为云开发者社区博主,不代表华为云及华为云开发者社区的观点和立场。转载时必须标注文章的来源(华为云社区)、文章链接、文章作者等基本信息,否则作者和本社区有权追究责任。如果您发现本社区中有涉嫌抄袭的内容,欢迎发送邮件进行举报,并提供相关证据,一经查实,本社区将立刻删除涉嫌侵权内容,举报邮箱:
cloudbbs@huaweicloud.com
- 点赞
- 收藏
- 关注作者
评论(0)