Jev 与概率校准:AI 决策系统该怎么测试?
摘要:
Jev 最大的特点之一,不只是输出“答案”,还会给出概率和置信度。
这也带来了一个新的测试问题:
模型说自己有 95% 把握,它真的有 95% 那么可靠吗?
当 AI 开始直接参与分类、路由、风险判断和业务决策以后,测试工程师要验证的,已经不只是“结果对不对”,还包括:
AI 到底知不知道自己什么时候可能会错。
一、AI 判断正确,不代表它值得信任
假设我们用 Jev 判断自动化测试失败原因。
它返回:
代码问题:95%
环境问题:3%
数据问题:2%
最终答案是“代码问题”。
而真实情况也确实是代码 Bug。
如果按照传统测试思路,这次判断:
Pass。
但如果放到真正的 AI 系统里,还不够。
因为 Jev 不仅告诉我们:
我认为是代码问题。
它还告诉我们:
我有 95% 的把握。
这时候测试对象就多了一层:
这个 95%,到底可信吗?
假设我们找出 100 个 Jev 都声称自己有“95% 把握”的案例。
结果实际只有 70 个判断正确。
那意味着什么?
模型虽然不少时候能选对答案,但是:
它严重高估了自己的判断能力。
这就是 AI 决策系统里一个非常重要的问题:
概率校准,Probability Calibration。
二、为什么 Jev 特别强调“置信度”?
TypeSafe 在发布 Jev 时,把训练方法称为:
RLCD——Reinforcement Learning for Calibrated Decisions。
和传统大语言模型更强调生成质量不同,Jev 的目标之一,就是让模型输出类型化决策的同时,也给出相应的概率和置信度。
TypeSafe 对理想状态的描述很直接:
置信度越高,实际准确率也应该越高。
比如:
模型说 60% 确定
→ 长期来看,大约应该有 60% 判断正确

模型说 80% 确定
→ 长期来看,大约应该有 80% 判断正确

模型说 95% 确定
→ 长期来看,应该接近 95% 判断正确
这件事情为什么重要?
因为企业系统真正需要的不是一个:
“永远假装自己很确定的 AI”。
而是一个能够告诉程序:
这件事情我很有把握,可以自动处理。
或者:
这件事情我不太确定,最好交给 LLM 或人工。

三、有了置信度以后,真正难的是“阈值”
假设我们真的把 Jev 接进测试平台。
它每天帮助判断自动化测试失败原因。
我们不可能只写一句:
取概率最高的答案
→ 自动处理
因为:
概率最高,不代表概率足够高。
更现实的系统可能会这样设计:
置信度 ≥ 95%
→ 自动处理

70%~95%
→ LLM 二次分析

< 70%
→ 人工复核
看起来很合理。
但测试工程师马上就会遇到一个问题:
为什么自动处理的阈值是 95%,而不是 90%?
如果把阈值从 95% 降到 85%:
自动化率会上升。
需要人工处理的问题会减少。
但是误判可能增加。
如果把阈值提高到 99%:
误判可能减少。
但大量任务又会重新掉回人工。
所以真正的生产问题变成了:
自动化率、误报率、漏报率和业务风险之间怎么平衡?
这已经不只是一个模型问题。
而是一个典型的:
测试 + 业务策略问题。
四、未来测试 AI,可能不能只看 Accuracy
以前测试分类模型,大家比较熟悉的是:
Accuracy

Precision

Recall

F1
这些指标当然依然重要。
但当 AI 开始直接参与业务决策以后,还需要增加另一组指标。
比如:
置信度分布
模型是不是动不动就返回:
98%
99%
99.9%
如果任何问题都非常“自信”,本身就值得警惕。
分桶准确率
我们可以把结果按照置信度分组:
50%~60%

60%~70%

70%~80%

80%~90%

90%~100%
然后统计:
每一个区间真实的准确率是多少。
如果:
90%~100% 置信度
实际只有 75% 正确
说明模型明显过度自信。
阈值下的误报和漏报
比如风险检测:
阈值设成 80% 和 95%,分别会漏掉多少真正风险?
又会错误拦截多少正常请求?
这些都会直接影响生产策略。
五、这其实是一种新的 AI 测试流程
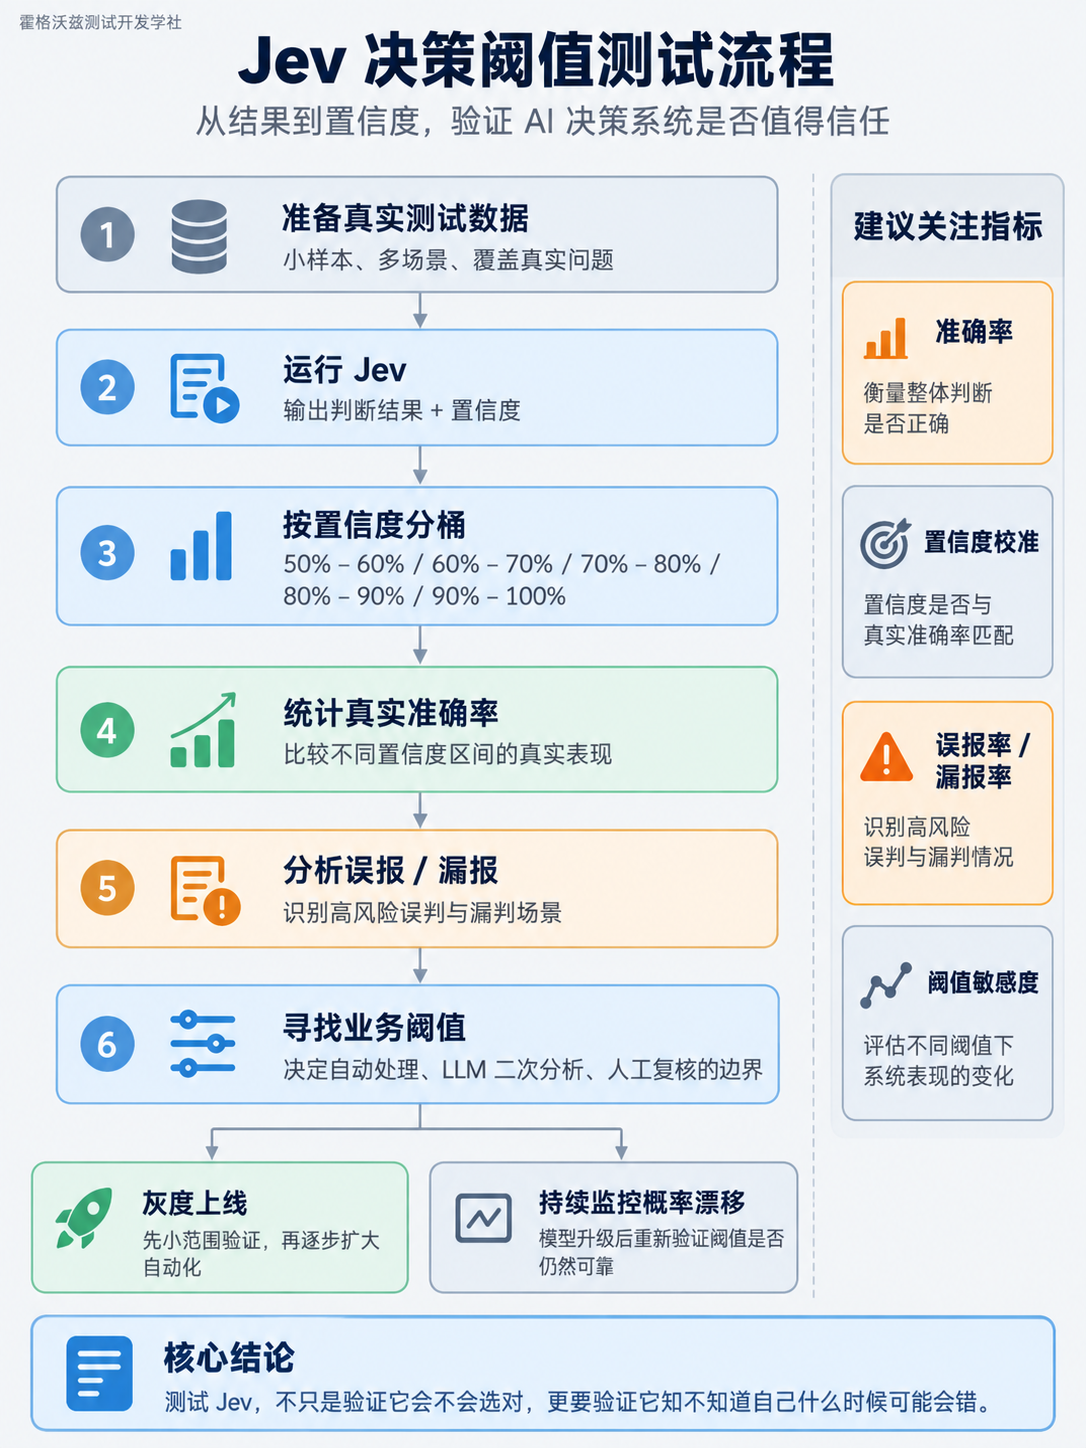
未来测试 Jev 这种 Decision Model,可以采用这样的流程:
六、TypeSafe 的 Workflow 为什么值得测试人看看?
TypeSafe 这次公开的 Workflow Evals,也体现了这种思路。
他们没有简单地把整个业务策略塞进一个超级 Prompt,让模型一次性给出最终答案。
而是把复杂任务拆成很多小问题。
主要包括三类:
Noul
→ Yes / No 判断

Choice
→ 多个选项中选择

Score
→ 连续评分
模型输出概率之后,再由程序规则组合这些结果,决定最终应该执行什么动作。([Evals][2])
例如在 Agent Trace Observability 场景中,系统不会简单问:
“这个 Agent 有没有问题?”
而是分开判断:
是否进行了未经允许的不可逆操作?
任务到底有没有完成?
用户是否满意?
属于正常执行、预期偏差、显性失败,还是静默失败?
最后代码再决定:
自动关闭

人工检查

优先处理

创建 Issue

通知值班人员
这其实特别符合测试工程思维:
不要只看最终答案,而要验证整个判断链。
七、模型升级以后,还要测一个新东西:决策漂移
还有一个经常容易被忽略的问题:
模型会升级。
假设 Jev V1 的时候:
置信度 > 90%
自动处理
表现很好。
后来模型升级成 V2。
整体 Accuracy 提高了。
大家可能觉得:
新版本更强,那直接上线就好了。
但这并不一定成立。
因为虽然整体准确率提高了,
它的概率分布可能变化了。
过去:
90%
≈ 非常可靠
新版本可能变成:
90%
≈ 普通可靠
那企业以前制定好的业务阈值就可能失效。
因此模型版本升级以后,测试工程师除了做传统回归,还要关注:
Decision Drift——决策漂移。
比如:
相同测试集

V1:
平均置信度 82%

V2:
平均置信度 94%
如果准确率没有同步发生变化,
说明模型可能只是:
变得更自信了。
不一定是真的变得更准了。
八、这也是 AI 测试真正开始变化的地方
过去我们做 AI 测试,很多关注点还停留在:
模型回答有没有幻觉?
RAG 能不能找到正确知识?
Agent 能不能完成任务?
这些当然重要。
但随着 Jev 这种模型开始进入软件内部,直接参与:
分类
路由
评分
风险判断
Guardrail
Agent Review
测试问题也会跟着发生变化。
以后我们需要问的不只是:
AI 判断对了吗?
还包括:
它有多确定?
这个确定程度可信吗?
什么情况下允许它自动执行?
什么情况下必须升级给 LLM?
什么情况下必须找人?
所以 AI 测试可能正在从:
结果测试
进一步走向:
决策测试。
写在最后
Jev 会不会成为下一代主流 AI 基础设施,现在还太早。
它目前仍然处于 Early Access 阶段,TypeSafe 公布的很多性能和校准能力,也还需要更多真实生产场景验证。
但 Jev 带出来的这个问题,非常值得测试工程师提前关注:
当 AI 开始直接替软件“做决定”,我们应该怎么证明这个决定值得信任?
未来测试一个智能系统,也许不能只告诉老板:
准确率 95%。
还要能够回答:
哪些情况下它可以自己做决定?
哪些情况下应该交给更强的模型?
哪些情况下必须让人来兜底?
这才是真正把 AI 从 Demo 放进生产环境之后,测试工程师需要解决的问题。
测试 Jev,不只是验证它会不会选对。
更重要的是验证:
它知不知道自己什么时候可能会错。

- 点赞
- 收藏
- 关注作者
评论(0)