Jev 发布不到一周,为什么它这么快进入 Agent 工程?
摘要:
Jev 发布不到一周,已经被 Vercel AI Gateway、LangChain 等 Agent 基础设施快速接入。
一个不会聊天、不负责写代码、甚至主要输出 Choice、Score 和 Boolean 的模型,为什么反而这么快进入 Agent 工程?
原因可能并不在于它“更聪明”。
而是今天的 Agent,确实存在大量根本不需要复杂生成、只需要快速判断的工作。
一、Jev 发布几天后,一个信号开始出现
9 月 15 日,TypeSafe AI 发布 Jev。
9 月 16 日,Vercel AI Gateway 正式上线 Jev。
随后 Vercel 公布了一组很有意思的数据:
上线 AI Gateway 后 24 小时内,接近 13% 的付费团队使用过 Jev。
按照 Vercel 自己的统计,这是其 AI Gateway 历史上采用速度最快的新模型发布之一。
紧接着,LangChain 也发布了:
Building a Harness with Jev
专门讨论 Jev 怎么进入 Agent Loop。
到 9 月 20 日,LangChain 又做了一轮新的实验:
Jev-as-a-Judge for Agent Evals
开始尝试让 Jev 直接承担 Agent Evaluator。
这几个动作放在一起看,就很有意思。
因为 Jev 并不是一个新的通用大模型。
它不会和 GPT、Claude 去比:
谁写代码更强?
谁推理更深?
谁能跑更长时间的 Agent?
它瞄准的是另外一层:
Agent 运行过程中那些大量、重复、高频的判断。
二、今天的 Agent,真正贵的可能不只是“思考”
先看一个最普通的 Agent Loop:
用户任务
↓
LLM 判断下一步
↓
调用 Tool
↓
读取结果
↓
LLM 判断结果
↓
决定继续还是停止
↓
再次调用 Tool
↓
再次判断
一个任务跑下来,可能调用大模型很多次。
但仔细拆开,会发现这里并不是每一次都需要复杂推理。
比如:
应该调用哪个 Tool?

任务完成了吗?

要不要重试?

当前结果风险高吗?

要不要升级人工?

这个 Agent Run 是否异常?
这些问题和:
“分析整个代码仓库,定位 Bug 并给出修复方案”
完全不是一个复杂度。
但过去我们的做法经常是:
全部调用 LLM。
LangChain 在介绍 Jev Harness 时也指出,Agent Loop 即便有了 Tool Calling 和 Structured Output,仍然存在一个工程问题:
每一次决策都调用一次大模型,会不断增加延迟和成本。
Jev 恰好切的就是这一层。

三、第一个位置:Agent Routing
Vercel 官方列出的 Jev 使用场景中,第一个就是:
选择 Agent 下一步调用的 Tool 或 Subagent。
假设一个企业 Agent 有:
浏览器
数据库
搜索
代码执行
HTTP API
内部知识库
20 个 MCP
50 个 Skill
每次任务都让一个强 LLM 从头阅读全部工具说明,再决定调用谁,并不一定是最优解。
未来可能先经过一个快速路由层:
用户任务
↓
Jev 判断
↓
Playwright:86%
API:9%
Search:4%
Other:1%
↓
缩小候选范围
↓
LLM 继续执行
这里 Jev 并没有替代 Agent。
它只是把:
“从几十个能力里先筛出几个”
这件事情独立出来。
对于 Tool、MCP、Skill 越来越多的 Agent 来说,这种能力反而越来越重要。
四、第二个位置:控制 Agent Loop
还有一类判断更加高频:
Agent 到底还要不要继续?
例如:
继续执行

重新尝试

修改参数后重试

询问用户

停止任务
这些实际上是 Agent Harness 的控制问题。
Vercel 对 Jev 的官方介绍里,就明确列出了:
continue / retry / ask the user / stop
这类 workflow decision。
于是 Agent 架构可能出现一个变化:
过去是:
Tool 返回结果
↓
LLM 阅读
↓
LLM 生成判断
↓
程序解析结果
↓
继续执行
以后某些步骤可能变成:
Tool 返回结果
↓
Decision Model
↓
继续 / 重试 / 停止
↓
程序直接执行
只有结果真的复杂时,
才重新进入 LLM。
这其实就是把:
流程控制
和:
复杂推理
拆开。
五、第三个位置:Guardrail
LangChain 的 Jev Harness 里还有一个非常典型的例子:
在 Tool 真正执行之前,先判断这次操作有没有风险。
例如 Agent 准备执行:
读取目录
风险很低。
但如果要:
删除文件
修改系统配置
执行危险 Shell
修改生产数据
风险就完全不同。
于是可以在 Tool 前增加一道判断:
Tool Call
↓
风险判断
↓
低风险 → 自动执行

高风险 → 阻断 / 人工确认
这里有一个非常重要的工程原则:
明确的安全规则,仍然应该写死在代码里。
比如:
禁止执行 rm -rf /
这种事情不应该让 AI 来猜。
但规则覆盖不了的灰度风险,可以增加一层模型判断。
也就是说:
硬规则
+
Jev 判断
+
人工兜底
而不是:
所有安全问题都问一次 LLM。
六、第四个位置,可能更值得测试工程师关注:Agent Eval
而今天 LangChain 最新的一轮 Jev 测试,我觉得对测试开发同学尤其值得关注。
他们尝试让 Jev 直接充当:
Agent Evaluator。
目前 Agent Eval 常见两种方案。
第一种:
代码规则。
稳定、便宜,但只能测试明确条件。
第二种:
LLM-as-a-Judge。
理解能力强,但是更慢、更贵,而且连续评分时可能存在稳定性问题。
LangChain 这次尝试的是第三种:
规则 Judge
        +
Jev Judge
        +
LLM Judge
在他们这次较窄范围的实验里,Jev 平均单次耗时约 0.44 秒,总成本也明显低于参与比较的通用 LLM;在连续评分一致性上,他们报告 Jev 的方差明显更低。不过 LangChain 同样强调,这是一次早期、有限范围测试,不能直接外推到所有 Agent Eval 场景。
这其实又回到了我们前面一直讨论的问题:
Agent 测试真的需要每一个 Eval 都调用一个强 LLM 吗?
可能并不需要。
七、为什么 Jev 会这么快被 Agent 基础设施接住?
所以回过头看 Jev 发布后的这几天,我觉得真正值得关注的不是:
又出现了一个新模型。
而是它刚好撞上了 Agent 当前一个非常真实的工程痛点。
今天的 Agent 越来越复杂:
更多 Tool

更多 MCP

更多 Skill

更多 Context

更长执行链

更多 Trace

更多安全检查
与此同时,
我们却仍然习惯用同一种东西解决所有智能问题:
LLM。
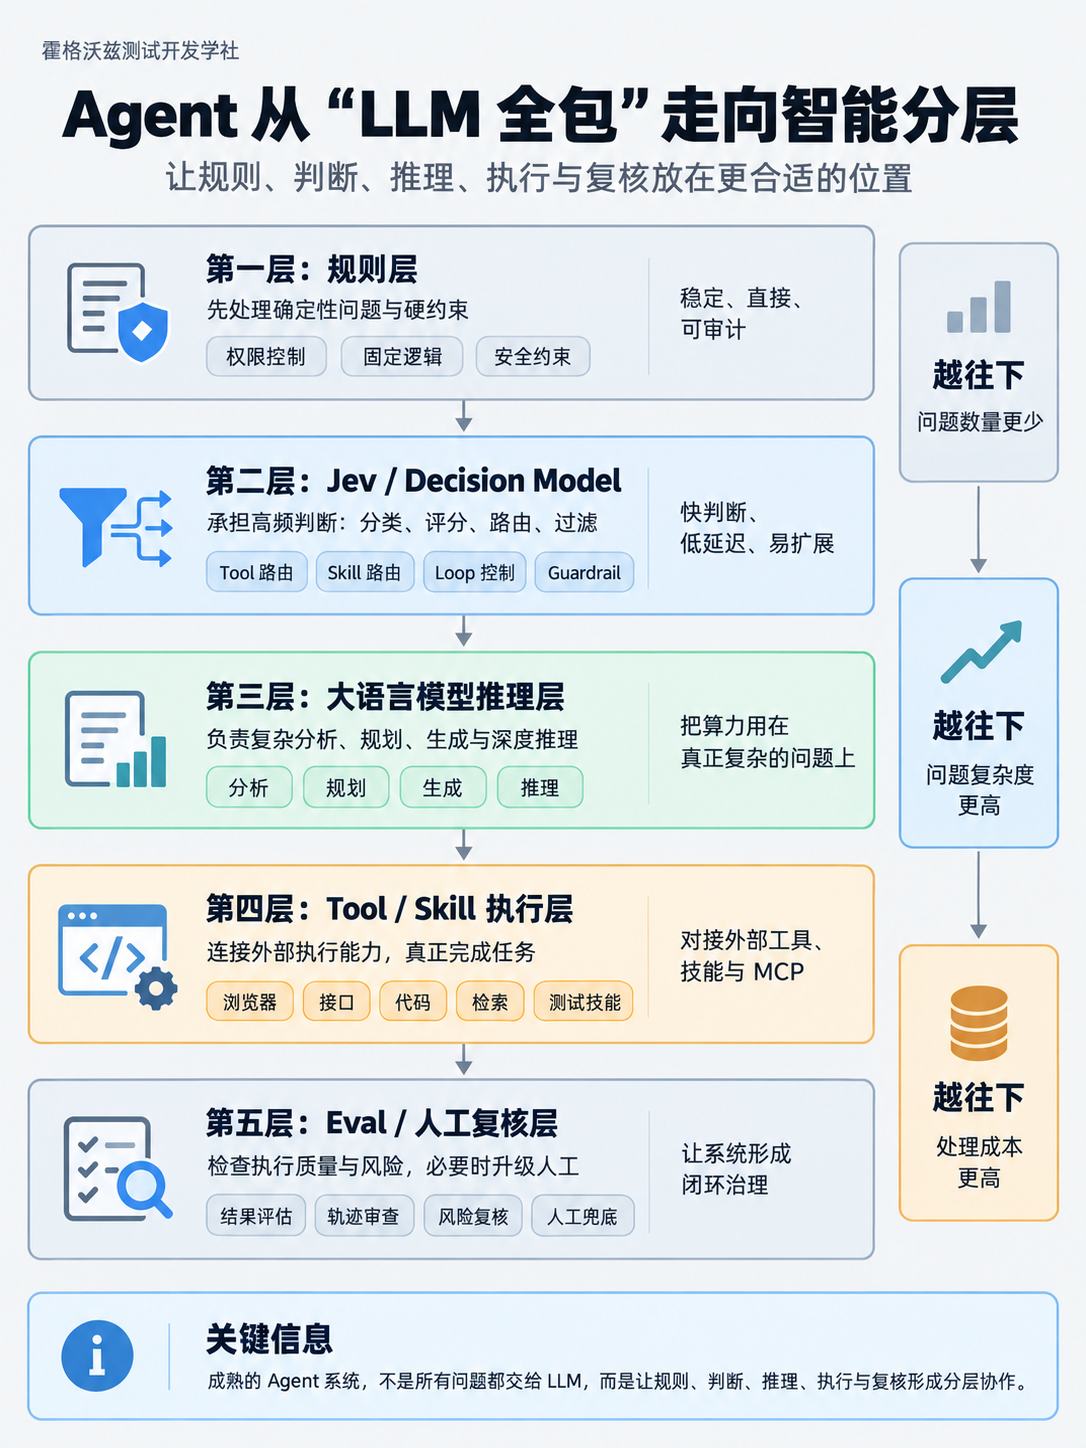
但其实 Agent 里面至少存在三种完全不同的问题:
确定性问题
→ 代码 / 规则

快速判断问题
→ Decision Model

复杂推理问题
→ LLM
Jev 真正让开发者感兴趣的,很可能就是中间这一层。
八、但现在还不能说明 Jev 已经“成功”
这里也需要冷静一点。
Vercel 的 13% 是发布第一天的尝试团队比例。
它能够说明:
开发者对这种模型非常感兴趣。
但不能直接说明:
这些团队未来都会长期使用 Jev。
Vercel 自己也明确表示,接下来真正需要观察的是:
这种早期采用能不能持续。
同样,
TypeSafe 公布的最高 193.6 倍速度提升、444.6 倍成本下降,来自特定 Workflow Eval,并不能简单理解成:
Jev 在任何任务上都比 LLM 快 193 倍。
LangChain 最新的 Agent Eval 结果也只是一次较窄范围的早期实验。
所以现在讨论:
Jev 会不会成为 Agent 标配?
还太早。
九、真正值得关注的是:Agent 架构开始拆“大模型”了
过去 Agent 的架构很容易画成:
用户
↓
LLM
↓
Tool
↓
LLM
↓
Tool
↓
LLM
但 Jev 这种模型出现以后,
未来可能慢慢变成:
用户任务
↓
规则
↓
快速判断层
↓
LLM 深度推理
↓
Tool / Skill
↓
快速验证
↓
异常再进入 LLM / 人工
也就是说:
Agent 的智能能力开始分层。
LLM 不会消失。
相反,它可以把计算资源留给真正需要:
推理、规划、代码生成和复杂分析
的地方。
而分类、路由、评分、Guardrail、Eval 等高频判断,则由其他组件承担。
写在最后
Jev 发布不到一周,Vercel 和 LangChain 就快速把它接进 Agent 基础设施,这件事本身已经比“Jev Benchmark 有多高”更值得关注。
因为它说明开发者正在重新思考一个问题:
Agent 里的每一个判断,都必须启动一个大模型吗?
答案可能正在变成:
不一定。
确定性的事情交给代码。
高频判断交给 Decision Model。
复杂推理交给 LLM。
最后再由 Agent Harness 把这些能力组织起来。
所以 Jev 真正值得关注的地方,
可能并不是它会不会成为下一个“大模型明星”。
而是它背后正在形成的一种 Agent 工程思路:
不要让最贵、最强的模型,去解决所有问题。

- 点赞
- 收藏
- 关注作者
评论(0)