Agent 里为什么不该什么都交给大模型?Jev 给了一个新答案
摘要:
2026 年 9 月,一个叫 Jev 的新模型开始受到 AI 圈关注。
它不会陪你聊天,不负责写文章,也不是冲着代码生成来的。
它主要干一件事:
判断。
分类、路由、打分、过滤、风险识别……
看起来没有 ChatGPT、Claude 这类大模型那么“全能”,但如果你真正做过 Agent、RAG 或 AI 测试平台,就会发现:
今天很多系统真正缺的,可能恰恰不是一个更大的模型,而是一个更快、更便宜、更适合程序直接调用的“判断层”。
一、我们可能让大模型干了太多“不需要深度思考”的事
现在做一个 Agent,我们已经习惯了这样的设计:
用户输入进来,先让大模型判断意图;
该调用哪个 Tool,让大模型判断;
应该加载哪个 Skill,让大模型判断;
RAG 检索出的内容哪些有用,让大模型判断;
工具执行完成以后结果有没有问题,还是让大模型判断。
最后真正生成用户答案的时候,当然还是大模型。
于是就出现一个很有意思的问题:
一个 Agent 里大量的 LLM 调用,其实根本不是为了“生成内容”。
很多时候,我们只是想知道:
- 是,还是不是?
- 属于 A、B 还是 C?
- 风险高、中还是低?
- 应该进入哪条业务流程?
- 这段内容要不要继续保留?
但我们依然会调用一个能够写文章、写代码、复杂推理的大语言模型,让它读取 Prompt、生成 Token,再从生成的一段 JSON 里面取出几个字段。
有点像:
只是想判断红绿灯是红还是绿,却启动了一台很大的通用计算系统。
这也是最近 Jev 值得关注的地方。
2026 年 9 月 15 日,TypeSafe AI 发布了第一款公开的 System One Model——Jev,目前处于 Early Access 阶段。TypeSafe 将这类模型定位为专门运行在软件内部的“决策模型”:输入非结构化状态,输出程序能够直接消费的类型化决策和概率。([TypeSafe AI][1])
二、Jev 不负责“说话”,而是负责“做判断”
理解 Jev,其实可以先理解一个区别:
LLM 更擅长生成,Jev 更强调决策。
比如有一条客服消息:
我的订单已经三天没到了,我明天就要出差,麻烦尽快处理。
传统大模型可能返回:
{
  "intent": "物流问题",
  "urgency": "high",
  "need_human": true
}
表面上已经是结构化输出。
但底层依然经历了一套生成流程:
输入 Prompt
↓
模型推理
↓
逐 Token 生成
↓
生成 JSON
↓
解析
↓
Schema 校验
↓
程序继续执行
Jev 的思路不太一样。
程序可以提前定义:
intent:
物流 / 退款 / 支付 / 其他

urgency:
低 / 中 / 高

need_human:
是 / 否
然后模型直接返回这些选项对应的判断以及概率。
例如:
物流问题:96%

紧急程度:
高:92%
中:7%
低:1%

需要人工介入:
是:94%
否:6%
程序马上就可以执行:
if urgency_high > 0.9:
    enter_emergency_workflow()
所以如果用一句特别工程化的话解释 Jev:
它有点像一个具备语义理解能力的“智能 if”。
TypeSafe 对 Jev 的官方描述也很直接:不是输出 strings,而是输出 typed decisions,并且为决策附带概率与置信度。([TypeSafe AI][2])
三、为什么它会被叫作 System One?
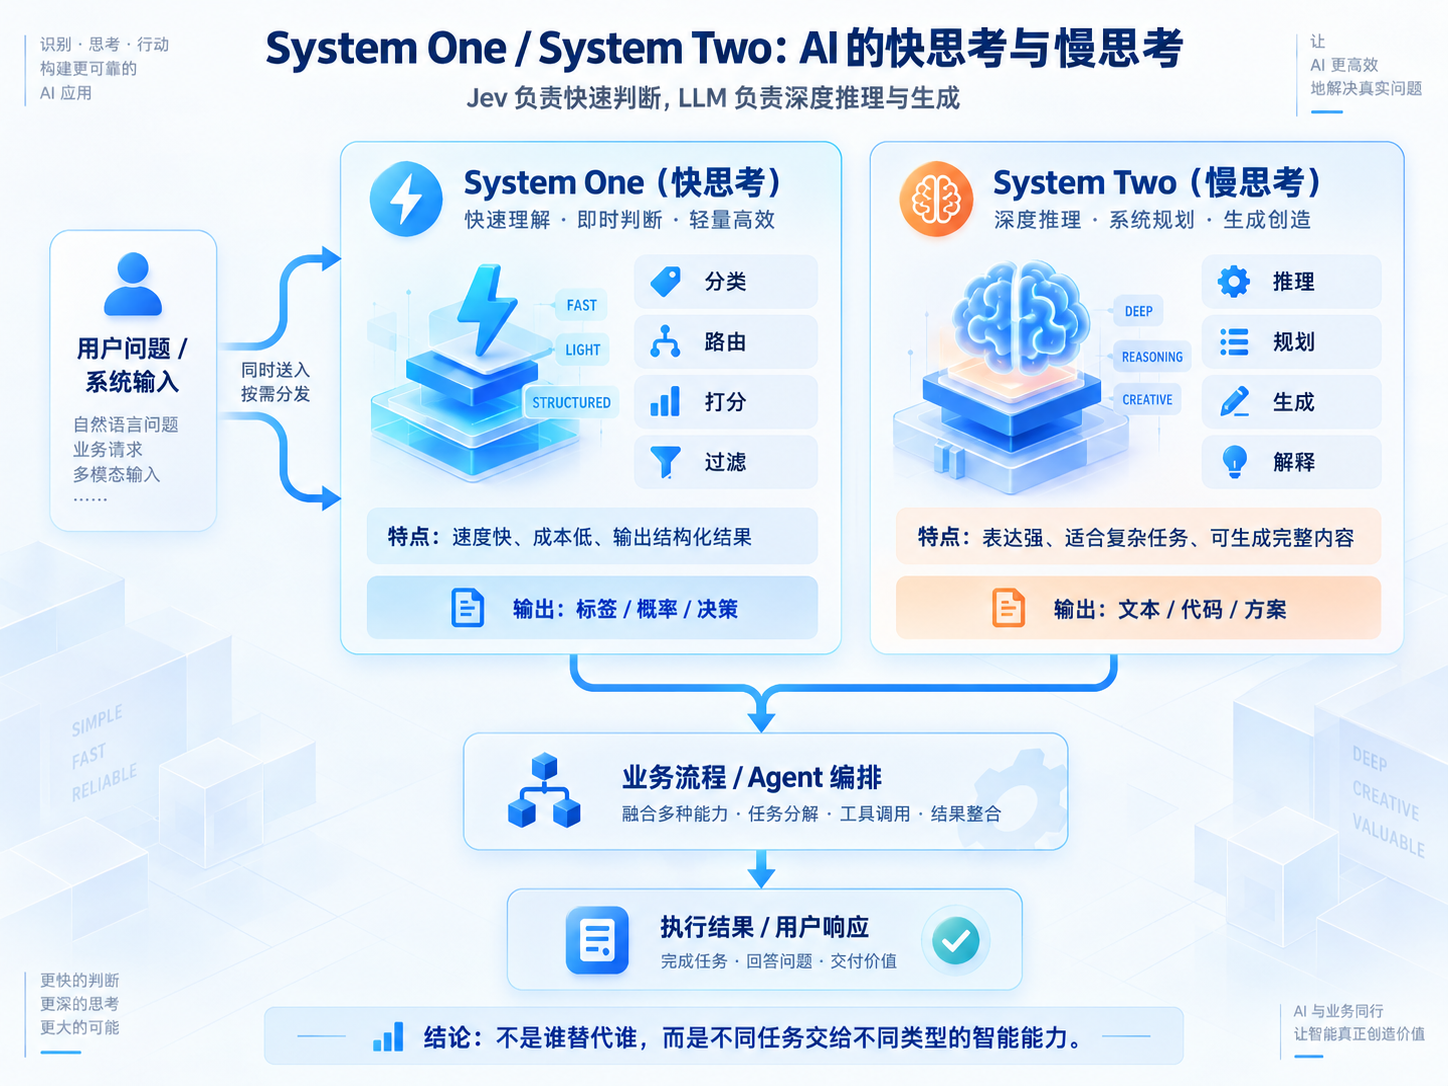
System One 这个名字,来自丹尼尔·卡尼曼的《思考,快与慢》。
简单理解:
System One:快思考
偏快速、直觉式判断。
System Two:慢思考
偏分析、推理、规划和复杂问题求解。
放到 AI 系统里,可以粗略理解成:
大语言模型更适合承担复杂推理、生成、规划;
而 System One Model 更适合承担大量边界相对清晰的快速判断。
这里最容易产生一个误区:
Jev 并不是用来替代 LLM 的。
真正值得关注的是:
未来 AI 系统可能不会再让一个大模型承担所有工作。
而是开始分层。
复杂问题交给 LLM。
大量高频判断,则交给更加轻量的决策模型。
这和今天的软件架构其实非常像。
数据库不会负责所有计算;
缓存不会替代数据库;
消息队列也不会替代业务系统。
不同组件解决不同问题。
AI 也可能正在经历同样的过程。
四、Jev 和大语言模型到底有什么区别?
把两者放在一起,就更容易理解。
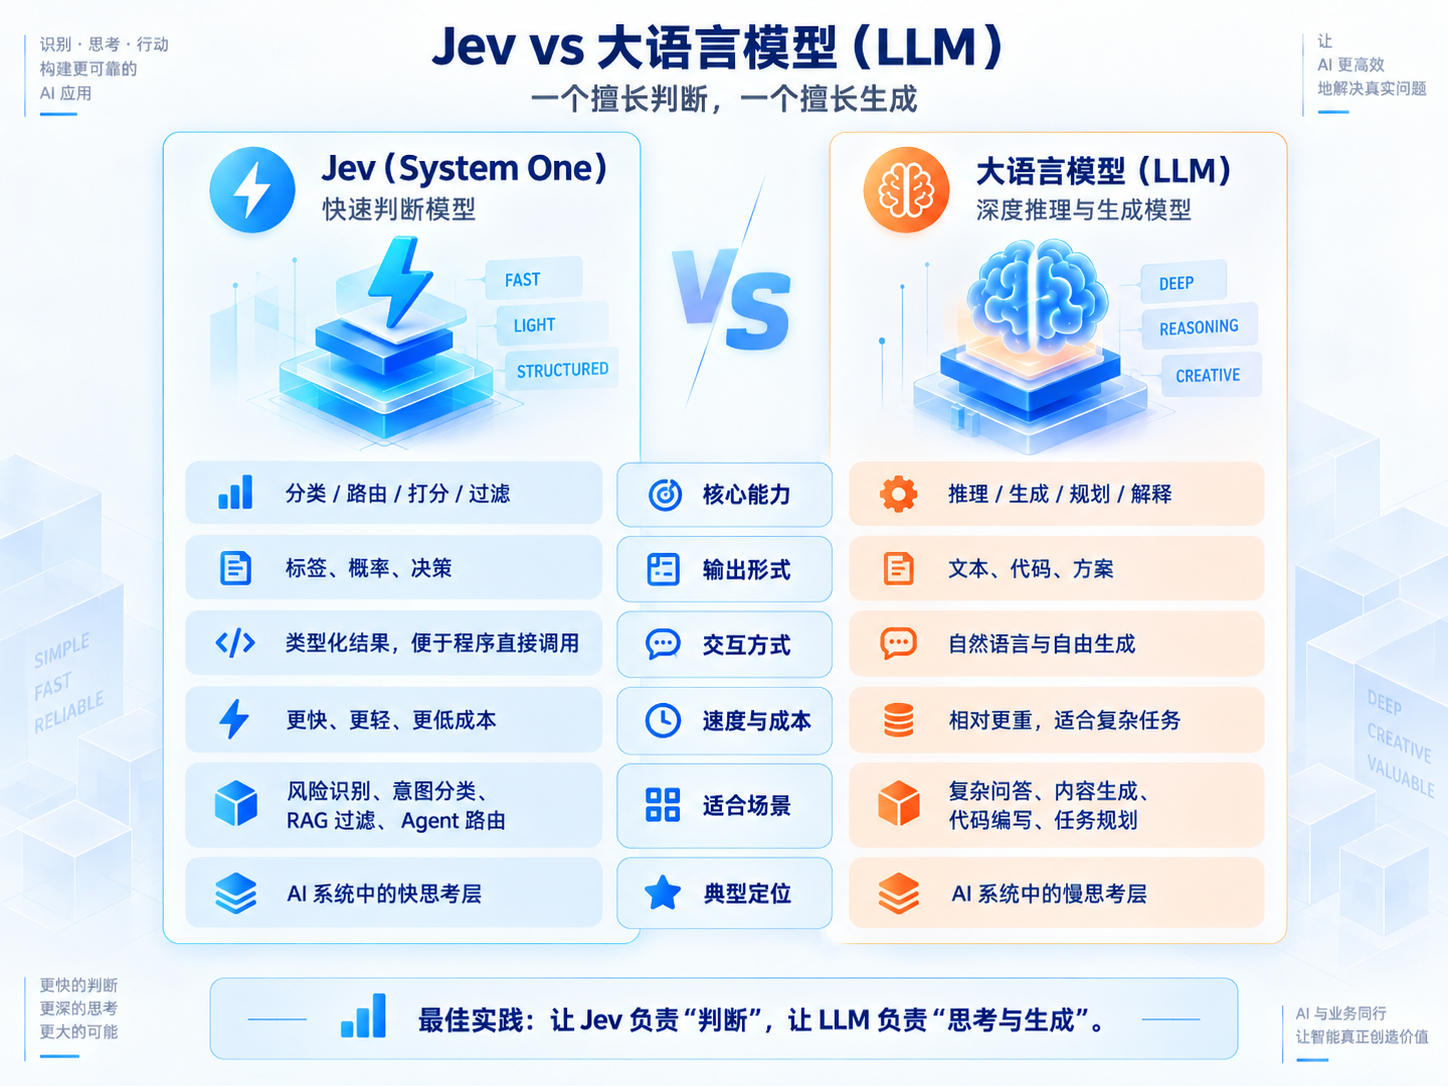
LLM 最强的地方,是自由度。
它可以:
写文章、写代码、总结、规划、推理、解释问题。
这也是生成式 AI 为什么如此强大的原因。
但自由度高同样意味着:
系统很难百分之百约束它会输出什么。
即使要求:
{
  "risk": "high"
}
模型理论上依然是在“生成字符串”。
所以生产系统往往还需要:
JSON 解析
Schema 校验
异常重试
Fallback
Prompt 约束
Guardrail
而 Jev 选择牺牲一部分通用生成能力,把问题限制到:
已经提前定义好的决策空间里。
所以它特别适合:
分类
路由
评分
过滤
抽取
风险判断
Guardrail
TypeSafe 官方将其描述为“AI-Powered Workflows / smart if-statements”,也就是把传统代码很难写死的模糊判断,变成软件可以直接使用的决策节点。([TypeSafe AI][3])
五、为什么这件事可能比“又出了一个新模型”更重要?
因为 Jev 真正挑战的,其实是过去几年一个非常常见的 AI 开发方式:
遇到任何问题,都先写一个 Prompt。
分类?
Prompt。
路由?
Prompt。
评分?
Prompt。
异常识别?
Prompt。
内容过滤?
还是 Prompt。
最终整个系统变成:
业务代码
↓
Prompt
↓
LLM
↓
JSON
↓
解析
↓
Schema 校验
↓
异常重试
↓
业务代码
但很多生产场景真正想要的,其实只是:
业务状态
↓
AI 判断
↓
概率
↓
if / switch
↓
业务流程
这两个架构表面上看区别不大。
真正落到生产环境,区别却非常大。
因为一个真正的大规模系统,需要关注的永远不只是模型“聪不聪明”。
还有:
延迟、成本、稳定性、可观测性、可测试性以及失败后的兜底机制。
这也是为什么 System One 这套思路特别值得工程团队关注。
六、193 倍更快、444 倍更便宜,到底能不能信?
Jev 最近传播最广的一组数字是:
最高 193.6 倍更快。
最高 444.6 倍更便宜。
TypeSafe 官方确实公布了这组数据,但这里一定要看完整。
这些数字来自他们设计的 System One Workflow Benchmark,并不是说“所有任务都比 GPT 快 193 倍”。
TypeSafe 自己也明确说明:
这些结果属于真实场景收益中的较高水平,不能简单外推到所有任务。([TypeSafe AI][3])
目前官方公布的 Jev 输入价格为:
每 10 亿 Input Token 42 美元,也就是每百万 Token 0.042 美元。
其公开资料给出的端到端响应时间大约为:
70ms~500ms。
官方认为,在适合 System One 的任务中,相对于同等水平的通用 LLM,可以达到约 40~200 倍的速度差异。([TypeSafe AI][1])
但真正值得我们关注的其实不是:
Jev 到底比 GPT 快多少倍?
而是:
AI 系统是不是开始从“一个大模型解决所有问题”,走向不同模型处理不同计算任务?
我认为后者更重要。
七、Agent 可能是最适合 System One 的场景之一
如果真正拆过一个 Agent Harness,就会发现:
里面存在大量“判断型任务”。
1. Skill 路由
用户提了一个问题。
到底加载:
playwright-skill

appium-skill

api-testing-skill
还是其他 Skill?
本质上就是一个分类问题。
2. Tool Routing
当前任务应该:
搜索网页

读取文件

执行代码

访问数据库

操作浏览器
依然是选择问题。
3. Guardrail
例如:
是否存在 Prompt Injection?

操作风险高不高?

是否涉及敏感数据?

是否需要人工确认?
这些都是典型的判断任务。
4. RAG 上下文过滤
假设向量库一次召回了 100 条内容。
真正的问题可能不是:
请分析这 100 条资料。
而是:
哪 10 条资料真正和用户的问题相关?
依然可以转化成大量独立的评分或者判断任务。
所以未来的 Agent Harness,很可能会进一步变成:
用户任务
↓
规则判断
↓
System One 快速判断
↓
复杂任务进入 LLM
↓
Tool / Skill 执行
↓
System One 再次验证
↓
最终输出
也就是说:
LLM 不一定消失,但它可能不再参与每一个步骤。
八、对于软件测试,这件事其实更值得关注
很多测试同学看到这里可能会觉得:
Jev 是做 Agent 的,和测试有什么关系?
其实恰恰相反。
软件测试里面存在大量工作,本质就是:
判断。
比如:
失败日志
↓
环境问题 / 数据问题 / 代码问题?
又比如:
缺陷
↓
P0 / P1 / P2 / P3?
或者:
接口变更
↓
哪些测试用例需要重新执行?
再比如现在越来越重要的 Agent 测试:
Agent Trace
↓
正常行为 / 异常行为 / 越权行为?
这些全部都是决策问题。
传统测试平台通常有两种解决方案。
第一种:
写规则。
第二种:
规则写不动了,直接上大模型。
而 System One 提供了第三种思路:
规则 + 快速决策模型 + LLM 深度分析。
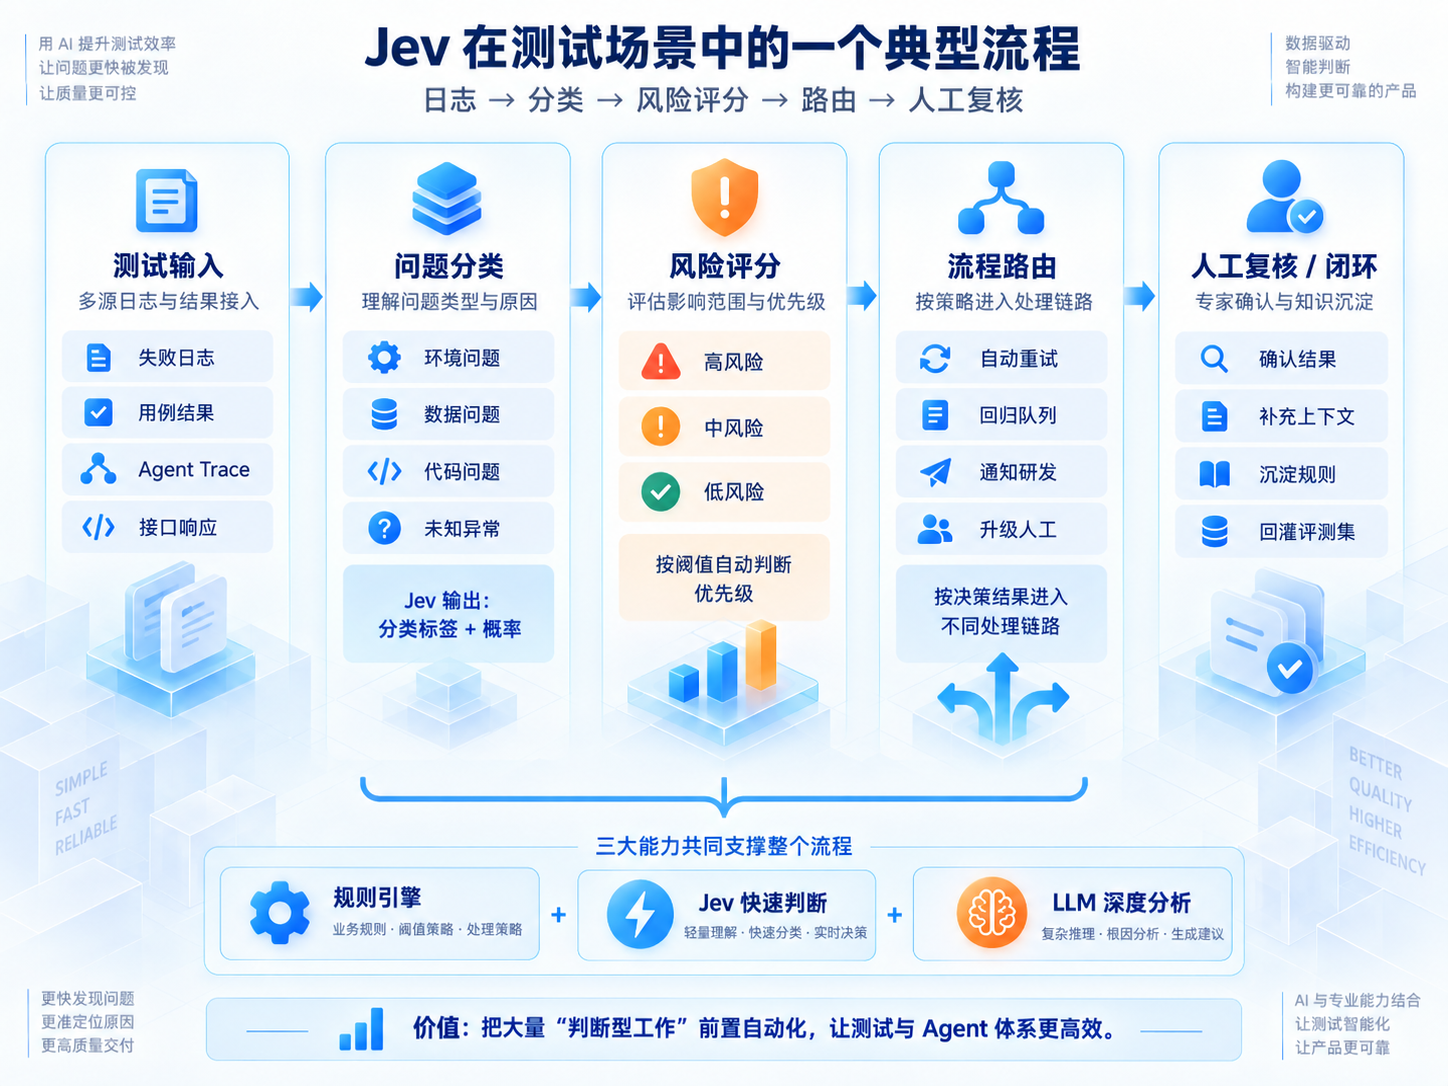
未来一个智能化测试平台完全可能这样工作:
测试执行产生大量日志。
Jev 第一层先判断:
环境问题:87%

数据问题:8%

代码问题:5%
如果置信度足够高:
直接进入自动重试或者环境修复流程。
如果属于中风险:
进入待确认队列。
只有遇到复杂异常时,才真正调用 LLM:
读取 Trace、代码 Diff、日志、历史缺陷,再做深度根因分析。
这样一来:
LLM 从“什么问题都处理”,变成“只处理真正需要复杂推理的问题”。
这可能对 AI 测试平台的成本和吞吐量带来非常大的变化。
九、但 Jev 现在远没有到“替代大模型”的阶段
这里也需要给 Jev 降一点温。
首先,Jev 目前仍处在 Early Access。
并不是一个已经被大量企业生产环境验证很多年的成熟基础设施。([TypeSafe AI][1])
其次:
类型安全,不代表判断永远正确。
Jev 的一个重要特点,是输出空间提前被程序定义好。
比如只能选择:
low
medium
high
那么模型就不会突然返回:
super_critical
程序也不用担心模型突然写一段解释文字导致 JSON 解析失败。
TypeSafe 表示 Schema Matching 可以保证,因此强调 Jev 不会出现类型错误。([TypeSafe AI][3])
但是:
输出格式正确 ≠ 业务判断正确。
如果真实风险应该是 high,模型仍然可能判断成 medium。
所以进入生产以后,该做的事情一样不能少:
评测集
概率校准
阈值测试
错误分析
漂移监控
人工复核
甚至从测试角度看,这里还会诞生一批新的测试问题:
置信度到底准不准?
0.8 和 0.9 的阈值应该怎么选?
模型在什么数据分布下最容易判断错误?
模型版本升级以后概率有没有发生漂移?
这本身就是一套新的 AI 系统测试体系。
十、真正值得关注的,是 AI 架构开始分层了
过去几年,我们讨论 AI 模型最喜欢问:
模型参数有多大?
上下文有多长?
代码能力多强?
推理 Benchmark 排第几?
但 Jev 带来的另一个问题可能更值得工程师思考:
所有需要智能的地方,真的都需要调用一个能够自由生成语言的大模型吗?
答案很可能是否定的。
未来成熟的 AI 系统,可能逐渐形成这样的分层:
确定性问题
↓
规则 / 普通代码

大量模糊判断
↓
System One 决策模型

复杂分析与推理
↓
LLM

任务拆解与工具执行
↓
Agent Harness
所以 Jev 真正让我感兴趣的,并不是:
它会不会成为下一个 ChatGPT。
恰恰相反。
它可能根本就不想成为 ChatGPT。
它代表的是另一条路线:
不是继续把一个模型做得无所不能,而是开始认真考虑——什么任务,应该交给什么样的智能。
而对于测试开发工程师来说,这个变化同样值得关注。
因为未来我们测试的可能不再只是:
“大模型回答得对不对?”
而是整个智能系统里的:
规则、决策模型、LLM、Agent、Tool 和人工兜底,到底有没有在正确的位置做正确的事情。
这可能才是 AI 测试下一阶段真正需要解决的问题。

- 点赞
- 收藏
- 关注作者
评论(0)