华为云码道 CodeArts 实战:AI 智能体独立开发一个多平台内容分发管理台(架构设计 + 开发实录)
摘要:本文是华为云码道 AI 编程挑战赛的参赛实测记录。我用 CodeArts 代码智能体独立开发了一个全栈 Web 应用「ArticlePilot 多平台内容分发管理台」,解决技术创作者同一篇文章要发多个平台、格式与发布状态全靠人肉维护的问题。文章完整记录选题背景、架构设计(平台适配器模式 + 稿件状态机 + RBAC)、AI 辅助开发的实操流程、功能演示与踩坑记录,源码已在 AtomGit 开源。
技术栈版本:码道 CodeArts 代码智能体(2026-09 挑战赛版本)| Spring Boot 3.5.x | Java 21 | Vue 3.5 + TypeScript | MySQL 8 | Docker Compose | 实测时间: 2026-09
一、项目背景:一个真实的多平台发布痛点
先交代我为什么要做这个项目。作为一名技术博主,我的工作流是这样的:一篇文章写完后,要发布到 CSDN、51CTO、腾讯云、阿里云、华为云、掘金、微信公众号等多个平台。每个平台的标签体系不同、封面尺寸不同、摘要字数限制不同、发布状态也各不相同。
在此之前,这套流程全靠 Excel 表格和本地文件夹人肉维护。哪篇稿子发到了哪个平台、哪个平台被拒稿了、哪个平台的标签还没适配,全靠记忆和翻记录。稿子一多,这套管理方式立刻崩坏——漏发、错发、状态对不上是常态。
所以这次参加华为云码道 AI 编程挑战赛,我决定不做一个"演示型"作品,而是直接把这条真实工作流工具化:做一个多平台内容分发管理台,让选题、稿件、平台适配、发布状态在一个地方闭环。这个选题有个额外好处:开发过程中遇到的每一个痛点,都是我真实经历过的,文章里不需要编任何故事。
1.1 作品功能一览
| 模块 | 功能 |
|---|---|
| 用户与权限 | JWT 登录、管理员/作者/访客三角色 RBAC |
| 选题库 | 选题增删改查、状态流转(IDEA → PLANNED → WRITING → ARCHIVED) |
| 稿件管理 | Markdown 编辑预览、乐观锁、版本快照、稿件状态机 |
| 平台适配 | 七大平台适配器、适配字段校验、token 加密存储 |
| 发布追踪 | 发布计划管理、状态看板、统计概览 |
技术栈:Vue 3 + TypeScript + Element Plus + Pinia(前端),Spring Boot 3 + MyBatis-Plus + Spring Security + MySQL 8(后端),Docker Compose 一键部署。
二、架构设计:三个核心决策
在动手让 AI 生成代码之前,我先把架构决策想清楚了——这一步很重要,AI 智能体擅长执行明确的架构约束,但不擅长替你做架构决策。评审维度里架构设计占 30%,这部分必须在投喂话术之前由人定好。
2.1 决策一:平台适配用适配器模式
多平台分发的核心复杂度在于:每个平台的发布要求都不一样。CSDN 要求 1~10 个标签,掘金必须传封面和摘要,公众号要求作者和 120 字以内的摘要。如果把每个平台的校验逻辑 if-else 地写死在业务代码里,每接入一个新平台就要改一遍核心流程。
所以我在设计上把它抽象成 PlatformAdapter 接口,每个平台一个实现类,通过 Spring 的依赖注入自动收集成注册表。新增平台 = 新增一个实现类,核心流程零改动。
动手前我把三个候选方案摆在一起比过:
| 方案 | 新增平台成本 | 校验逻辑内聚性 | 结论 |
|---|---|---|---|
| if-else / switch 按平台码分支 | 改核心流程,回归风险大 | 校验散落各分支 | 否决,违反开闭原则 |
| 配置化(平台规则存表驱动校验) | 不改代码,只加配置 | 复杂校验(如标签数量区间)表达不了,要写大量特判 | 否决,规则复杂后配置本身变成代码 |
| 适配器模式 | 新增一个实现类 | 校验、组装逻辑收敛在各自类里 | ✅ 采用 |
// src/main/java/com/articlepilot/adapter/PlatformAdapter.java
/**
 * 平台适配器接口。新增平台只需新增实现类,Spring 自动收集注入 PlatformAdapterRegistry —— 开放扩展原则。
 */
public interface PlatformAdapter {

    String platformCode();

    Set<String> requiredFields();

    ValidationResult validate(PublishDraft draft);

    PublishPlanData buildPlan(PublishDraft draft);
}
以 CSDN 适配器为例,校验规则精确到字段与原因(标签 1~10 个、标题 ≤100 字):
// src/main/java/com/articlepilot/adapter/impl/CsdnAdapter.java(节选)
@Component
@RequiredArgsConstructor
public class CsdnAdapter implements PlatformAdapter {

    @Override
    public String platformCode() {
        return "CSDN";
    }

    @Override
    public Set<String> requiredFields() {
        return Set.of("title", "contentMd", "tags");
    }

    @Override
    public ValidationResult validate(PublishDraft d) {
        if (d.getTitle() == null || d.getTitle().isBlank()) {
            return ValidationResult.fail("title 不能为空");
        }
        if (d.getTitle().length() > 100) {
            return ValidationResult.fail("title 长度不能超过 100");
        }
        int tagCount = d.getTags() == null ? 0 : d.getTags().size();
        if (tagCount < 1) {
            return ValidationResult.fail("tags 至少 1 个");
        }
        if (tagCount > 10) {
            return ValidationResult.fail("tags 最多 10 个");
        }
        return ValidationResult.ok();
    }
    // buildPlan(...) 略:组装发布计划并序列化为 JSON 落库
}
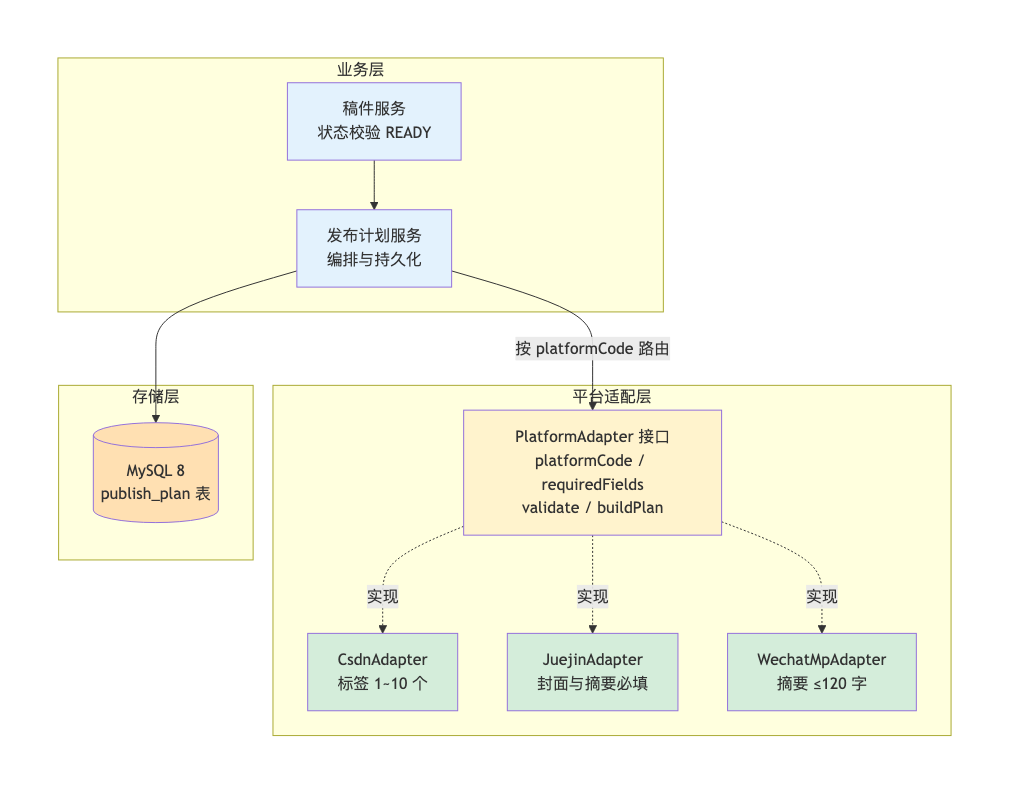
适配器模式的收益在代码上体现为两个"零":核心发布流程对接新平台的改动量为零,平台校验规则的维护彼此干扰为零。这个设计也是本文后面单元测试的落点——每个适配器都能独立测。
2.2 决策二:状态流转用集中式状态机
选题和稿件都有生命周期,如果任由前端"想改成什么状态就改成什么状态",脏数据迟早泛滥(比如把一个还停在 IDEA 的选题直接改成已发布)。所以我把合法流转表集中定义在 Service 层,非法流转直接拒绝并说明当前状态与目标状态。
状态校验的落点也考虑过两个位置:
| 方案 | 一致性 | 测试难度 | 结论 |
|---|---|---|---|
| 前端路由守卫拦截 | 只约束本前端,绕过前端直接调 API 就穿透 | 无法单测 | 否决,只能当体验优化 |
| 注解/AOP 式声明校验 | 分散在各切面,流转规则不直观 | 可测但调试链路长 | 否决,过度设计 |
| 集中式状态机类(纯静态方法) | 全局唯一流转表 | 纯函数,单测最简单 | ✅ 采用 |
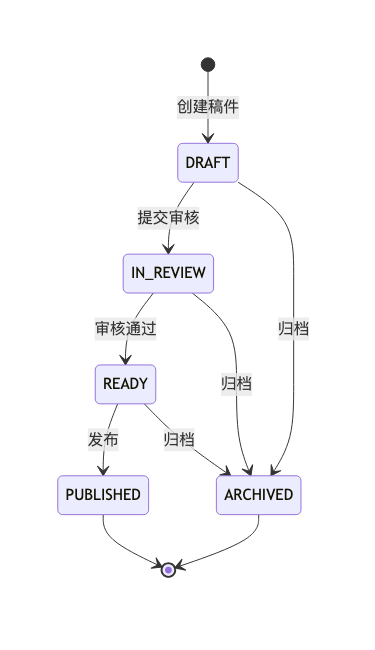
稿件状态机保证了一个不变量:只有 READY 状态的稿件才能创建发布计划。这条约束在前端 UI 上也有对应(流转按钮只展示合法目标状态),但真正的防线在后端——前端约束只是体验优化,不能当安全边界。
流转表在 Service 层只有一份,非法流转直接抛业务异常,错误信息带上传入的两个状态:
// src/main/java/com/articlepilot/service/article/ArticleStatusMachine.java(节选)
public final class ArticleStatusMachine {

    public static final int INVALID_TRANSITION_CODE = 1006;

    private static final Map<ArticleStatus, Set<ArticleStatus>> ALLOWED =
            new EnumMap<>(ArticleStatus.class);

    static {
        ALLOWED.put(ArticleStatus.DRAFT, Set.of(ArticleStatus.IN_REVIEW, ArticleStatus.ARCHIVED));
        ALLOWED.put(ArticleStatus.IN_REVIEW, Set.of(ArticleStatus.READY, ArticleStatus.ARCHIVED));
        ALLOWED.put(ArticleStatus.READY, Set.of(ArticleStatus.PUBLISHED, ArticleStatus.ARCHIVED));
        ALLOWED.put(ArticleStatus.PUBLISHED, Set.of(ArticleStatus.ARCHIVED));
        ALLOWED.put(ArticleStatus.ARCHIVED, Set.of());
    }

    public static void validateTransition(ArticleStatus from, ArticleStatus to) {
        Set<ArticleStatus> targets = ALLOWED.getOrDefault(from, Set.of());
        if (!targets.contains(to)) {
            throw new BusinessException(
                    INVALID_TRANSITION_CODE,
                    "稿件状态非法流转: " + from + " → " + to);
        }
    }
}
2.3 决策三:安全边界前置到设计
AI 生成的代码在业务逻辑上表现不错,但安全细节需要人主动提出约束,否则它会给你"能跑但不安全"的默认实现。本项目在设计阶段就定下四条安全红线,贯穿全部开发过程。其中密钥管理在"环境变量注入"和"配置文件加密(Jasypt)"之间权衡过:后者对单机部署更省事,但密文的主密钥还是得落 somewhere,等于把问题往后挪了一层;环境变量 + .env.example 模板在 Docker Compose 场景下零额外依赖,最终选了前者。四条红线如下:
| 红线 | 实现 |
|---|---|
| 密钥不入库 | JWT_SECRET、数据库密码、加密密钥全部环境变量注入 |
| token 不泄露 | 平台 token AES/GCM 加密落库,接口只返回掩码(sk-****ab12) |
| 越权有防线 | @PreAuthorize 接口级鉴权 + Service 层数据归属校验,双层防线 |
| 注入有防护 | 持久层全部走 MyBatis-Plus Wrapper 预编译,排序字段白名单 |
三、用 CodeArts 开发:我的实操流程
3.1 开发前的准备
在打开 CodeArts 之前,我做了三件"人肉"准备工作:在 AtomGit 创建公开仓库并放好 LICENSE、README 骨架和 .gitignore。
同时把架构决策(2.1~2.3)整理成带验收标准的投喂话术,并规划好七天的开发里程碑(D1 骨架 → D2 认证 → D3 稿件 → D4 适配器 → D5 收口 → D6 文章 → D7 投稿)。
这里分享一个最重要的使用心得:一次只投一个话术块,验收通过再投下一个。AI 在明确的小范围约束下表现非常稳定,但让它一次性"把整个系统写出来"时,质量会明显失控。
我给每个话术块都写死了目录结构、接口签名和验收标准(如 curl 实测场景、mvn test 全绿),AI 的任务是在约束内高质量实现,而不是自由发挥。
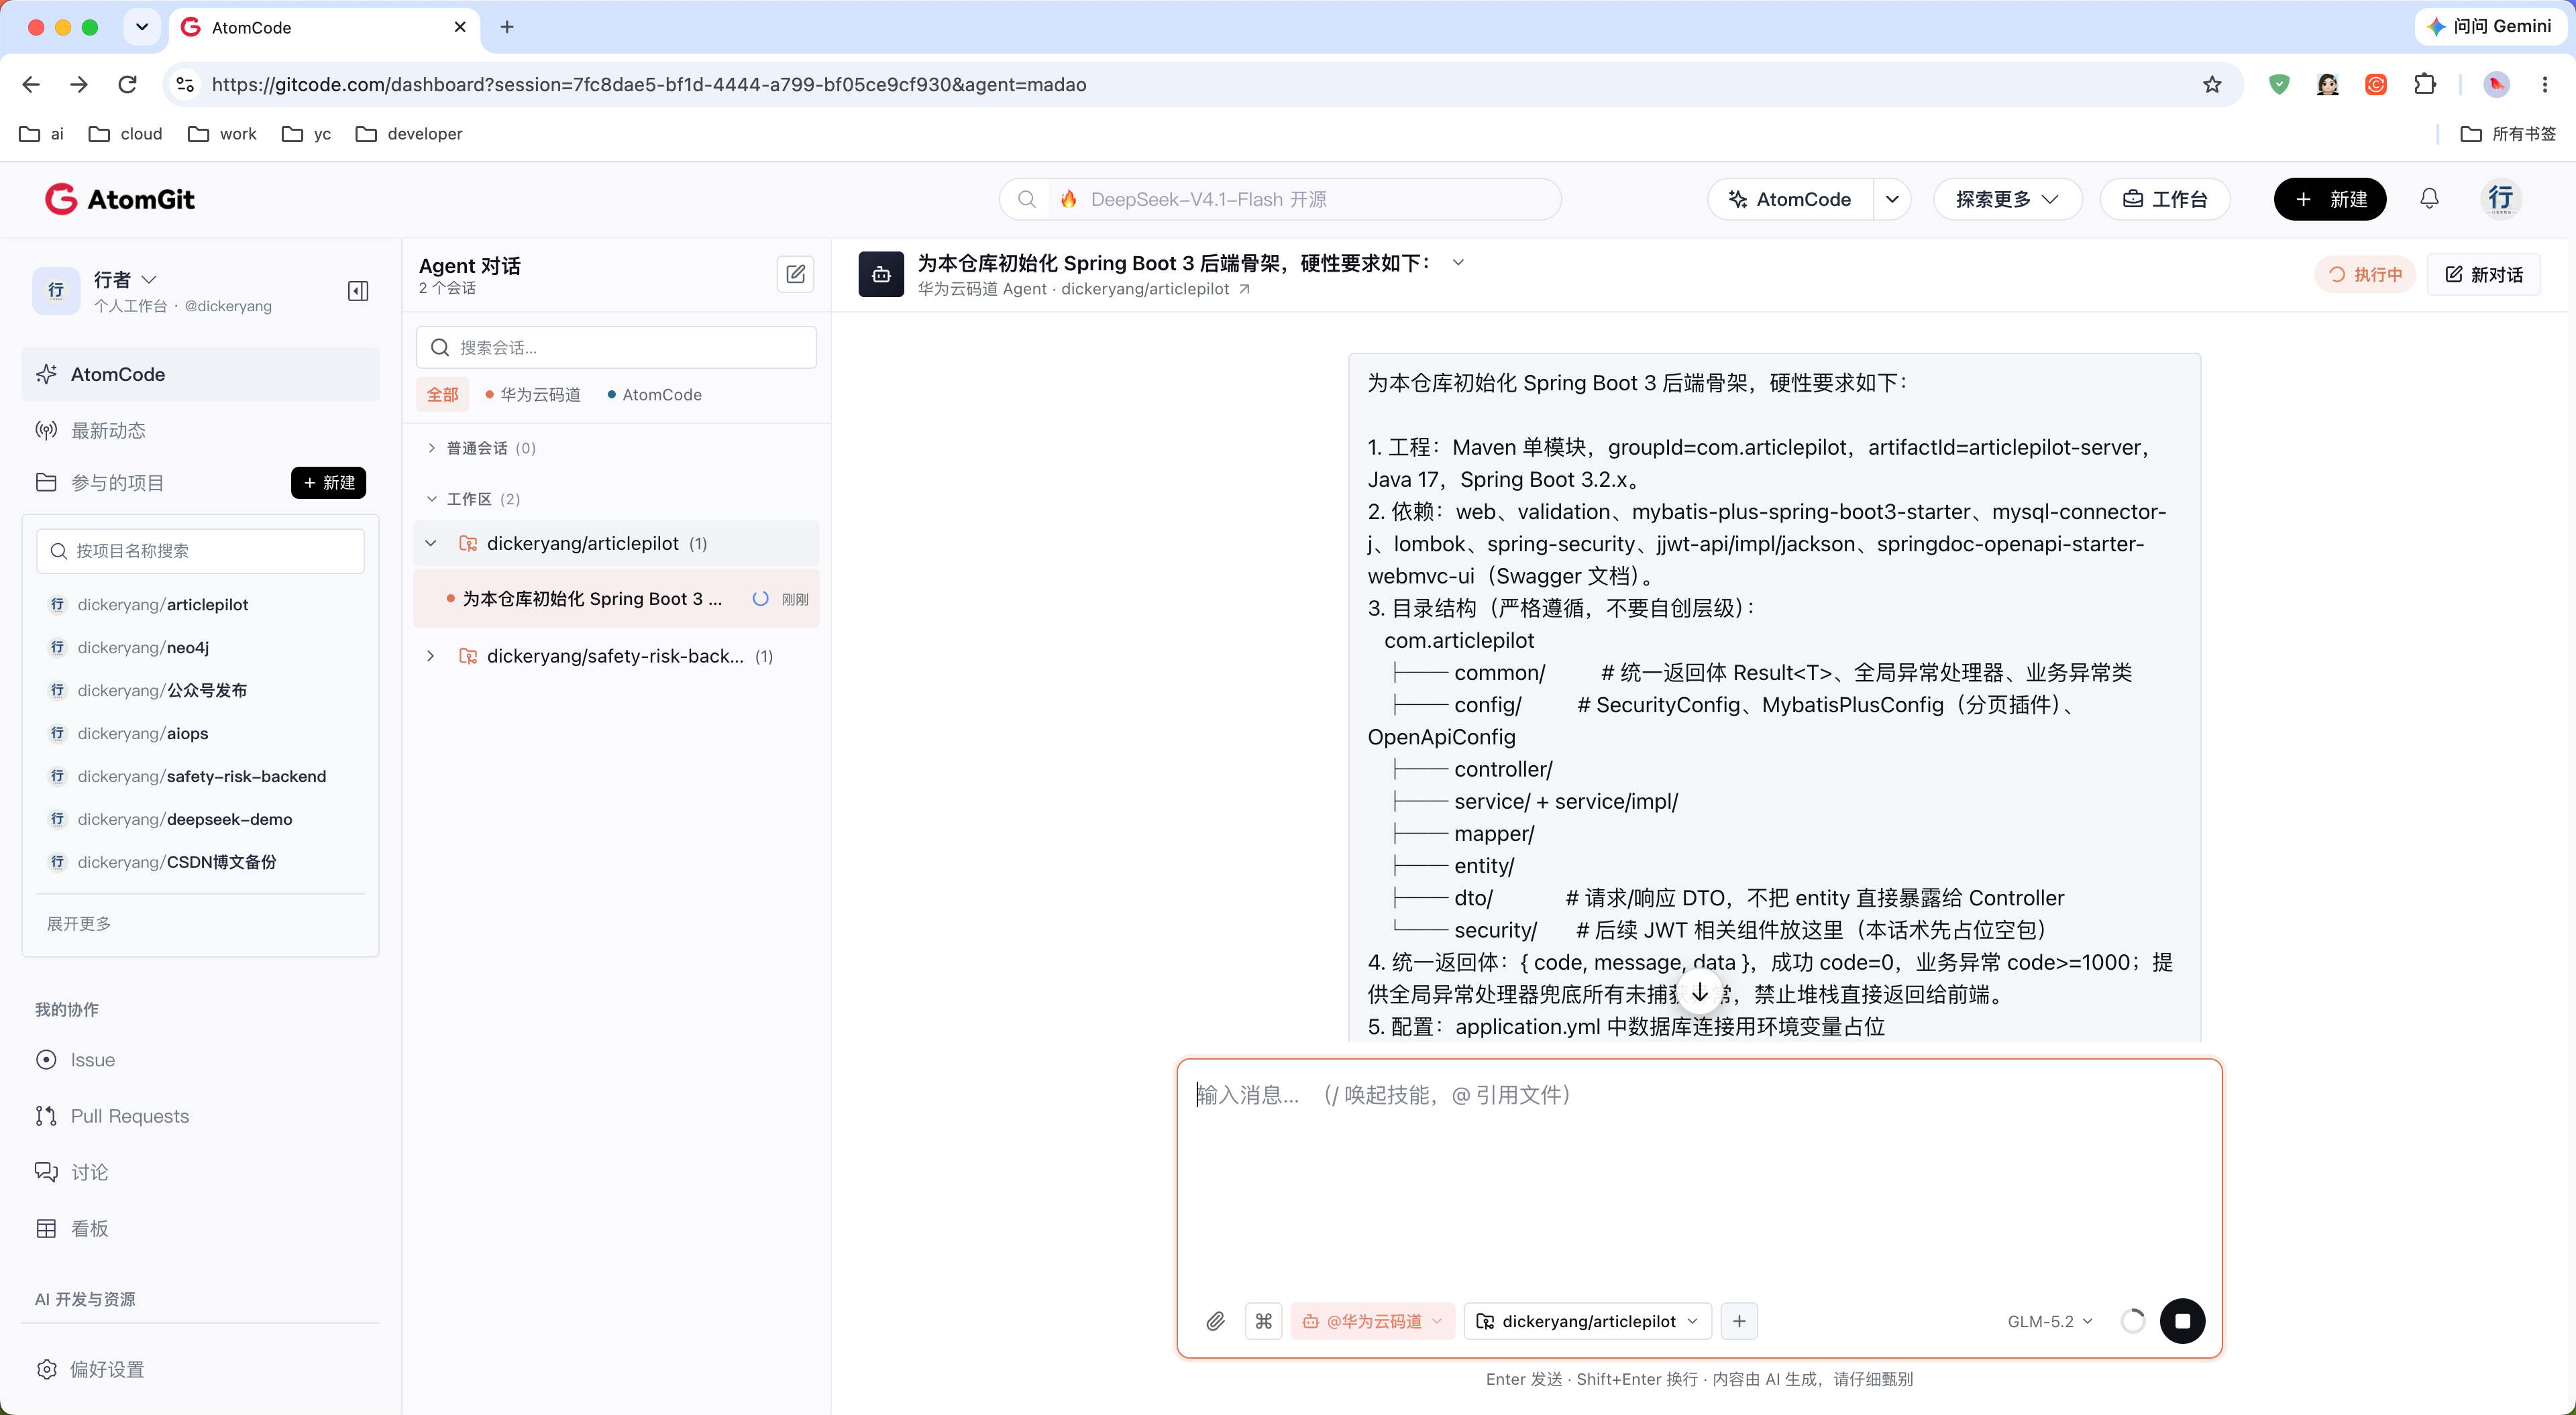
开发现场:AtomCode Agent 工作台,articlepilot 仓库已建立代码库索引,Agent 基于索引读写工程文件
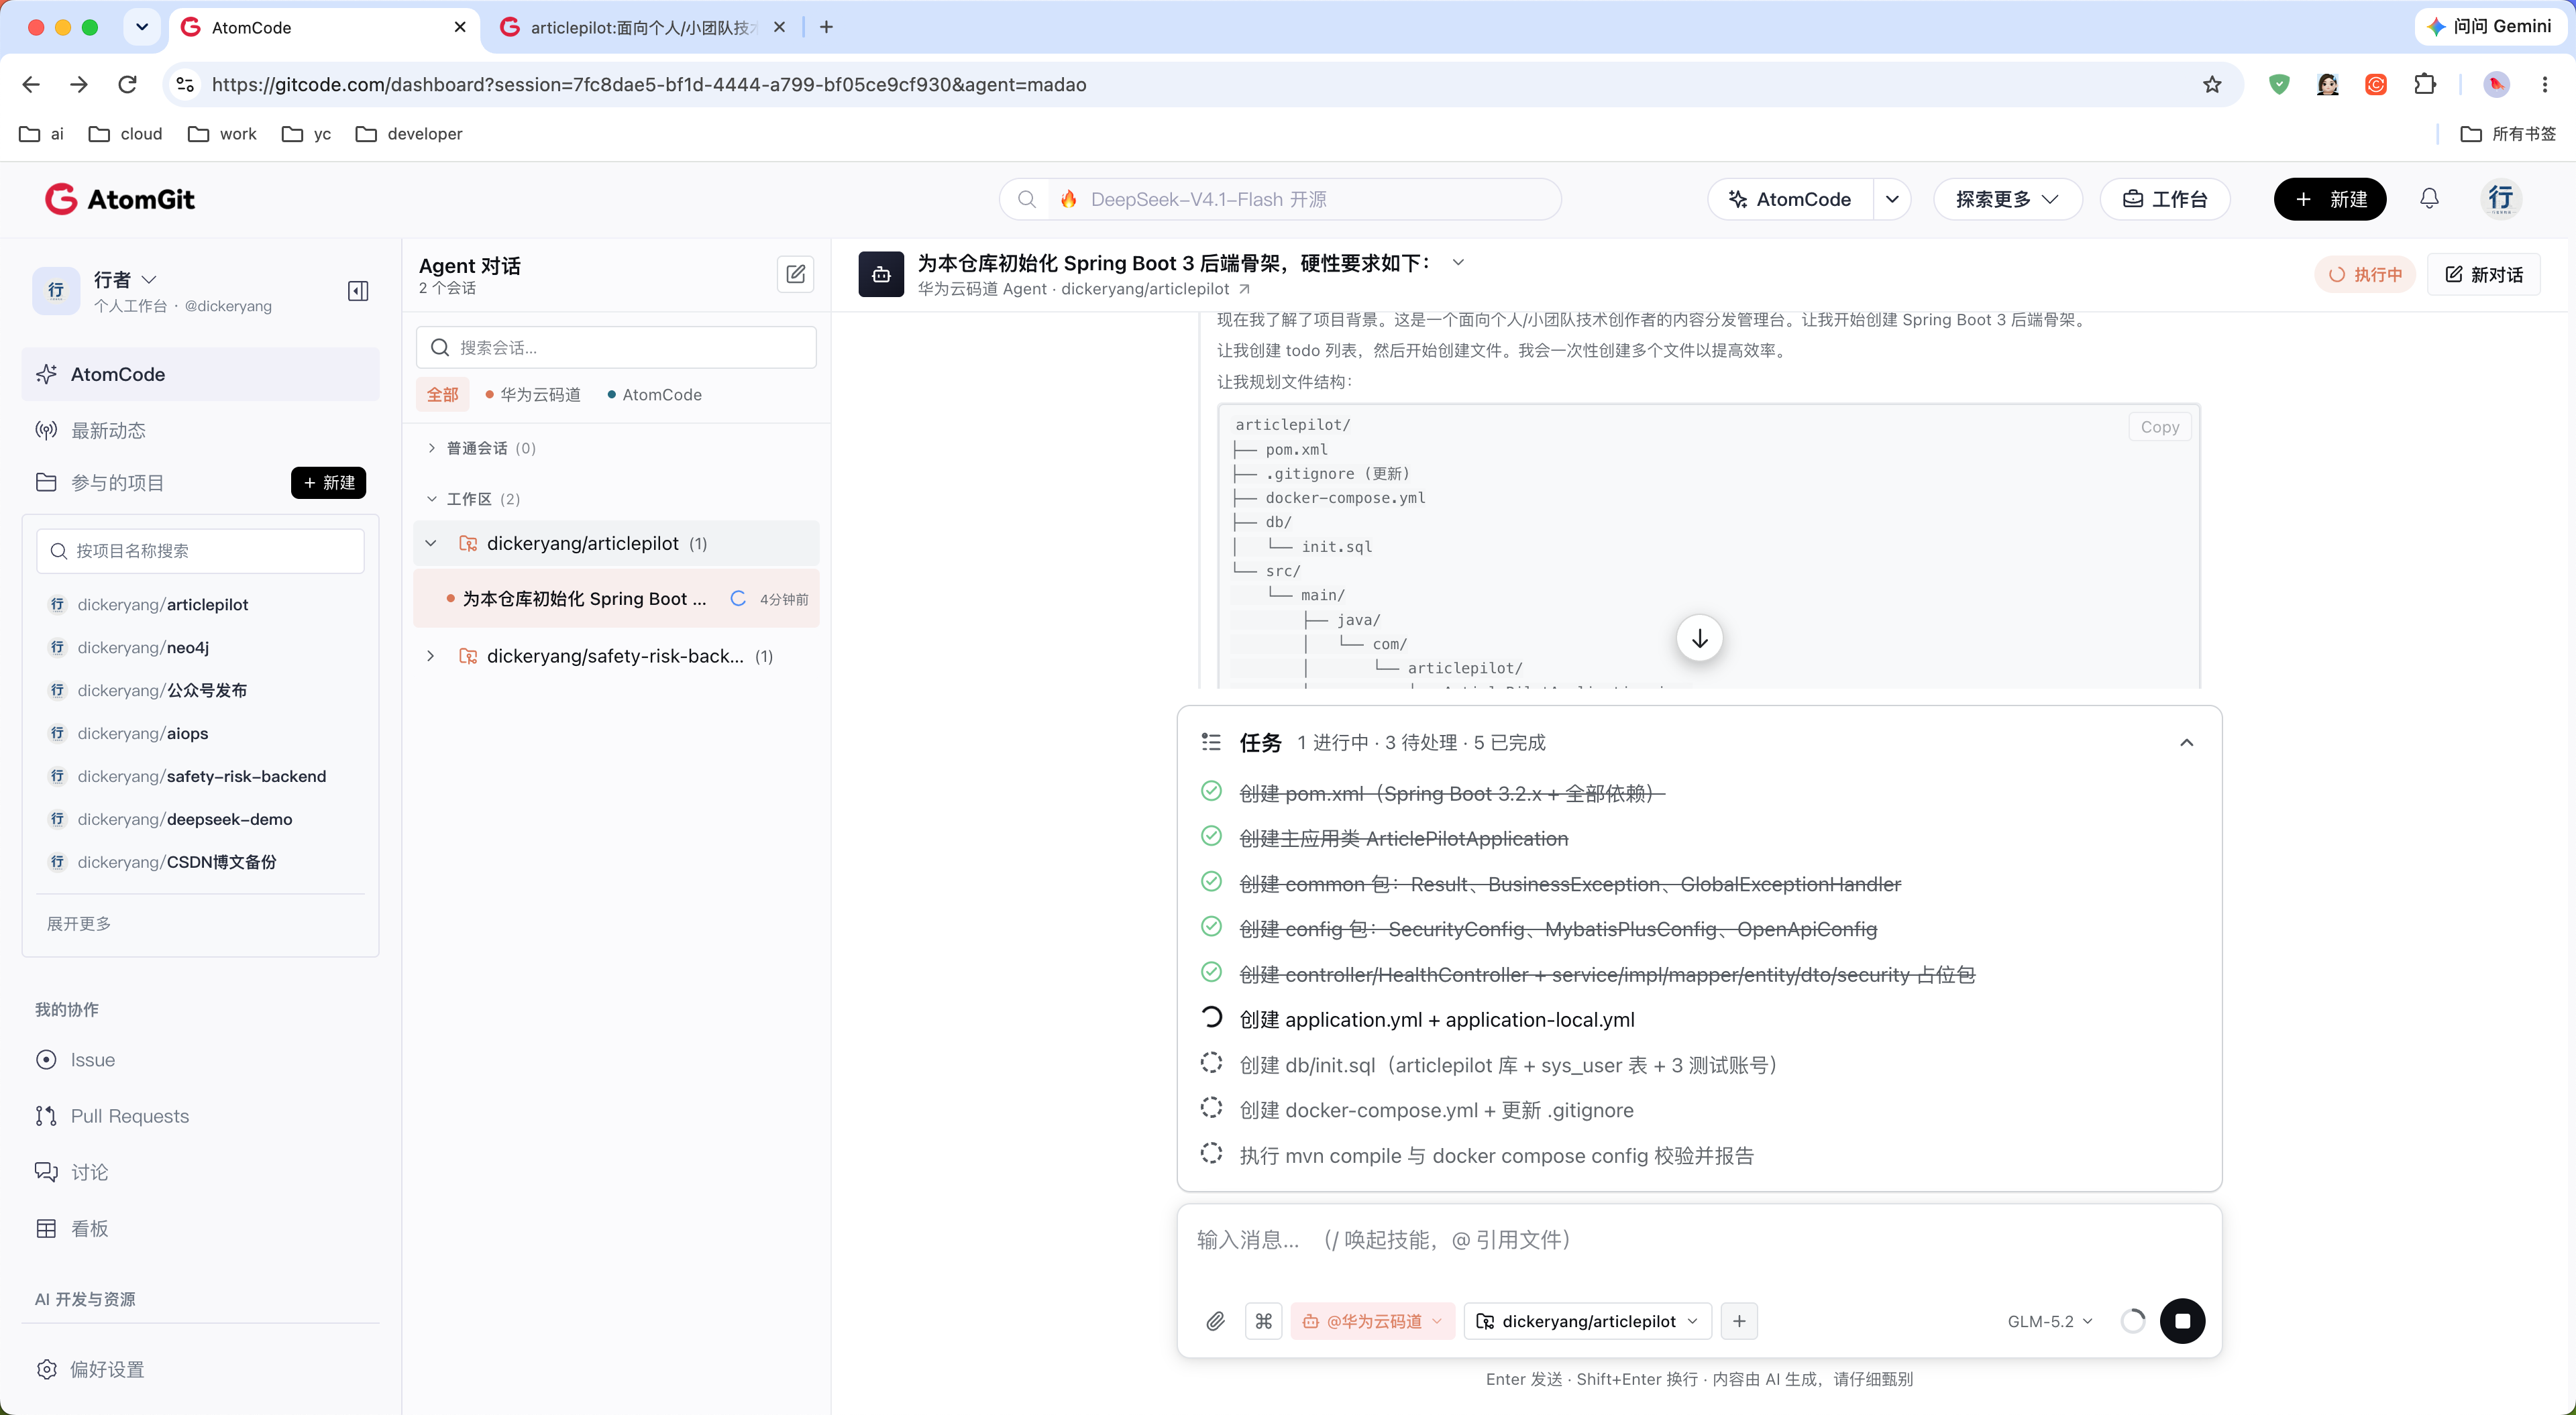
Agent 会话列表:2 个会话贯穿 D1-D5 的全部话术投喂与验收往返,本身就是一份开发日志
3.2 一个典型话术块长什么样
以 D4 的平台适配器话术为例(节选),可以看到我把"硬性要求"和"验收动作"都写在了投喂内容里:
实现多平台适配器体系,要求:

1. 定义接口 PlatformAdapter:platformCode() / requiredFields() /
   validate(PublishDraft) / buildPlan(PublishDraft);
2. 所有实现通过 Spring 注入收集为 Map<platformCode, adapter>,
   新增平台只需新增实现类,不改核心流程;
3. 本期实现 CsdnAdapter、JuejinAdapter、WechatMpAdapter 三个适配器,
   校验规则各不相同,失败信息要具体到字段与原因;
4. 完成后 mvn test 报告结果,单元测试覆盖每个适配器的合法/非法用例。
AI 对这类结构化约束的执行质量很高——三个适配器一次生成即通过编译,校验逻辑与话术要求完全一致。真正需要我介入修正的,反而是话术没写到的细节,下一章的踩坑记录会具体展开。
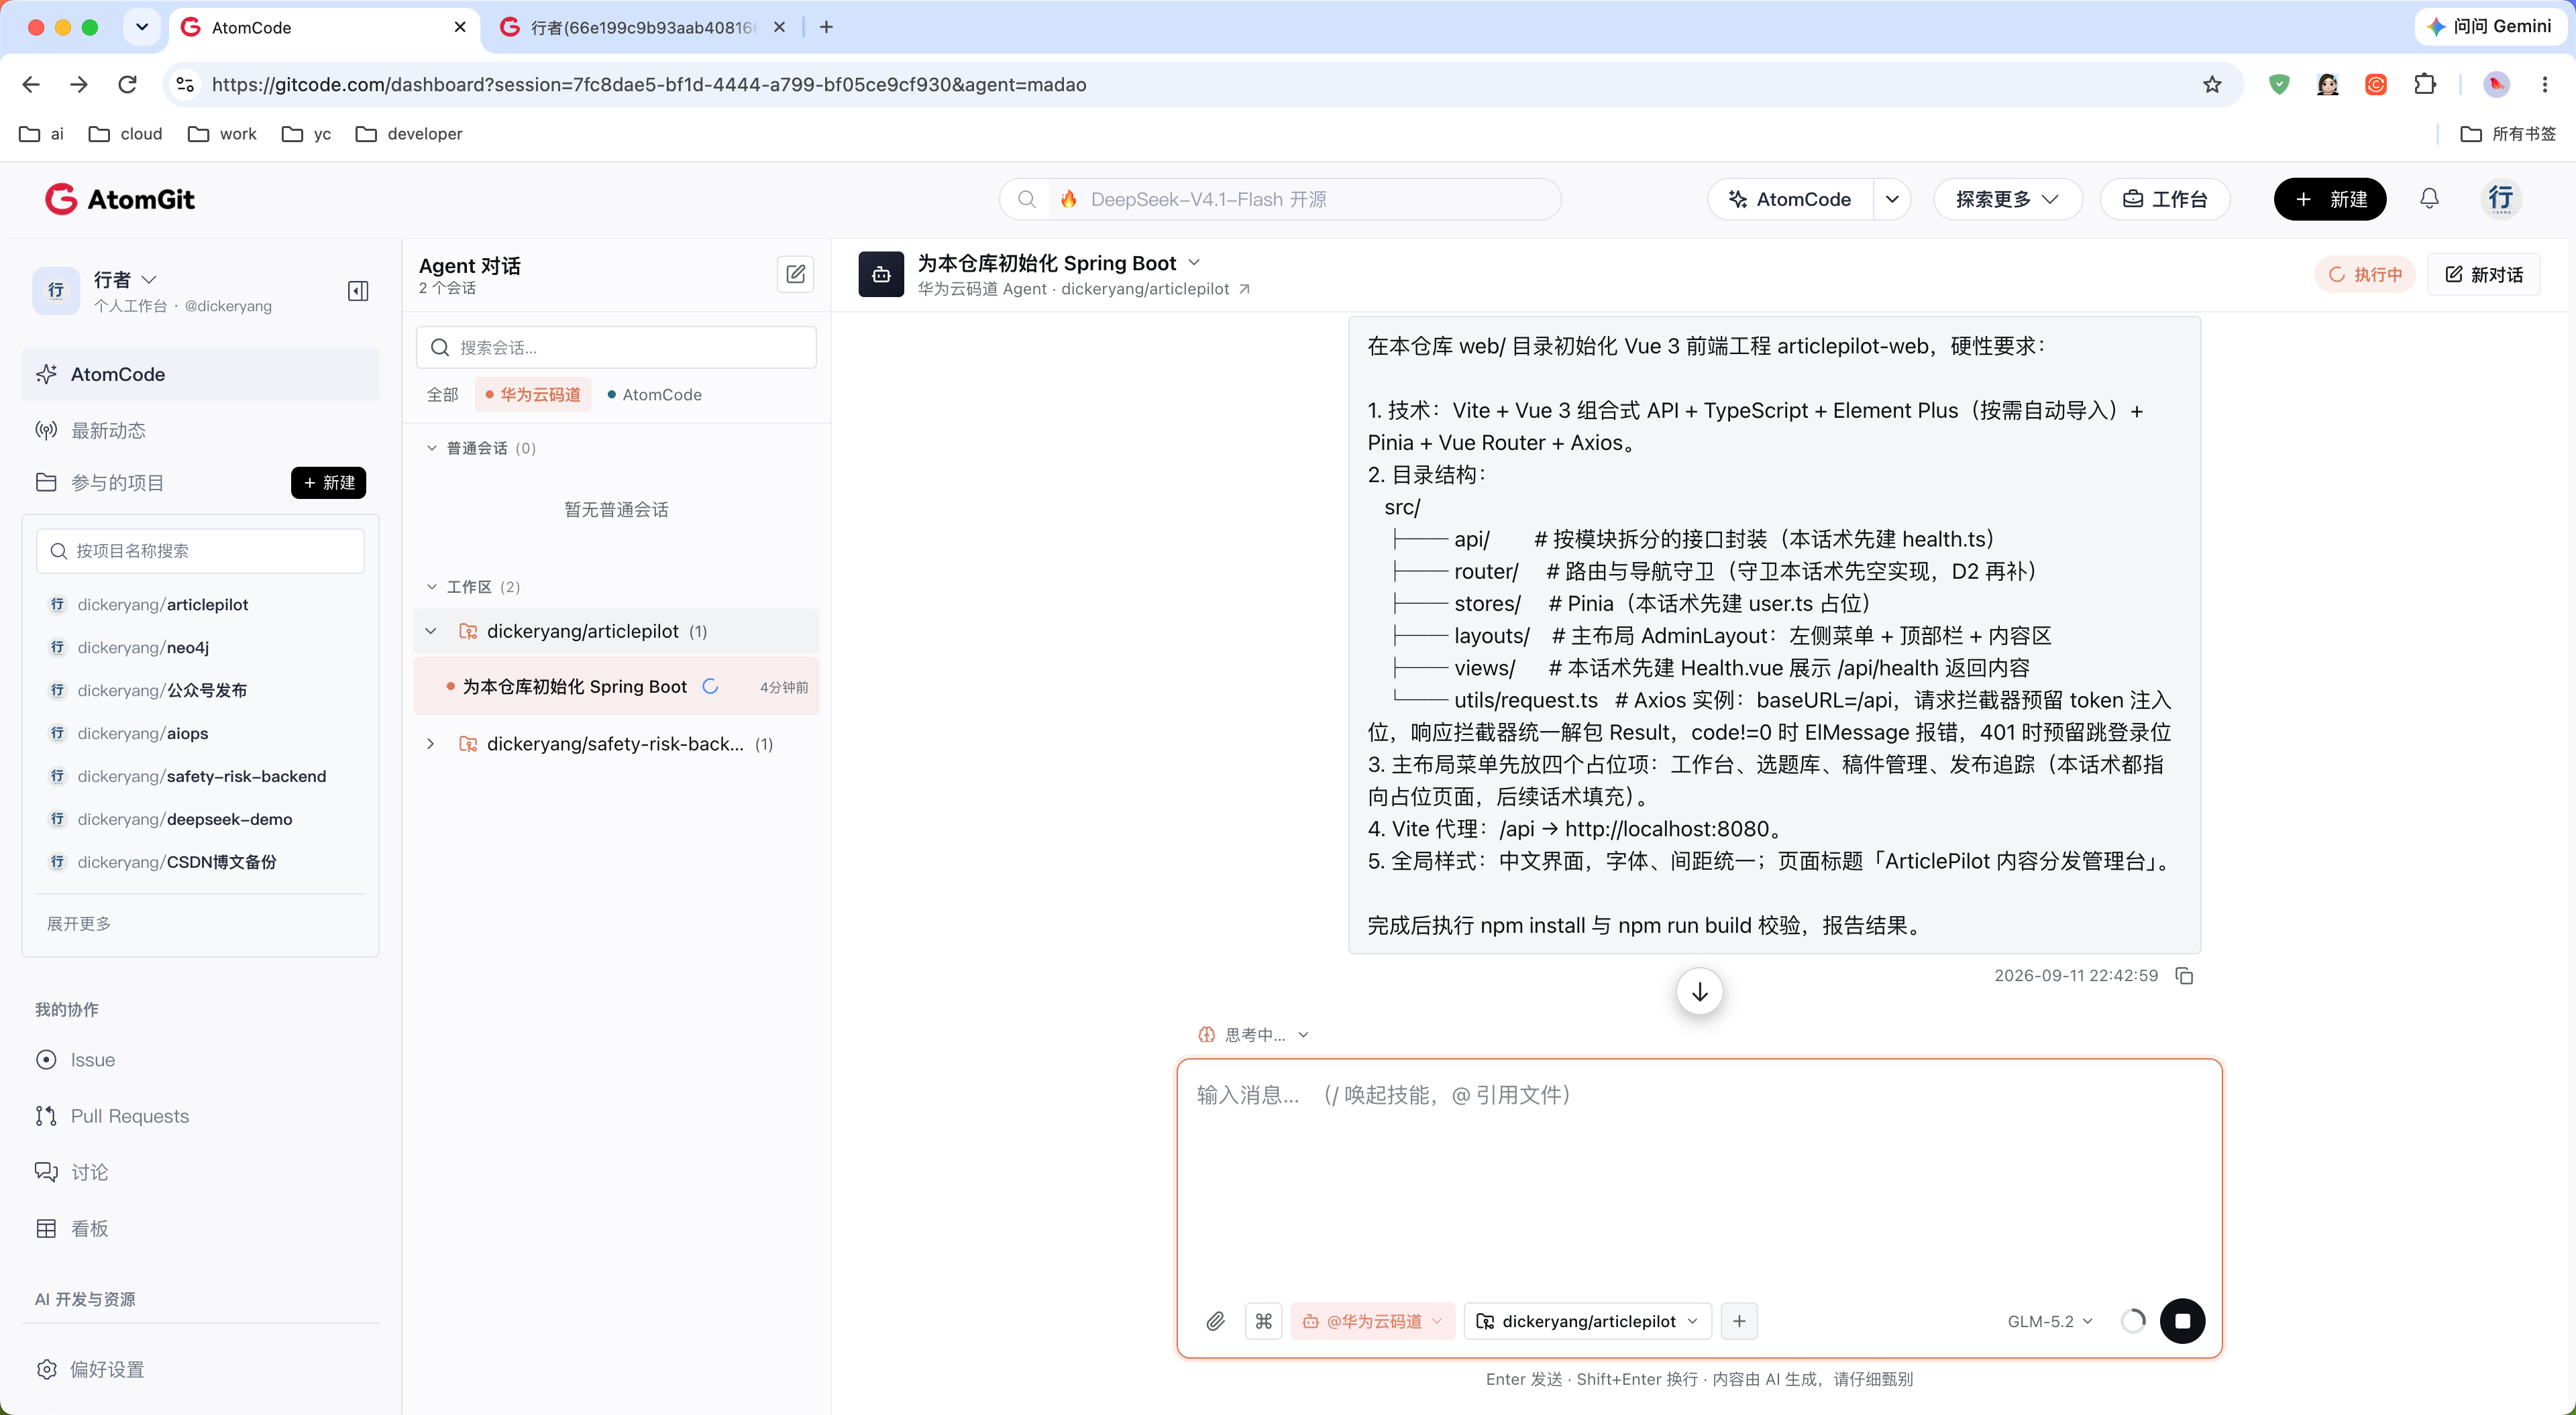
D4 适配器话术投喂后的会话现场:Agent 按约束生成三个适配器并回报 mvn test 结果
四、功能演示:从选题到发布追踪的完整闭环
项目完成后,我用 docker compose up -d --build 一条命令拉起整站(MySQL + 后端 + nginx 托管的前端),浏览器访问 8081 端口完成以下全链路验证。
4.1 登录与三角色权限
本地起服务只需两步:IDEA 里 Debug 启动 ArticlePilotApplication(后端 8081),前端目录执行 yarn dev 起 Vite 调试服务(5173)。之后使用预置的三个测试账号(管理员/作者/访客)分别登录,验证 RBAC 生效:作者看不到用户管理入口,访客对看板以外的写操作被后端 403 拦截,越权请求返回统一的错误格式而非堆栈。
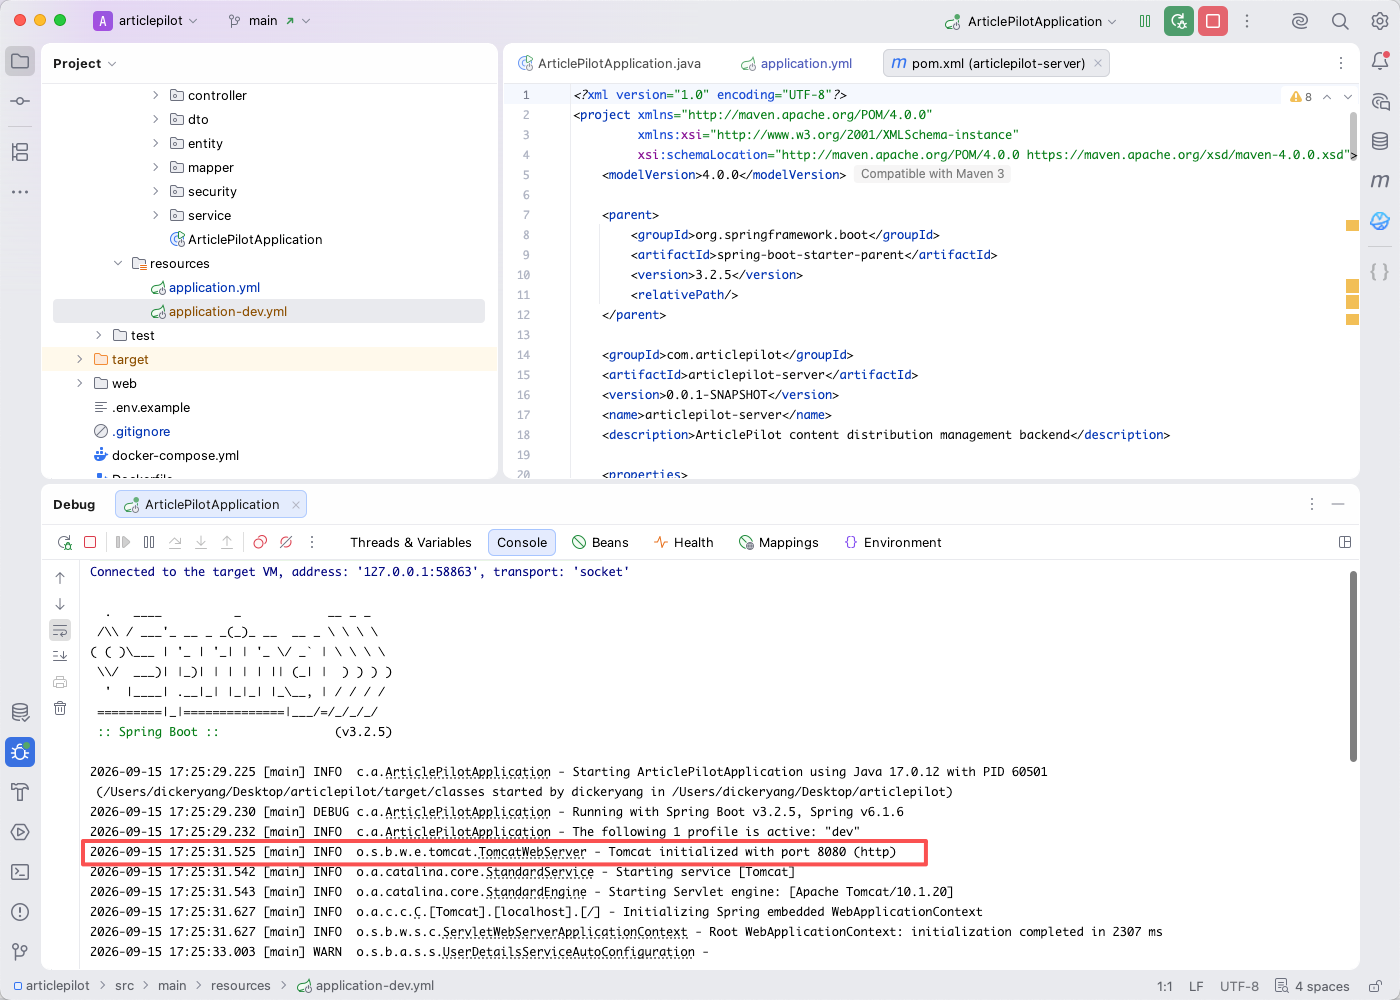
后端启动:IDEA 以 Debug 方式运行 ArticlePilotApplication,可直接断点排查请求链路
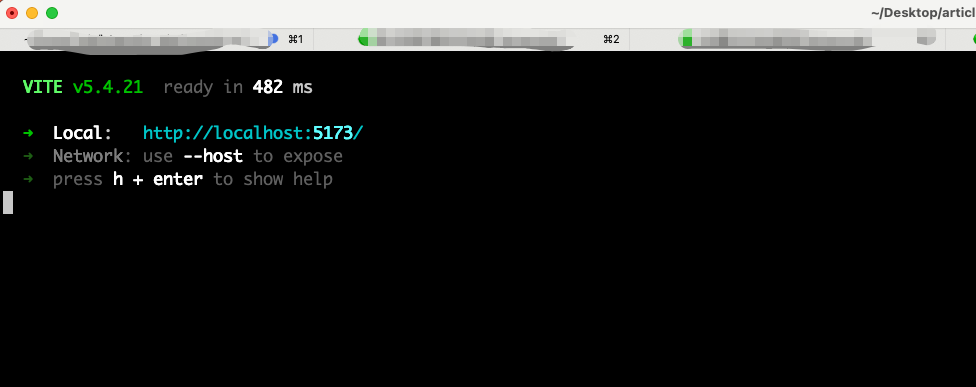
前端启动:yarn dev 后 Vite 不到 1 秒即就绪(ready in 482 ms),本地调试地址
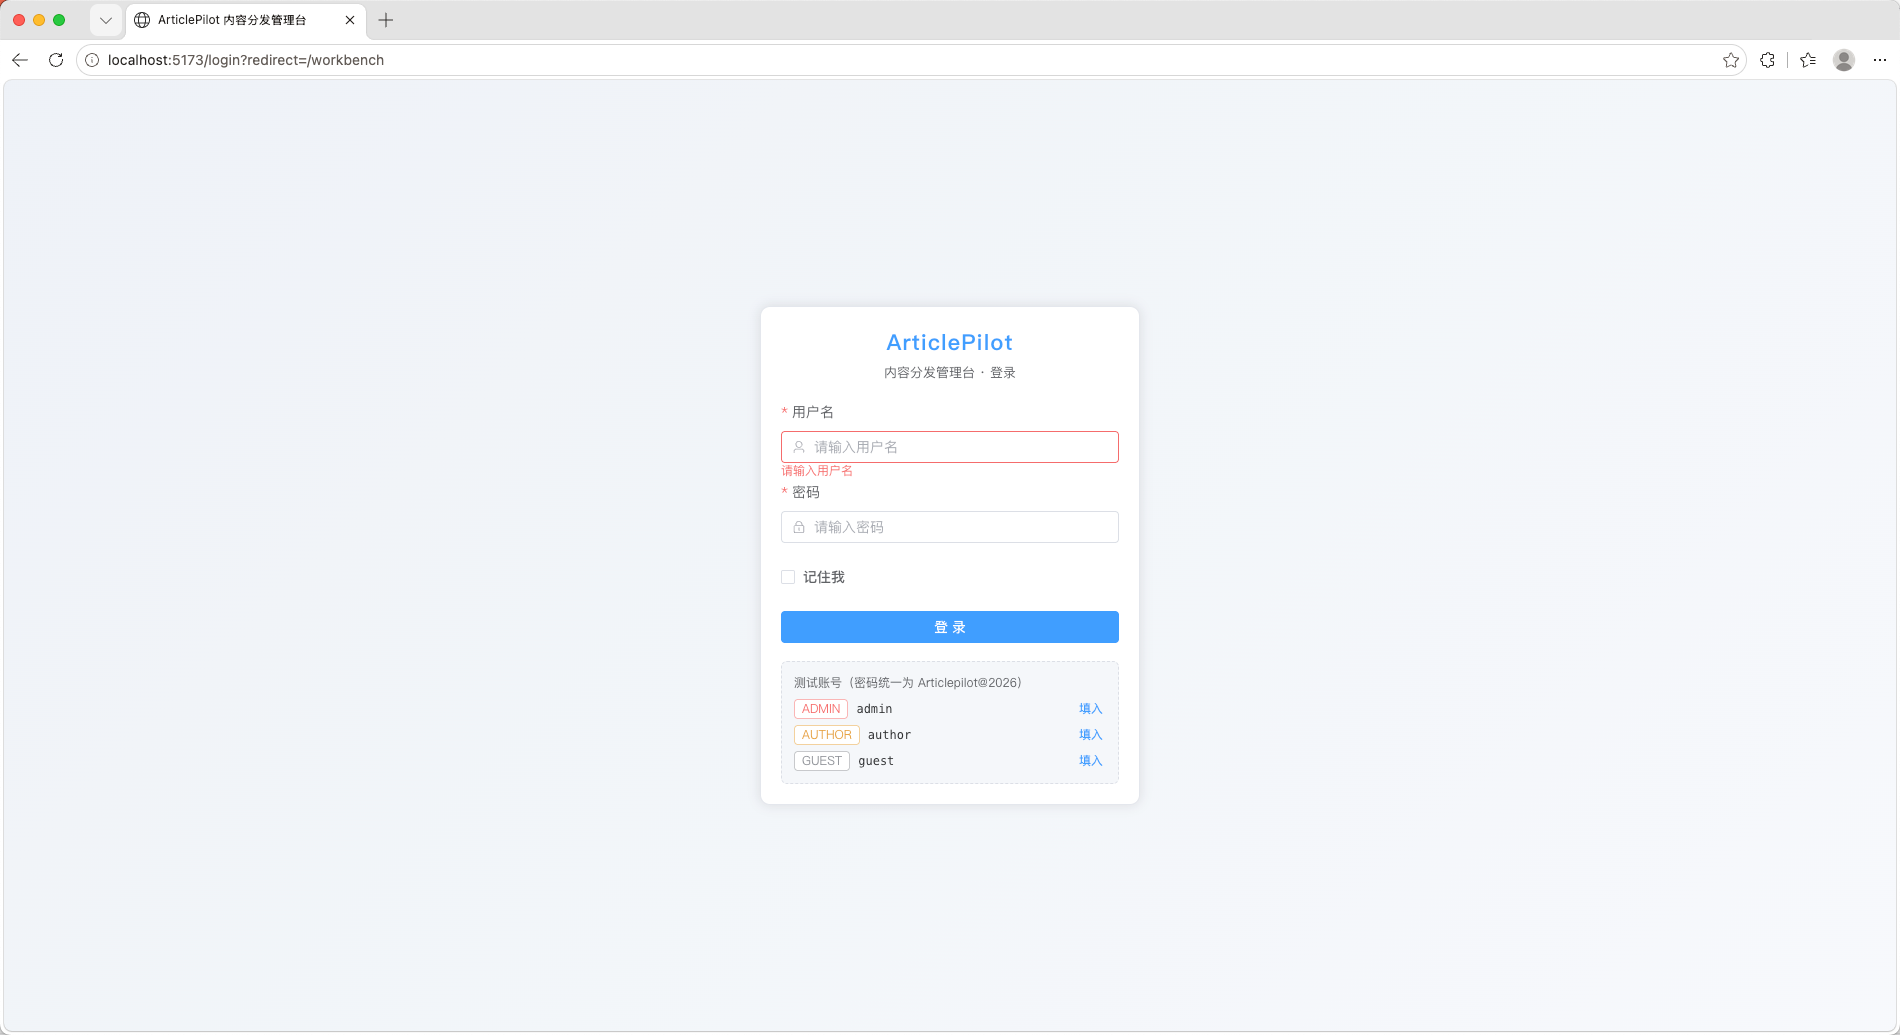
登录页:admin / author / guest 三个测试账号直接列在页面下方,点「填入」免输入即可体验三种角色
4.2 选题库与稿件管理
新建选题后按状态机流转(IDEA → PLANNED → WRITING),再关联创建稿件。稿件侧支持编辑与版本快照,两个账号并发编辑同一稿件时,后者会收到"已被他人修改"的 409 提示,乐观锁生效。
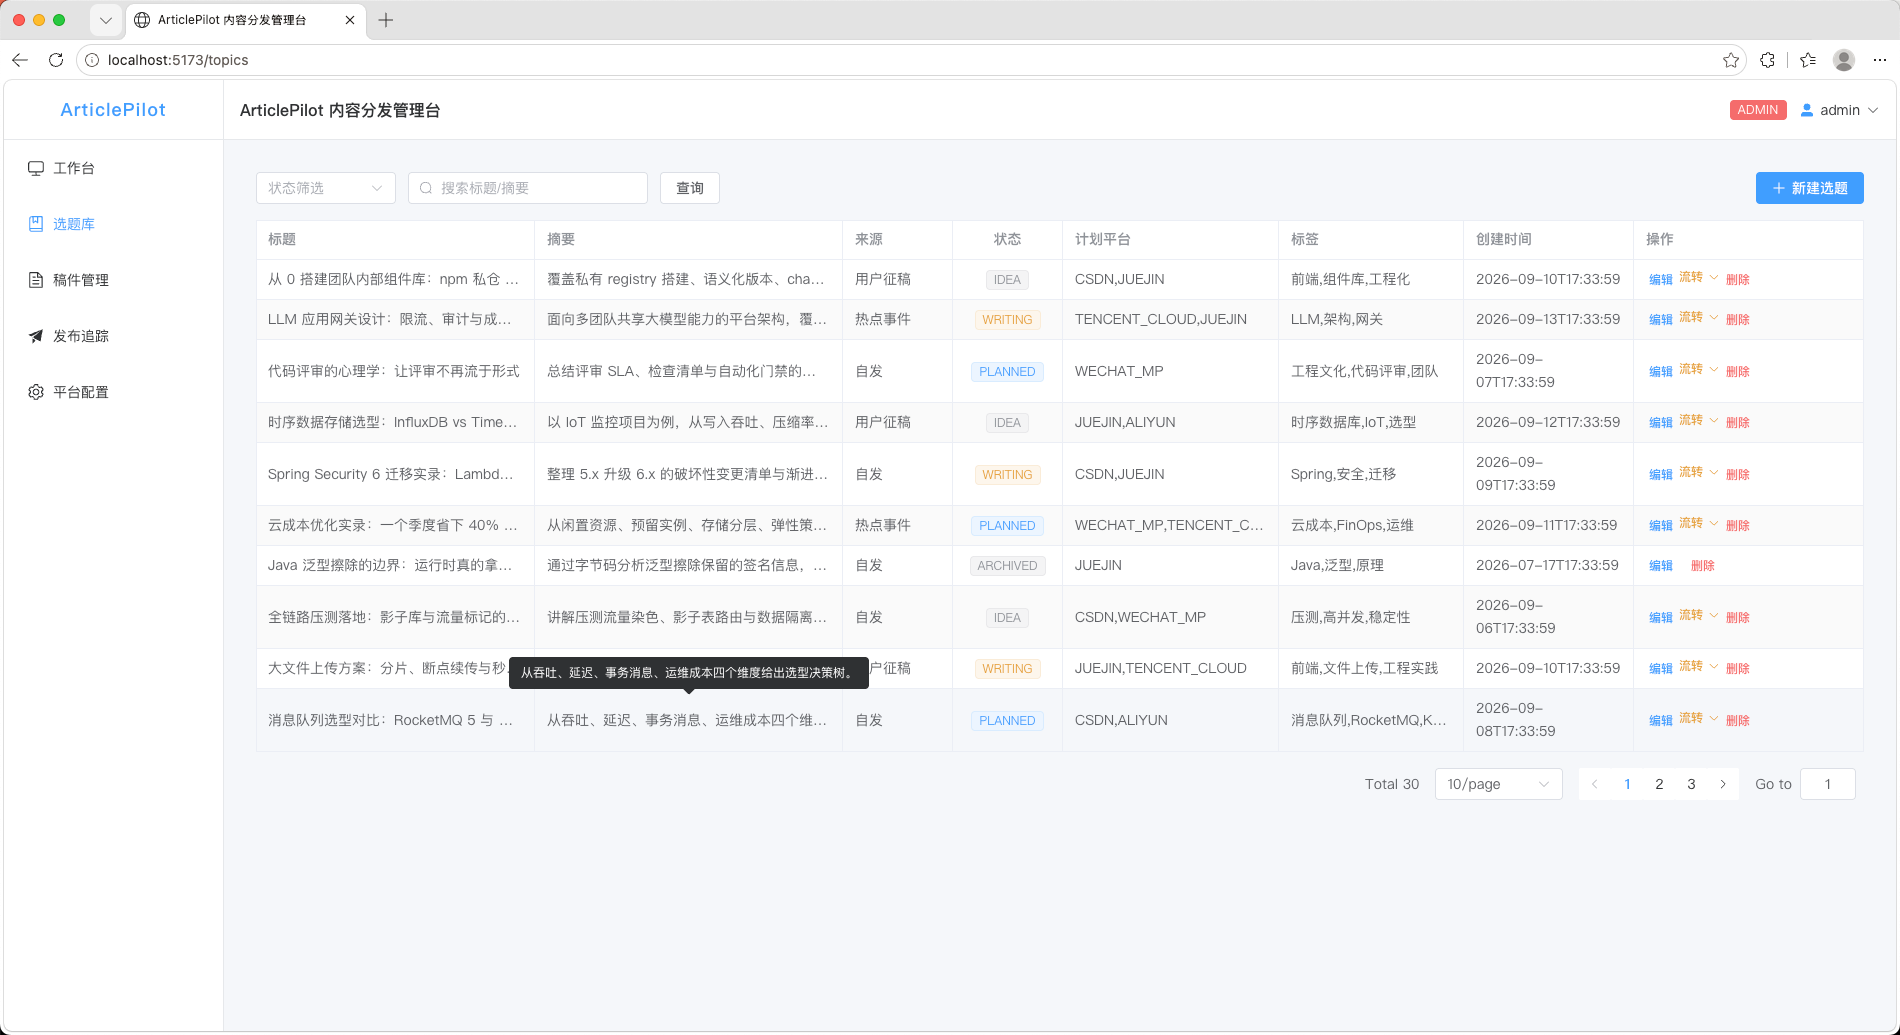
选题库列表:按状态筛选,每条选题带摘要与来源(用户征稿/热点事件/自发),标题即后续稿件的雏形
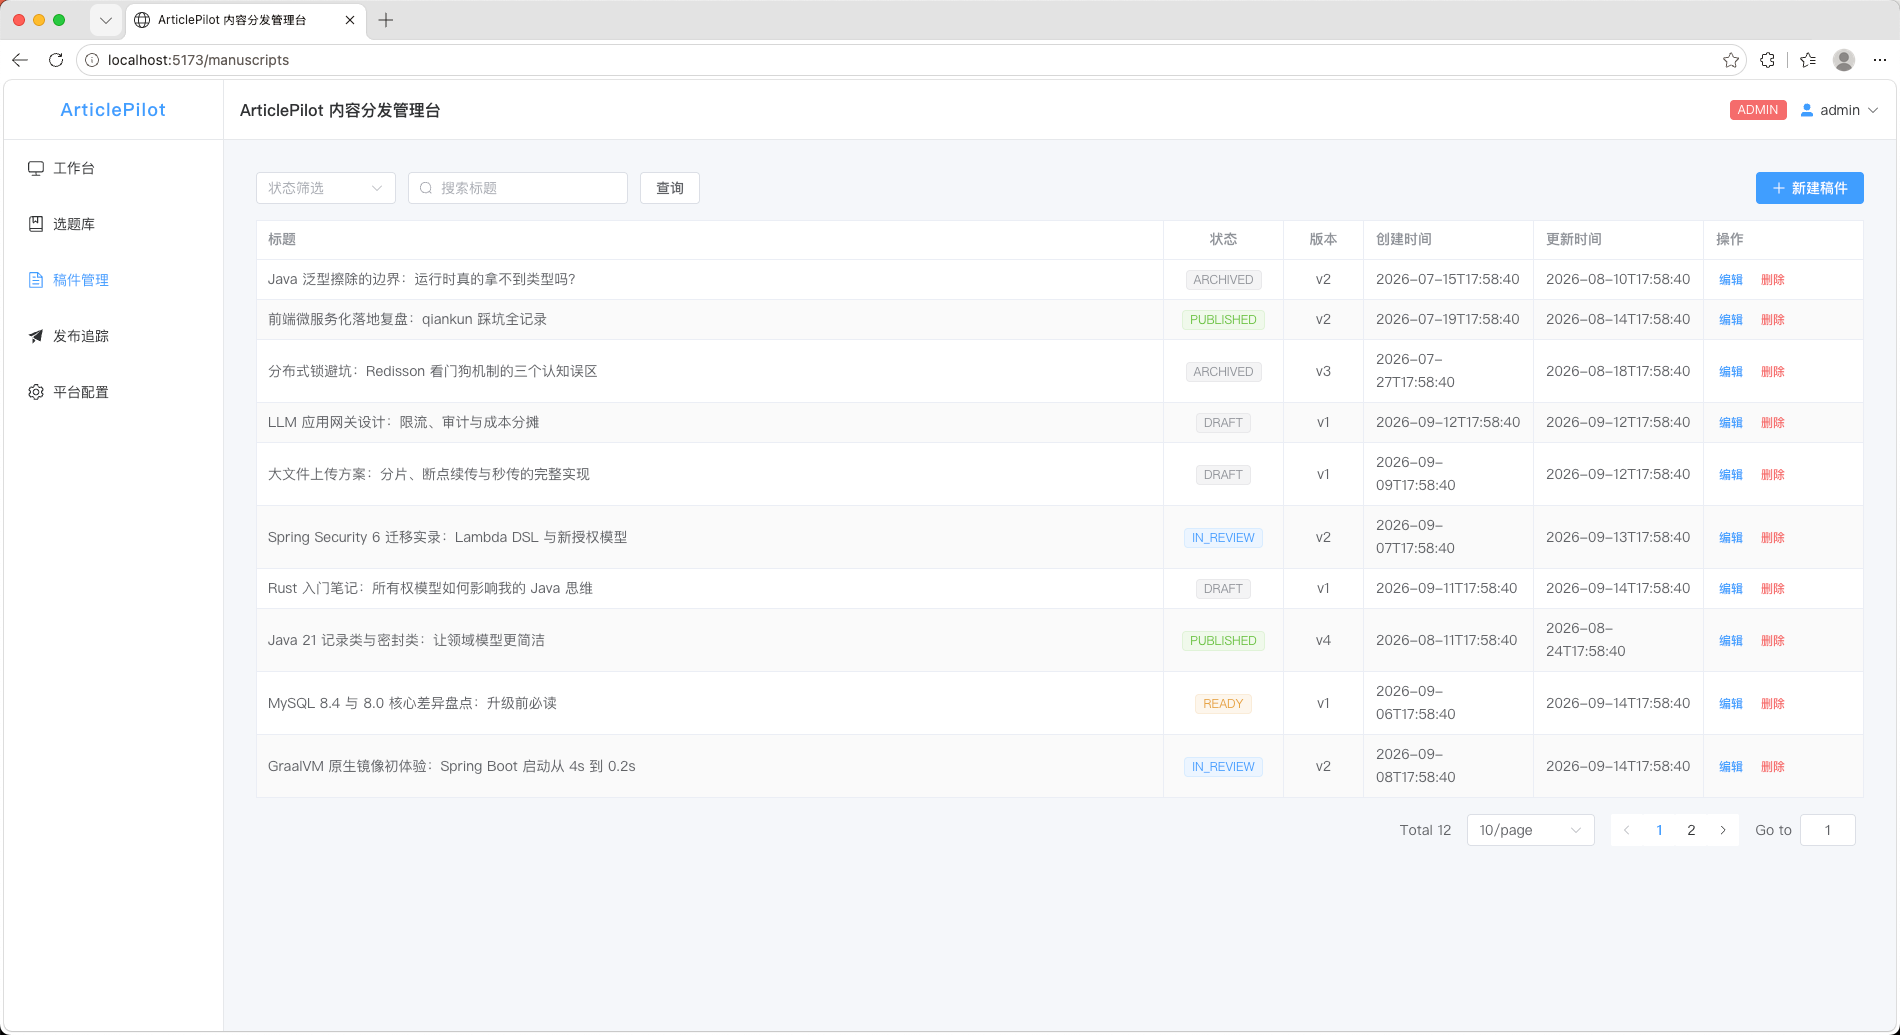
稿件管理:DRAFT / IN_REVIEW / PUBLISHED / ARCHIVED 各状态稿件同屏可见,状态机流转的结果一目了然
4.3 平台适配与发布追踪
稿件流转到 READY 后,为它逐平台填写适配字段(表单项按适配器 requiredFields 动态渲染),提交发布计划。缺封面、摘要超长这类校验错误会精确提示到字段。发布计划状态更新为已发布并填入链接后,追踪看板的统计卡片实时同步。
发布计划自身的生命周期也是一台状态机,与稿件状态机的区别在于它多出 FAILED 和 CANCELLED 两个"异常出口"——发布动作可能因平台校验失败而失败,也可能被作者主动取消:
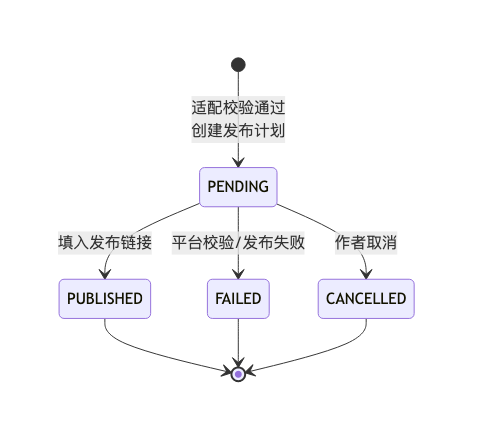
稿件状态机(§2.2)管"这篇稿子能不能发",发布计划状态机管"发到这个平台的动作结果如何"——两台状态机通过"只有 READY 稿件才能创建 PENDING 计划"这条不变量衔接。
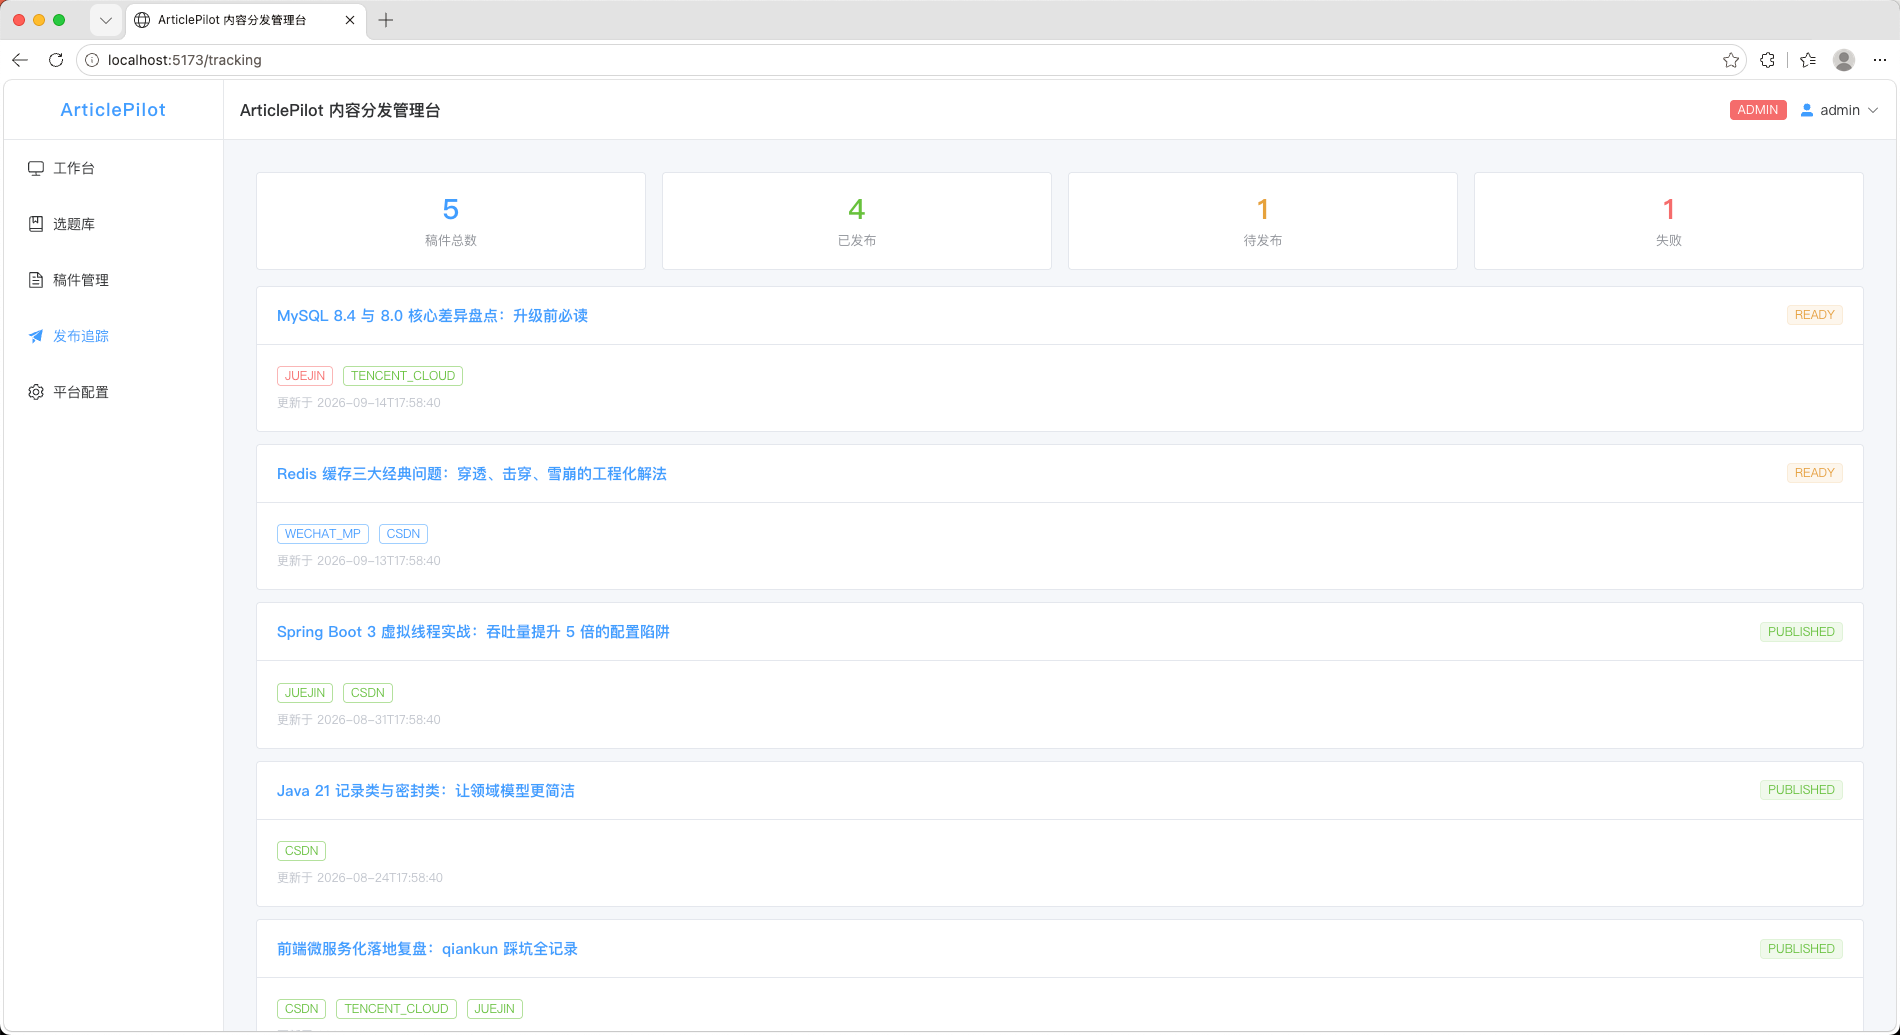
发布追踪:每篇稿件一张卡片,卡片上按平台展示状态徽标(CSDN/JUEJIN/WECHAT_MP/TENCENT_CLOUD…),哪个平台发过、哪个平台还没发一眼可辨
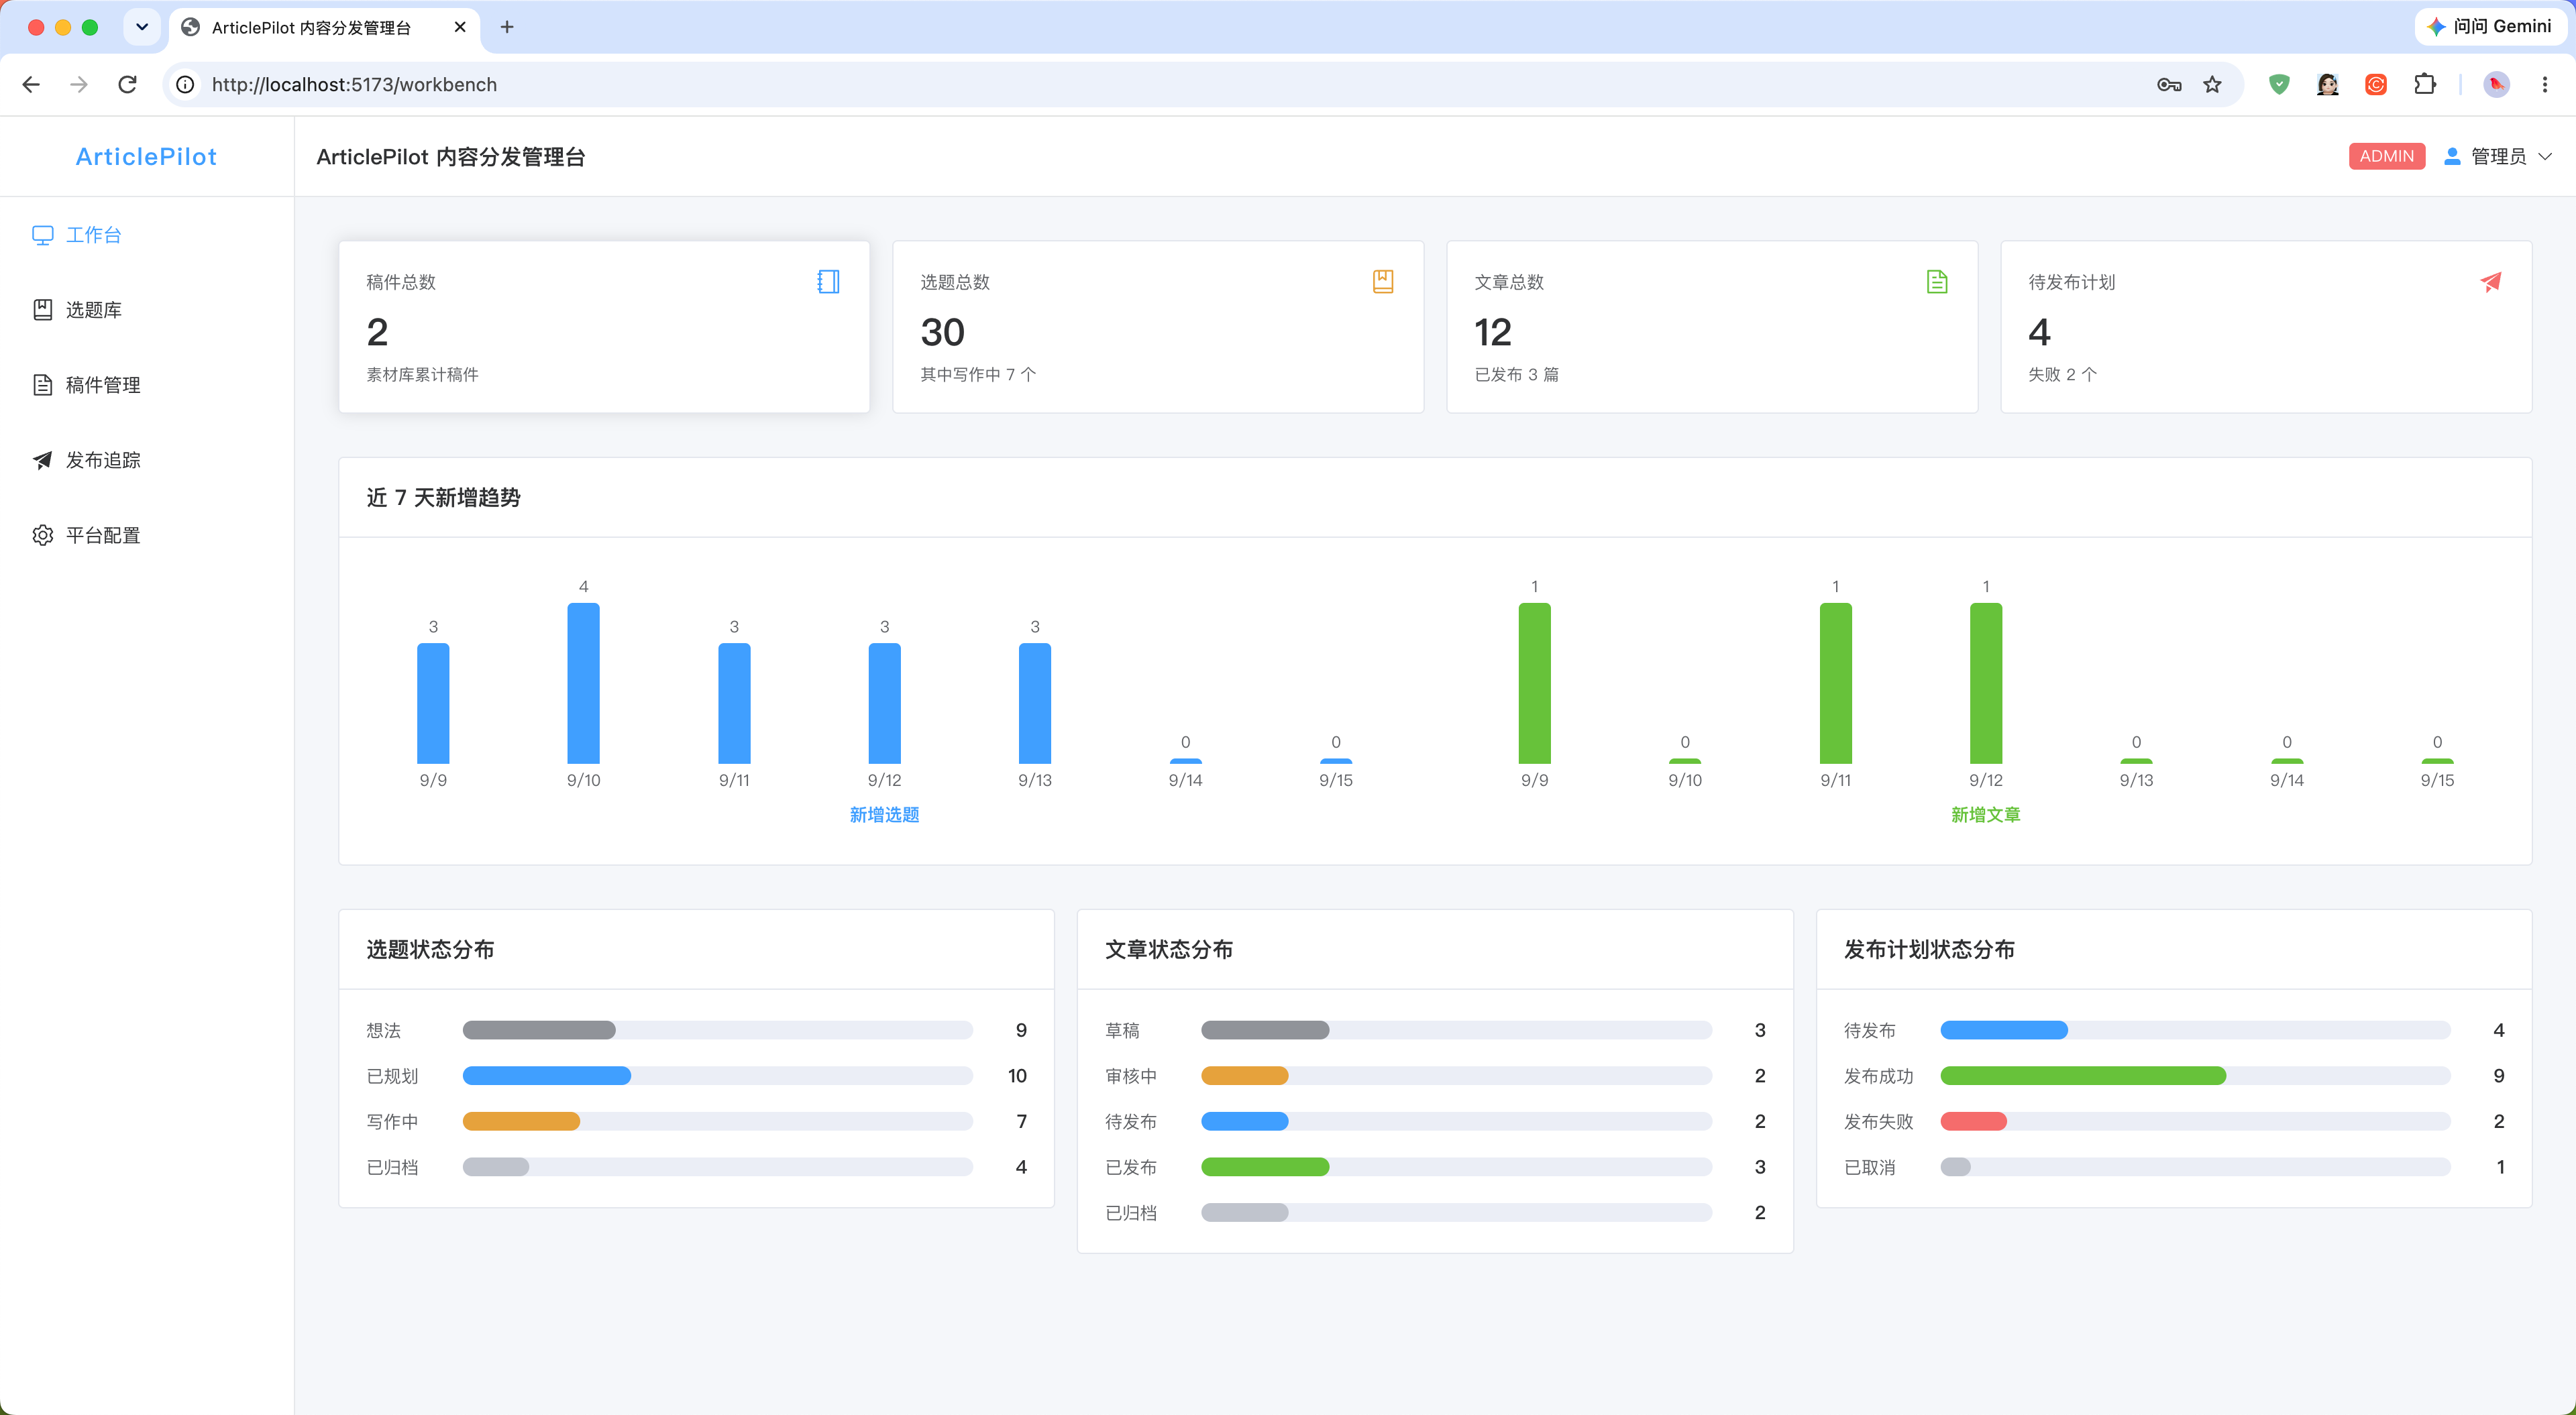
工作台首页:素材库累计稿件、选题总数、近 7 天新增趋势与选题/文章状态分布图,创作管道的健康度尽收一屏
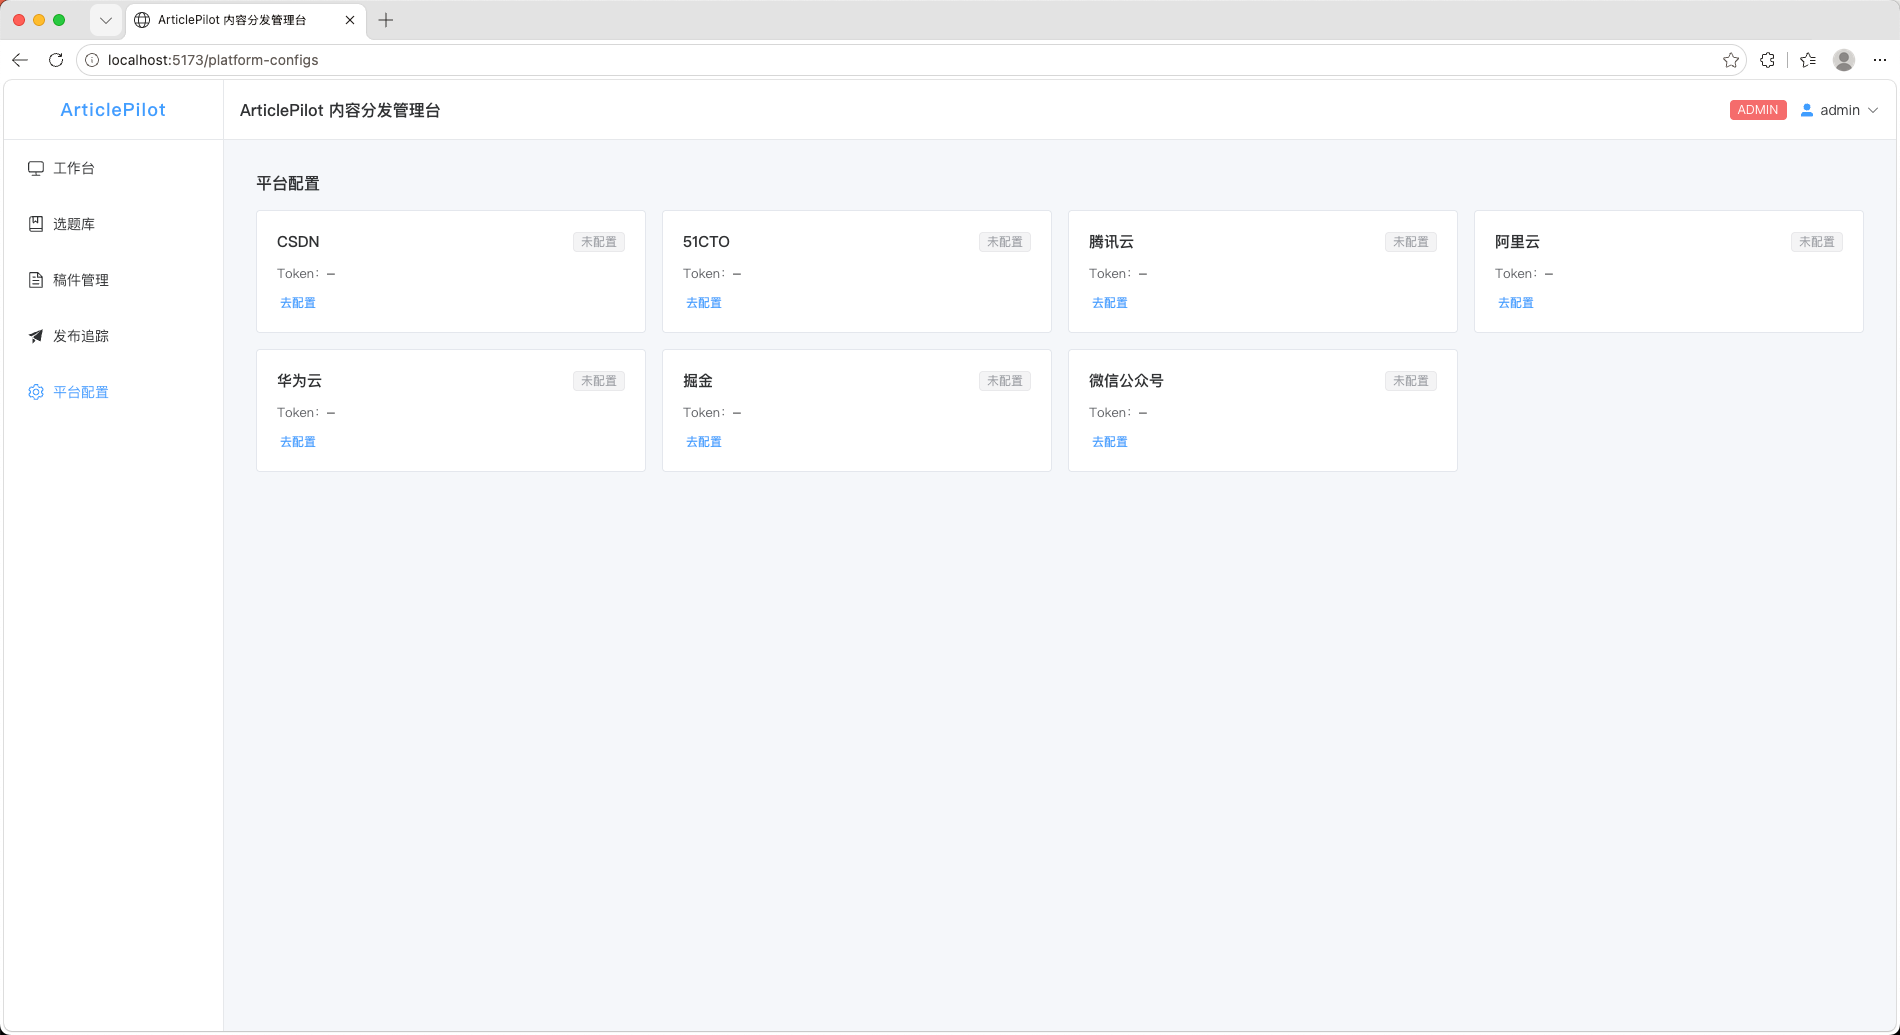
平台配置页:各平台 Token 以掩码形式回显(对应 §2.3 安全红线),待配置的平台显示「去配置」入口
平台 token 的安全展示在配置页完成:保存时 AES/GCM 加密落库,页面只回显末 4 位掩码(对应 §2.3 的安全红线与 §5.3 的踩坑修复)。
4.4 接口文档
后端集成 springdoc-openapi,全部接口可在 Swagger 页面浏览与调试,统一返回体结构一目了然。
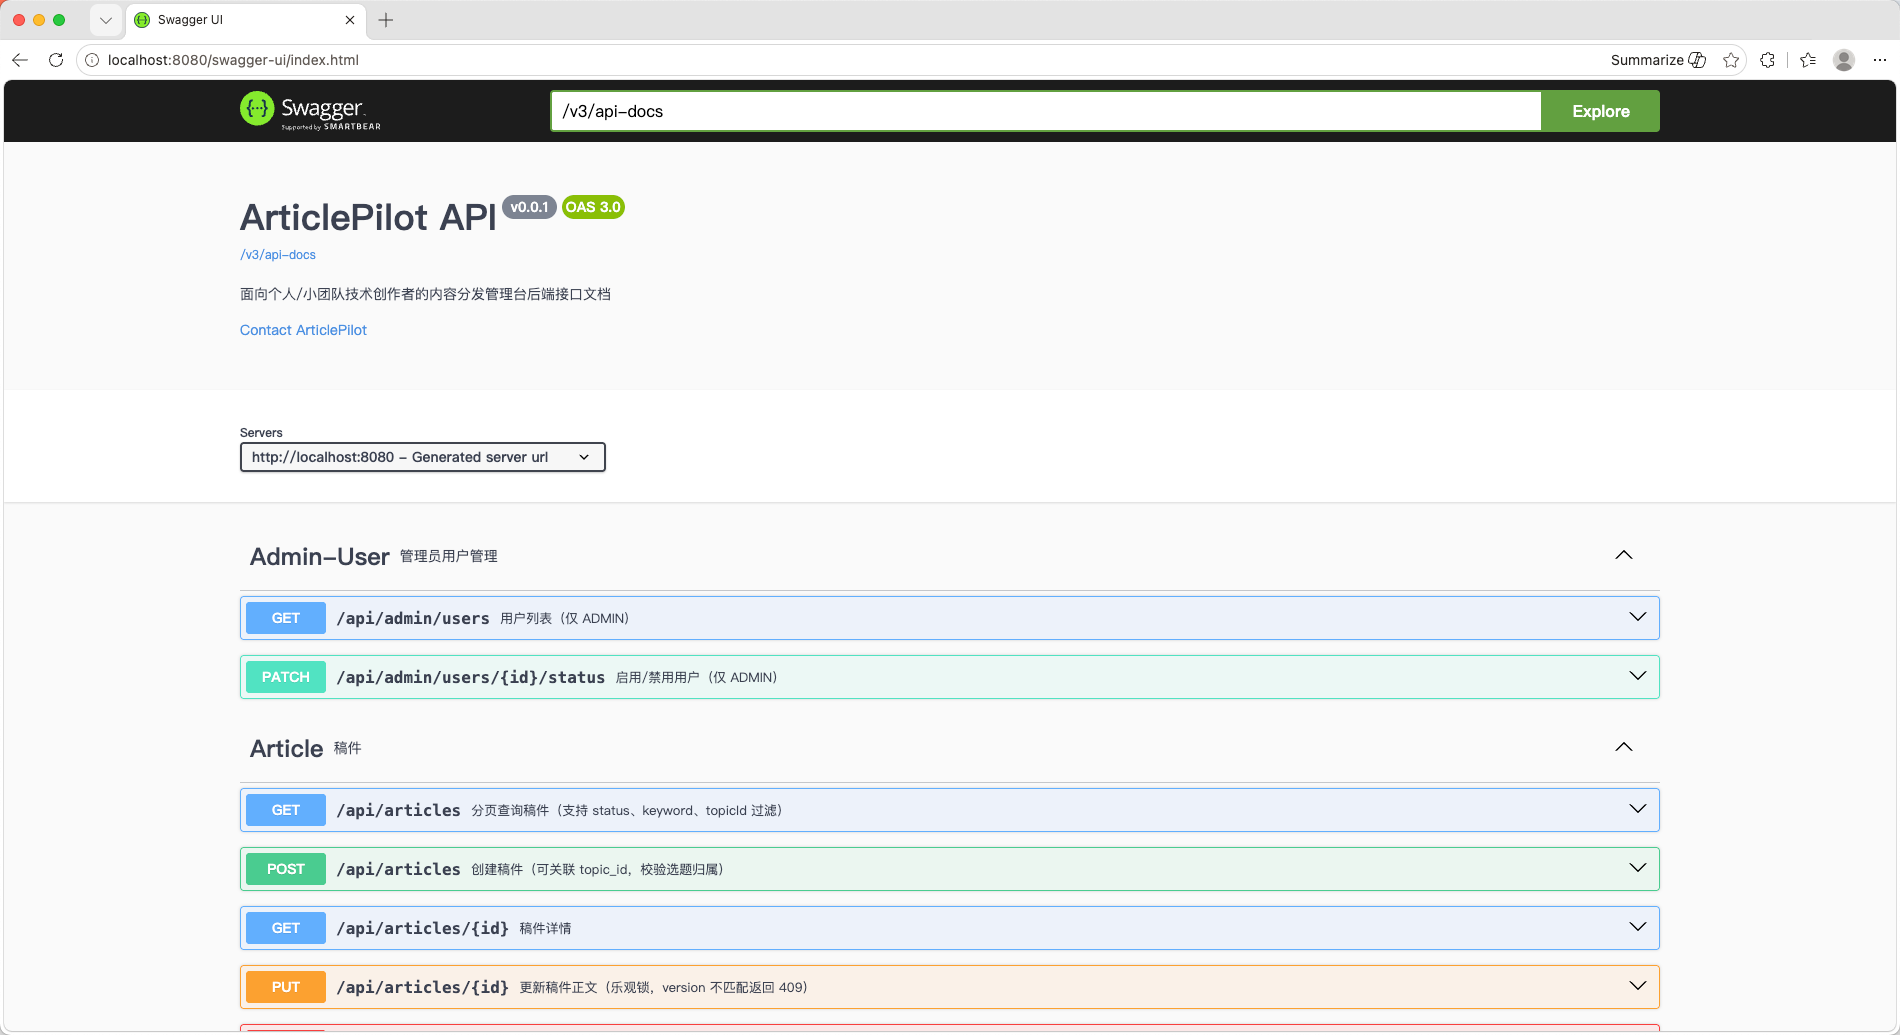
Swagger 首页(OAS 3.0):Admin-User / Article / Topic 等按 Controller 分组,接口支持在页面直接调试,稿件更新接口标注了乐观锁 409 语义
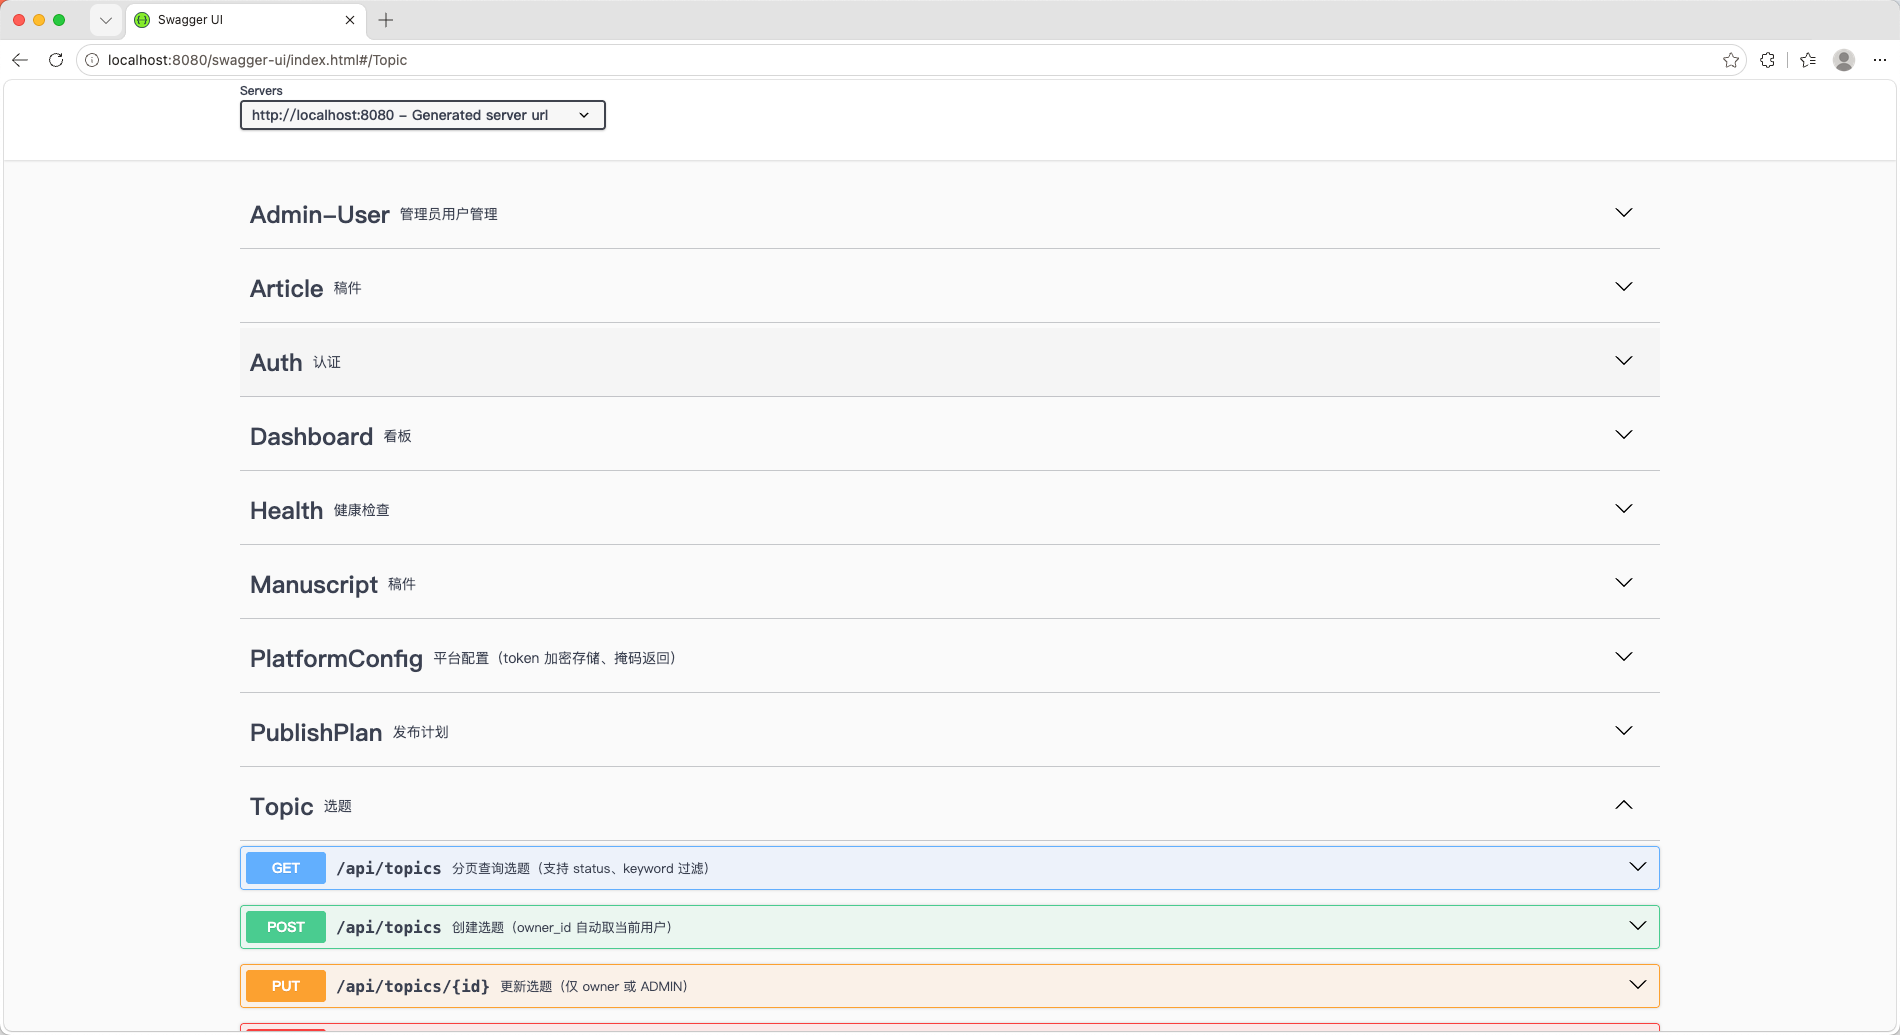
接口分组一览:Auth / Dashboard / Health / Manuscript / PlatformConfig(标注 token 加密存储、掩码返回)/ PublishPlan / Topic,统一返回体结构在每个接口的 Schema 中可见
五、踩坑记录:AI 写对了九成,剩下一成靠人
如实记录开发过程中真实遇到的问题。AI 智能体大幅提效是事实,但"生成的代码能编译通过"和"能正确运行"之间的缝隙,仍然需要人填。
5.1 JWT 过滤器链顺序不对,登录后所有请求 401
现象:登录接口正常返回 token,但带着 token 访问任何业务接口都是 401。
根因:AI 生成的 SecurityConfig 中,自定义 JwtAuthenticationFilter 注册的位置不对——被加在了默认过滤器链之后,请求到达它之前就已经被认证逻辑拒掉了。
修复:显式指定过滤器插入位置,把 JwtAuthenticationFilter 挂到 UsernamePasswordAuthenticationFilter 之前,重新验证三角色场景后恢复正常。这个问题 AI 两次修改才修对,第二次我按"先定位根因再动手"的纪律要求它先解释过滤器链的执行顺序,确认理解一致后一次修复。修复后的关键配置如下:
// src/main/java/com/articlepilot/config/SecurityConfig.java(节选)
@Bean
public SecurityFilterChain securityFilterChain(HttpSecurity http) throws Exception {
    http
            .csrf(csrf -> csrf.disable())
            .sessionManagement(sm -> sm.sessionCreationPolicy(SessionCreationPolicy.STATELESS))
            .authorizeHttpRequests(auth -> auth
                    .requestMatchers(PUBLIC_PATHS).permitAll()
                    .anyRequest().authenticated()
            )
            .exceptionHandling(eh -> eh
                    .authenticationEntryPoint((request, response, authException) ->
                            writeJson(response, 401, "未认证或令牌已失效"))
                    .accessDeniedHandler((request, response, accessDeniedException) ->
                            writeJson(response, 403, "无权访问该接口"))
            )
            // 坑一的修复点:自定义过滤器必须挂在用户名密码过滤器之前,
            // 否则请求先被默认认证逻辑拒掉,永远到不了 JWT 解析
            .addFilterBefore(new JwtAuthenticationFilter(jwtTokenProvider),
                    UsernamePasswordAuthenticationFilter.class)
            .formLogin(form -> form.disable())
            .httpBasic(basic -> basic.disable());
    return http.build();
}
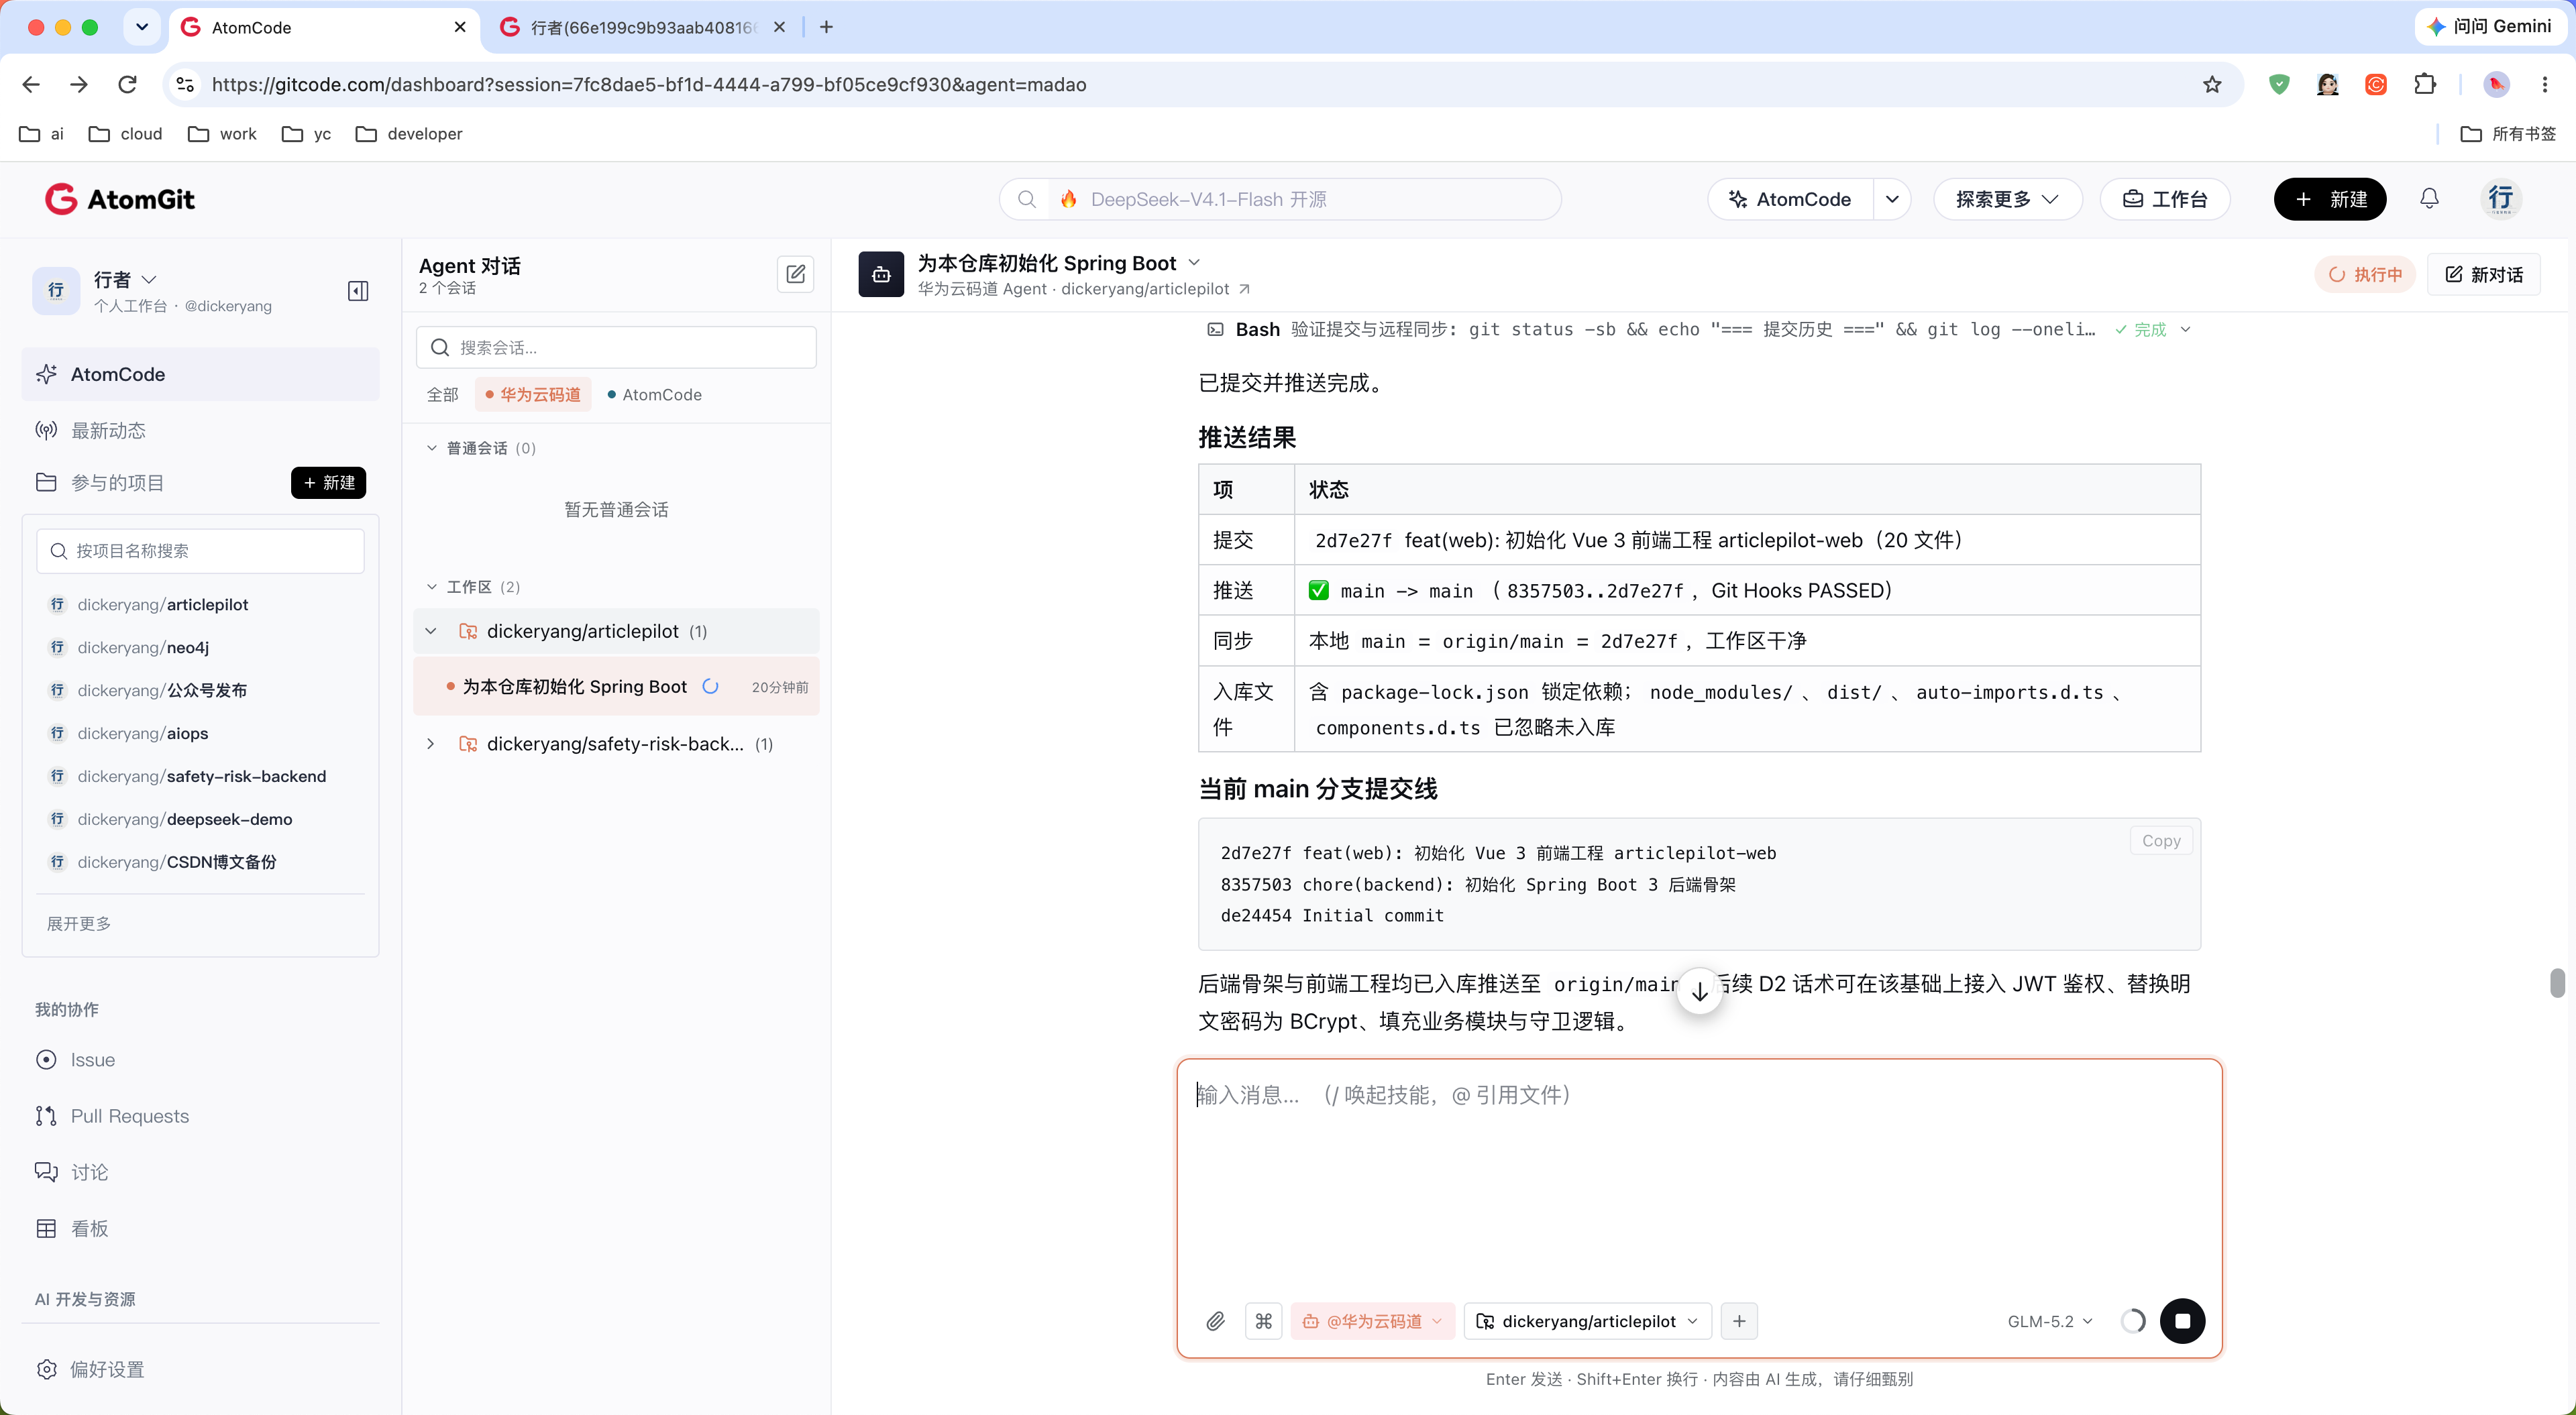
坑一现场:401 问题在 Agent 会话中往返定位,Agent 先解释过滤器链执行顺序再动手修复
5.2 数据库增量 SQL 没生效,新接口集体报表不存在
现象:D3 之后新增的选题、稿件接口全部报"Table doesn’t exist",但 SQL 文明明明提交了。
根因:MySQL 容器挂载的初始化脚本只在 volume 首次创建时执行,后续追加的 migration 文件对已经在运行的库不会自动生效。
修复:两个动作——对运行中的库手动应用增量 SQL;同时把所有建表语句加固为幂等写法(CREATE TABLE IF NOT EXISTS),并验证 docker compose down -v 全新重建后所有表自动创建。这个坑的教训是:容器化项目里,“文件在仓库里"不等于"在数据库里”。
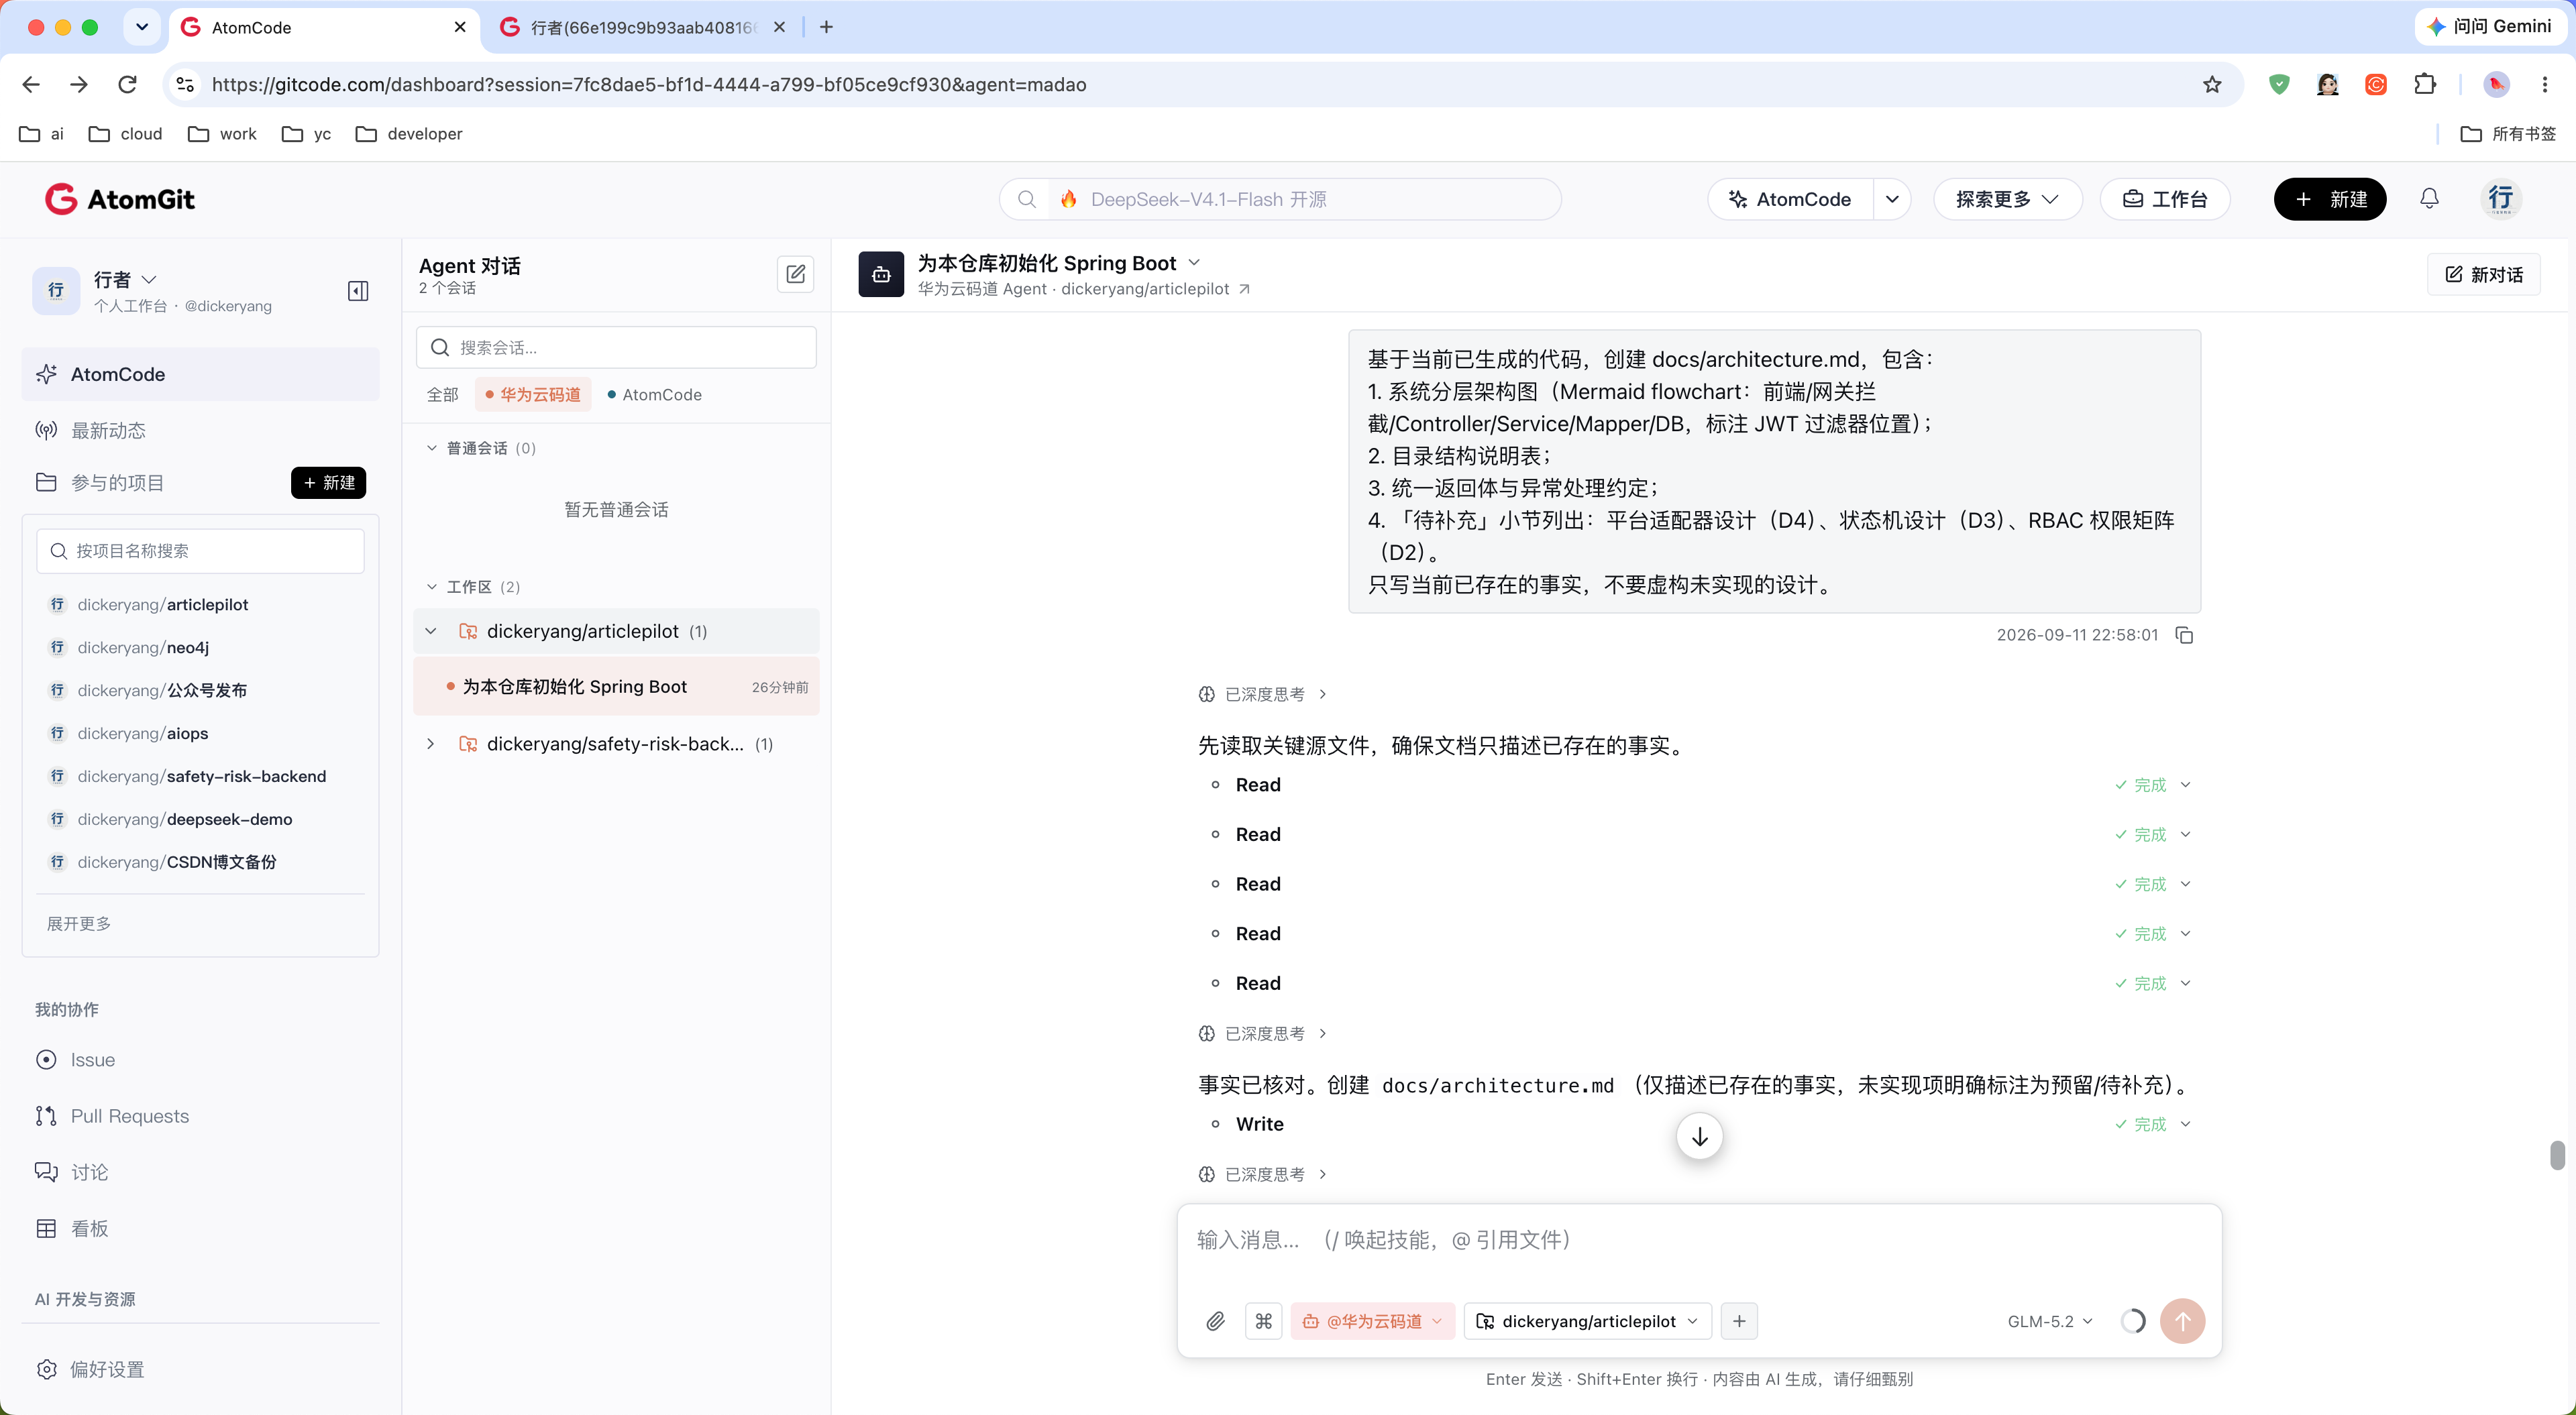
坑二现场:“Table doesn’t exist” 的根因分析与幂等加固方案都在会话中留痕
5.3 AI 默认实现的 token 返回,把加密后的密文原样吐给了前端
现象:安全自查时发现,平台配置接口返回的 token 字段虽然是密文,但密文本身完整返回了——加密等于白做。
根因:话术里写了"AES 加密落库",但没写死"接口返回掩码",AI 按它自己的默认理解实现了。
修复:补充掩码规则(仅展示末 4 位),并在 DTO 层切断 entity 直出。这次踩坑让我把投喂话术的纪律升级了一条:安全要求必须写成可验收的明确规则,不能只给方向。
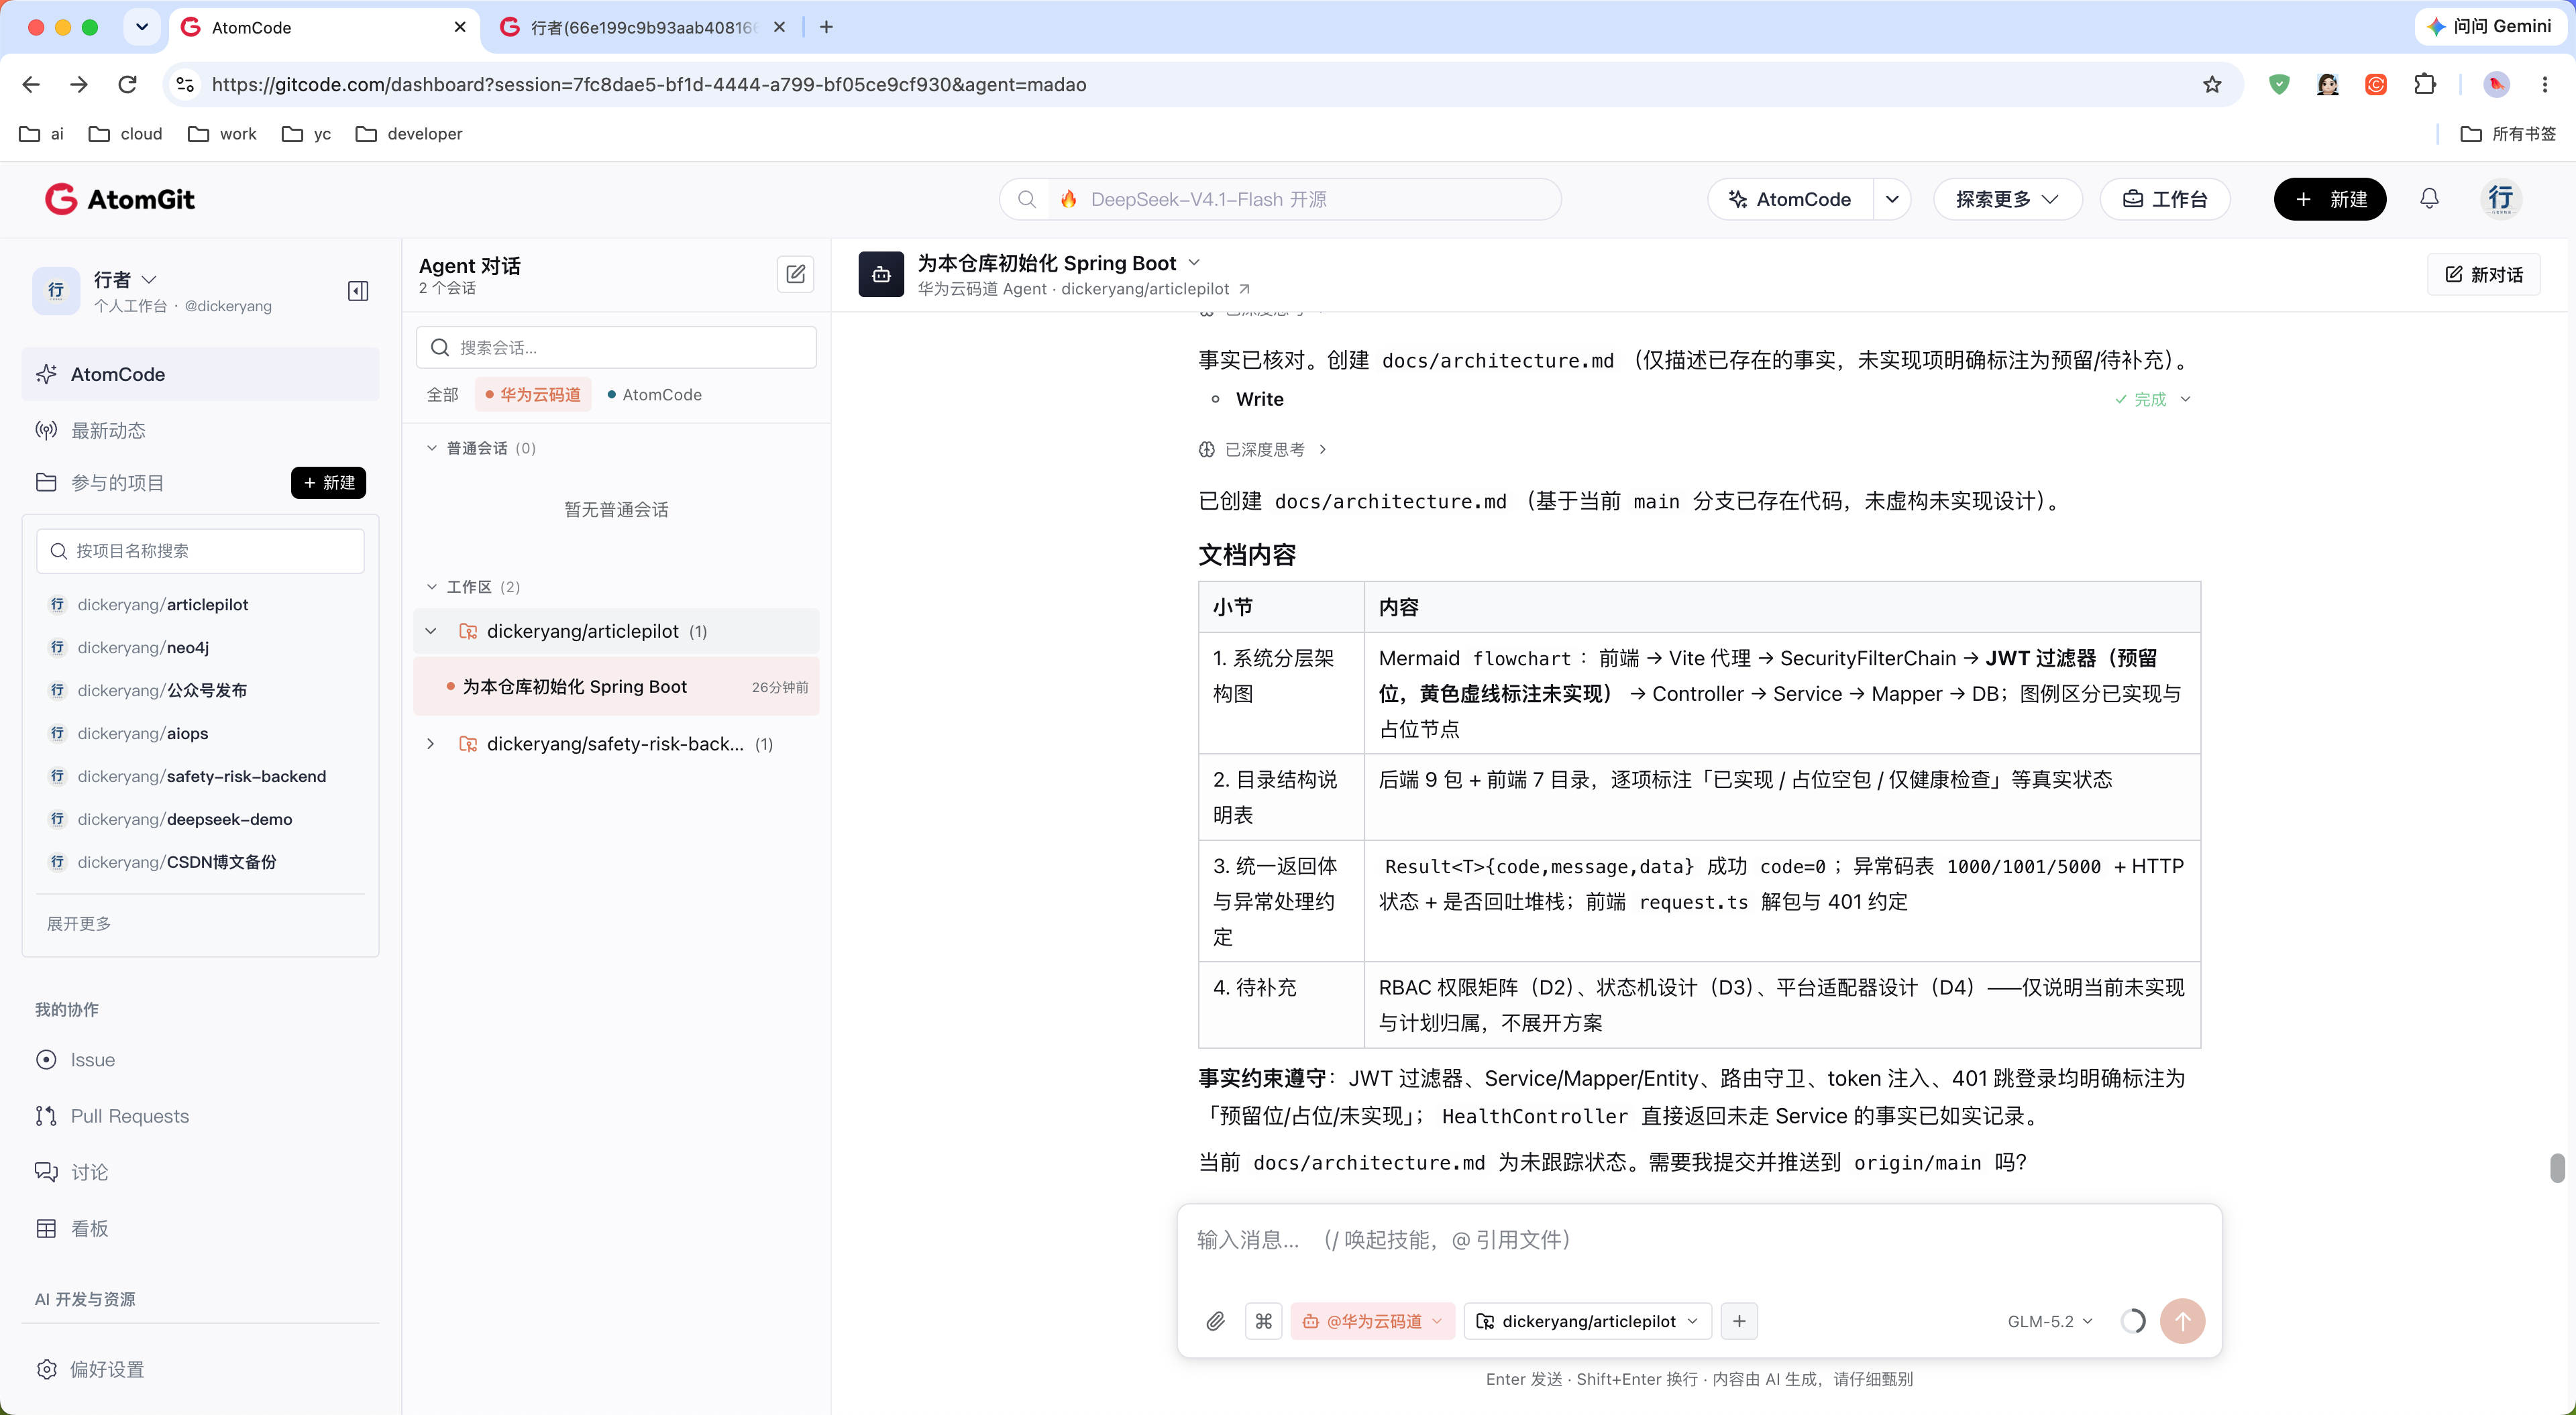
坑三现场:安全自查发现密文直出后在会话中补充掩码规则并切断 entity 直出
5.4 小结
三个坑的共同点是:AI 的失误都发生在"话术没约束到的地方",没有一个坑是因为 AI 写不好"话术约束到的代码"。这印证了我的使用策略——架构决策、安全规则、验收标准由人写死,AI 在约束内高效执行,这个分工下的协作质量最高。
补一句质量收口的实测数据(mvn verify 本地实测,JaCoCo 0.8.12):
- 后端单元测试 9 个测试类、123 个用例,全部通过、0 失败;
- 核心业务包行覆盖率:状态机(
service.article/service.topic)100%,平台适配注册表(adapter)88%; - 全项目整体行覆盖率约 14%——这个数字不高,如实说明原因:Controller、DTO、Entity 层未纳入单测范围(Controller 靠
docs/smoke-test.md的全链路冒烟兜底),单测火力集中在业务逻辑与安全组件上。
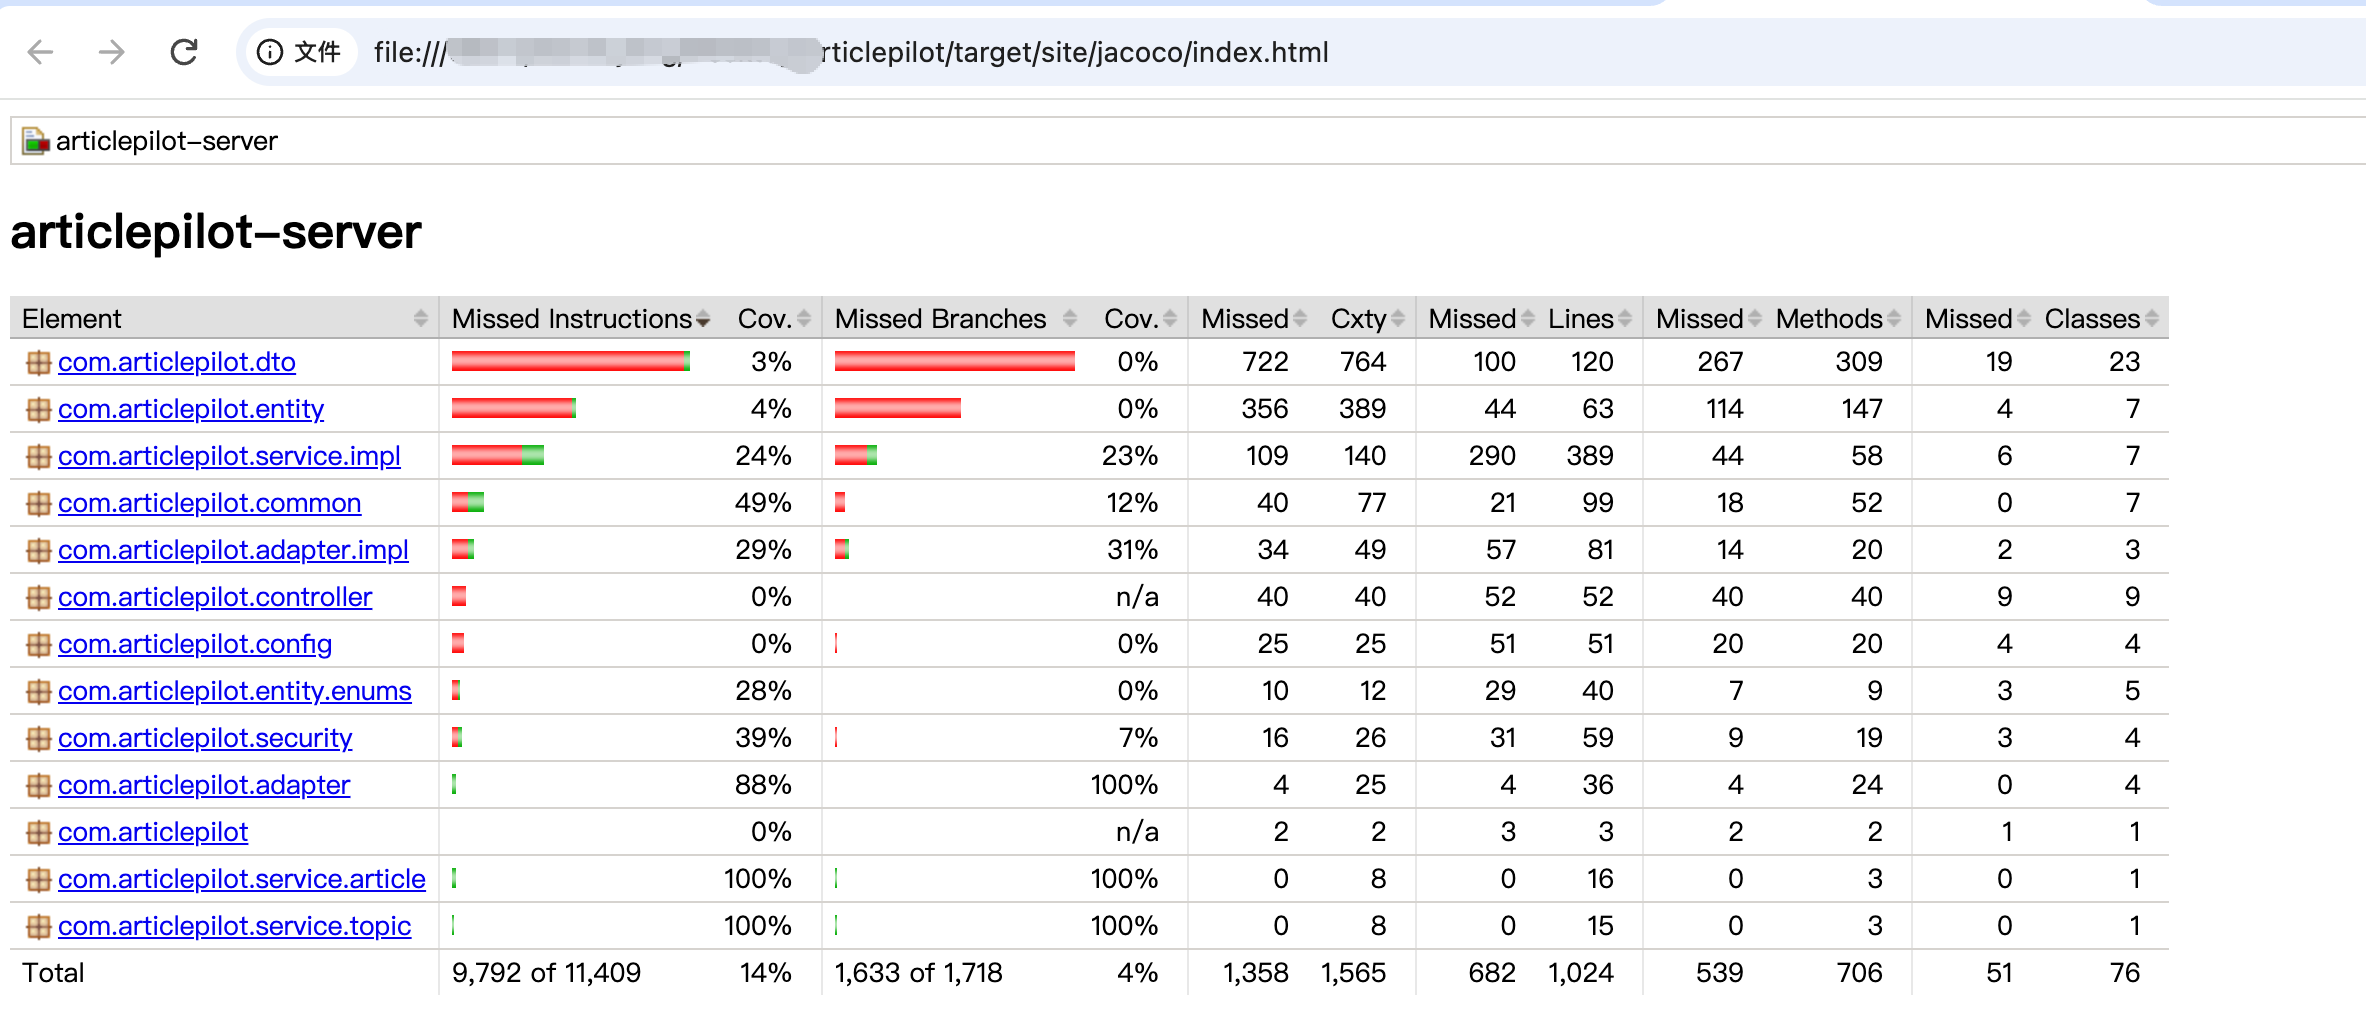
mvn verify 生成的 JaCoCo 报告(target/site/jacoco):service.article / service.topic 状态机包 100%,adapter 88%,common 49%,Total 14%——与上文数字一致,未覆盖部分主要是 Controller/DTO/Entity 层
六、提效数据:AI 辅助开发到底快了多少
如实给出本次开发的提效记录(基于开发日志的实际耗时统计,为个人单项目样本,仅供参考,不构成普适结论)。
| 开发阶段 | 纯手写预估 | AI 辅助实际 | 提效来源 |
|---|---|---|---|
| 前后端项目骨架 + Docker 部署 | 约 2 天 | 约 2.5 小时 | 脚手架/配置类工作收益最大 |
| JWT 认证 + RBAC | 约 1.5 天 | 约 3 小时 | 模板化安全代码,人负责验收 |
| 选题/稿件模块 + 状态机 | 约 2.5 天 | 约 5 小时 | CRUD 由 AI 生成,状态机测试人工把关 |
| 平台适配器体系 | 约 1 天 | 约 2.5 小时 | 设计已定,实现即翻译 |
| 质量收口(安全自查/补测试/README) | 约 1 天 | 约 4 小时 | 自查清单执行快,修复靠人 |
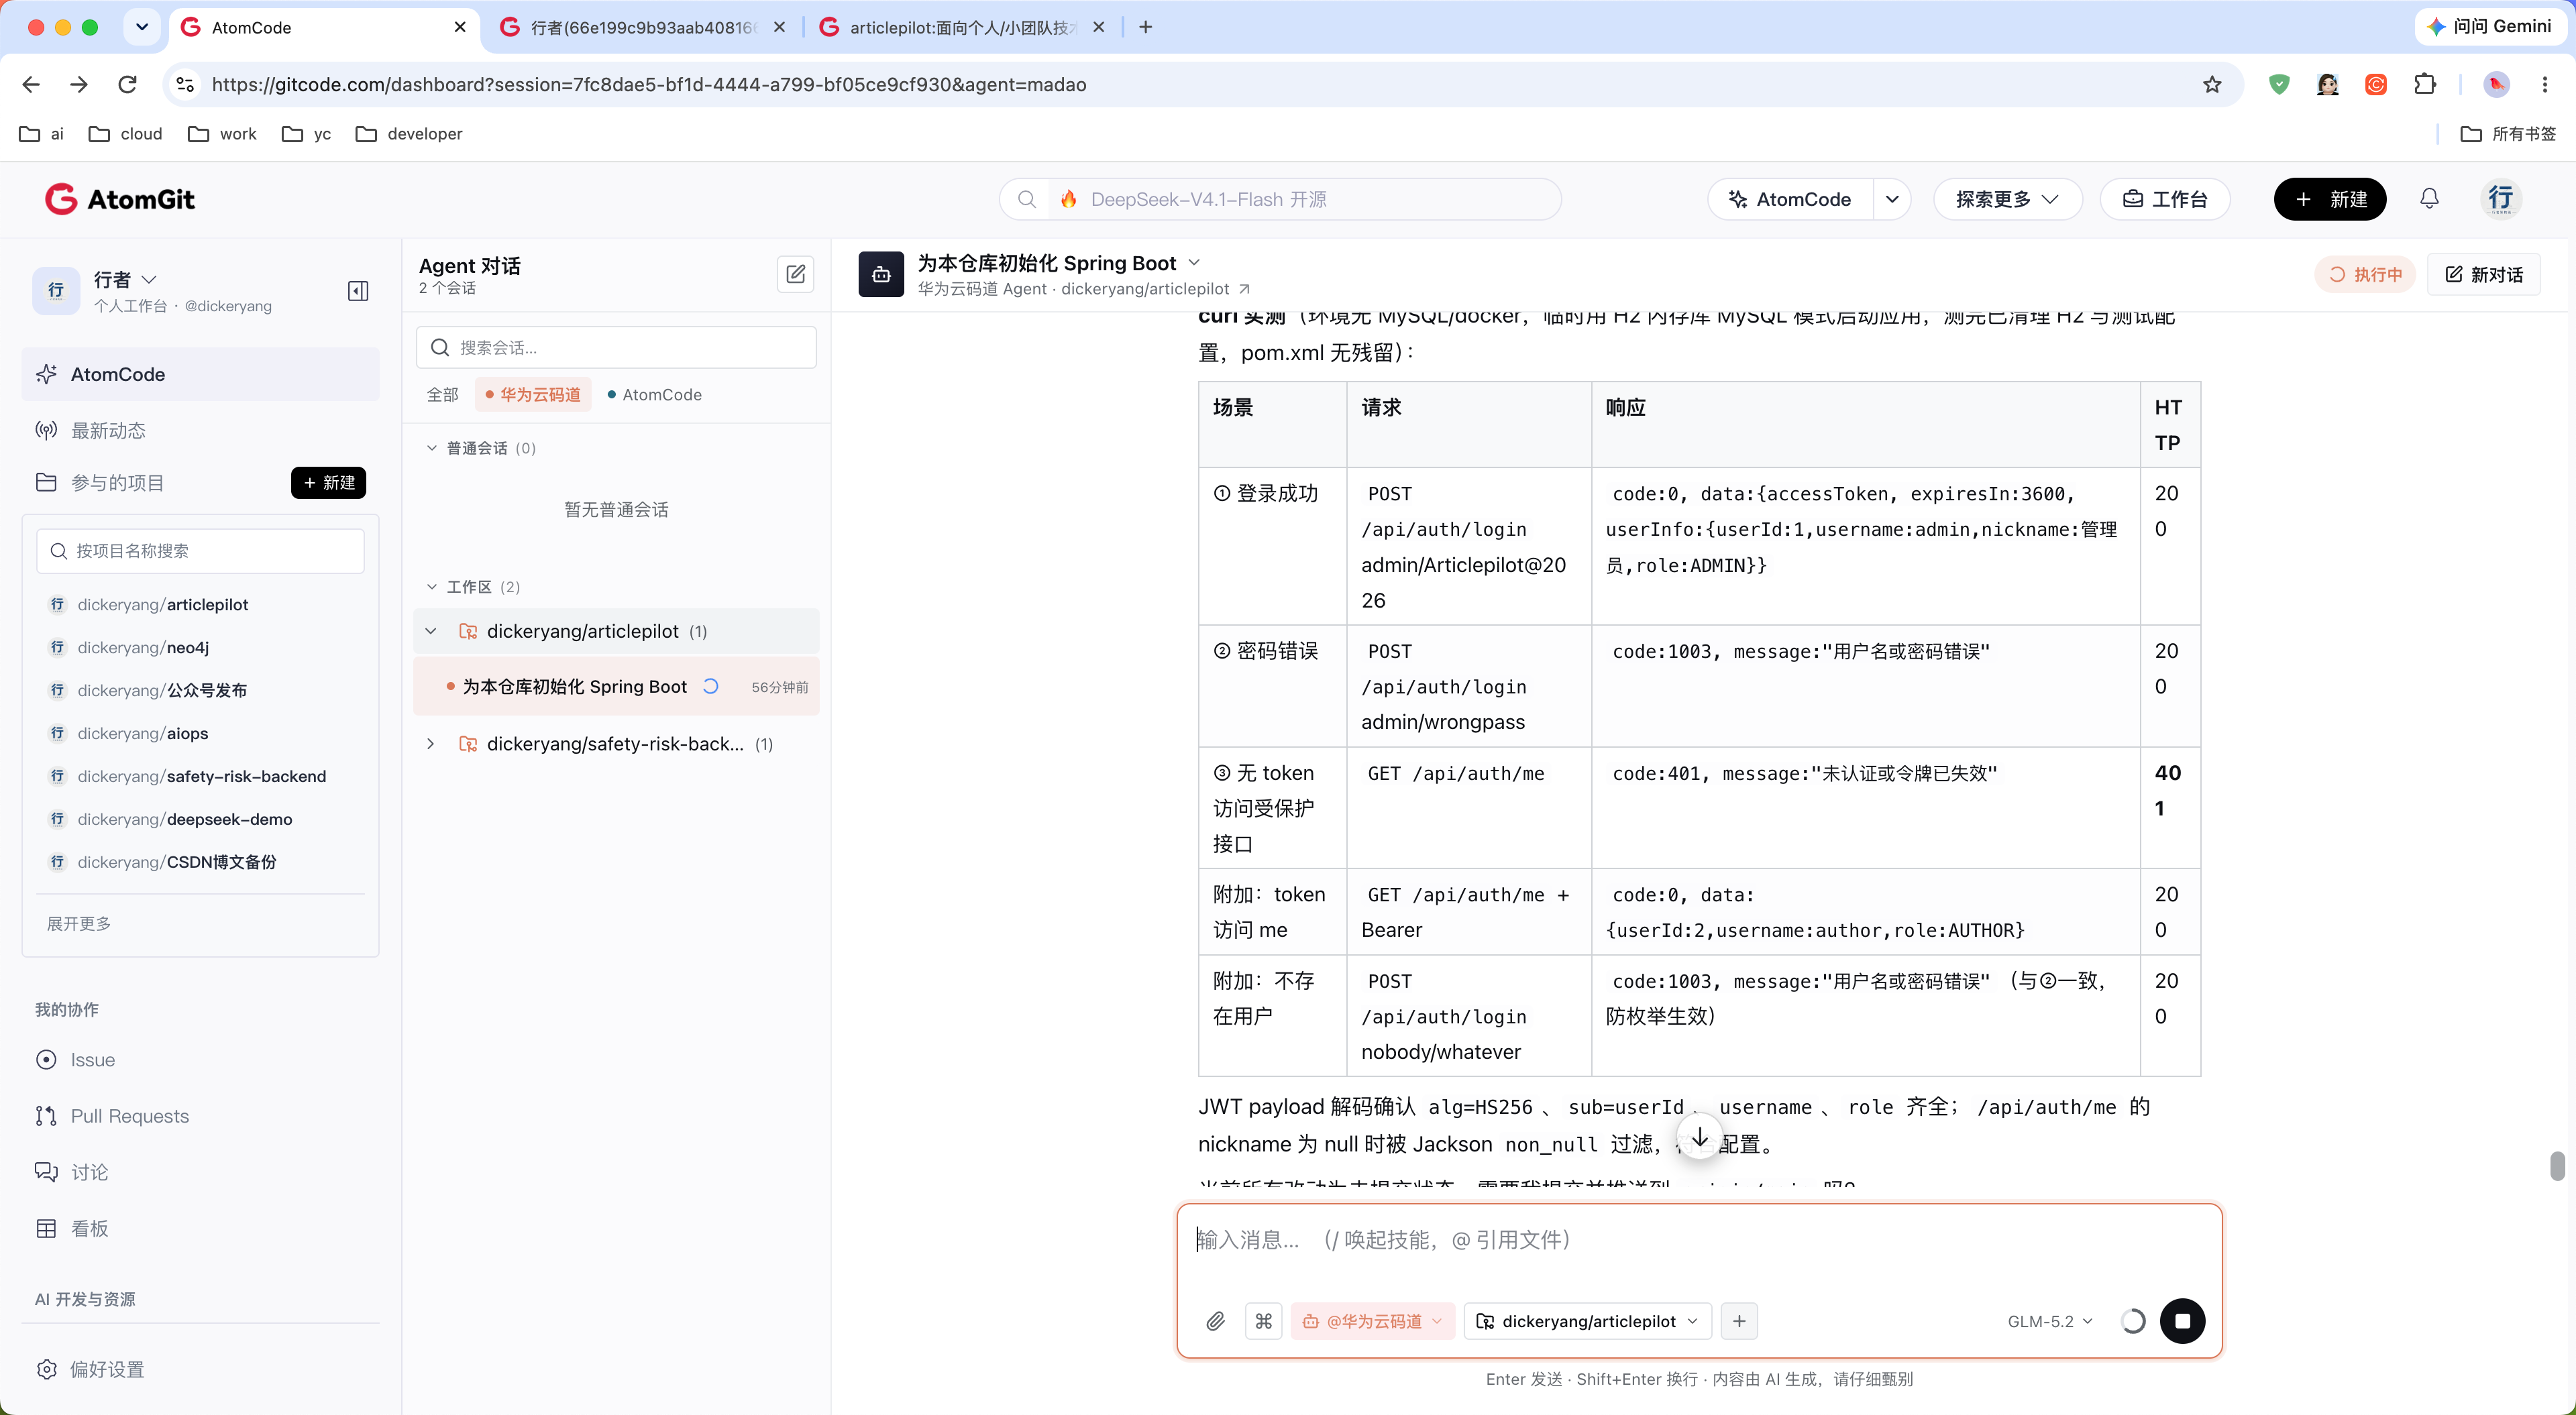
AtomGit 个人工作台:articlepilot 与其他在维项目并列,Agent 会话记录即开发日志的原始凭证
两点如实说明:一是上表"纯手写预估"基于我以往同类项目的经验估算,存在主观误差;二是提效并非免费的——验收环节(curl 实测、点页面、看测试报告)的耗时包含在内,这部分是 AI 替代不了的人工成本。综合感受:整体工期压缩到传统方式的四分之一左右,且代码质量的下限反而更稳(约束写死的情况下)。
七、开源地址与运行方式
项目已开源,包含可运行源代码、README(作品介绍)与开源协议:
本地运行只需三步(依赖 Docker):
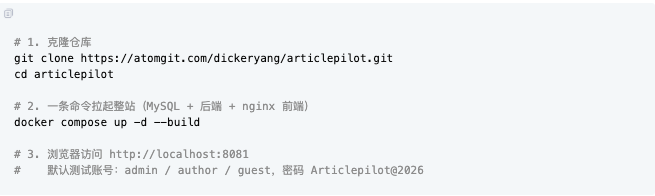
仓库内附 docs/architecture.md(架构设计文档)、docs/testing.md(测试清单与覆盖率)、docs/smoke-test.md(全链路冒烟记录),按 README 从零环境一次跑通是投稿前的验收门槛。项目采用 Apache-2.0 协议开源,欢迎参考与反馈。
八、总结与平台使用建议
8.1 结论
回到开头的问题:AI 智能体能不能独立完成一个全栈应用?这次实测的答案是——在"人定架构与验收、AI 做实现"的分工下,可以,且提效显著。
三个核心设计(适配器模式、集中状态机、安全红线前置)全部由人预先决策,AI 在这套约束内完成了约九成的代码量。评审关注的架构清晰度、测试覆盖、安全合规,恰恰是靠"投喂前的人肉准备"保住的,而不是靠 AI 自觉。
8.2 给平台的建议
一周深度使用下来,对 CodeArts 代码智能体的几点优化建议(如实反馈,供官方参考):
- 多文件改动的事务感:一次话术涉及十几个文件时,中途失败会留下半成品状态,希望提供"本轮改动整体回滚"的操作;
- 安全默认值:建议对密钥硬编码、SQL 拼接这类问题在生成时就主动告警,而不是依赖开发者话术约束;
- 长会话上下文:跨天开发时,前一天的架构约束需要重新投喂,若能持久化项目级约定会省不少重复工作。
8.3 写在最后
这次参赛对我而言最大的收获不是这个管理台本身,而是验证了一套可复制的 AI 协作工作流:架构决策人做、约束写进话术、每块验收兜底。
这套方法已经整理成完整的执行手册,后续我会在专栏中展开。如果你也在参加本期华为云码道 AI 编程挑战赛,欢迎在评论区交流投喂话术的写法与踩坑经验。
觉得有用就点个赞,有疑问或不同看法欢迎评论区交流。

- 点赞
- 收藏
- 关注作者
评论(0)