发动机故障诊断智能体(五):高不平衡场景下的样本逆频加权奖励机制与探索优化

在民用航空发动机的实际运维场景中,气路系统的正常运行样本通常占据绝大部分,而诸如排气温度不平衡、放气阀异常及传感器故障等实际故障样本极为稀缺,构成了典型的极度不平衡分类问题。若在强化学习框架中直接采用常规的均等奖励反馈机制,智能体极易通过无差别输出多数类动作来规避惩罚并获取高额累计回报,从而引发严重的诊断偏置。论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》针对这一问题设计了基于样本数量逆频加权的动态奖励分配法则与自适应探索策略,致力于从强化学习的反馈信号源头纠正类别不平衡带来的梯度倾斜。
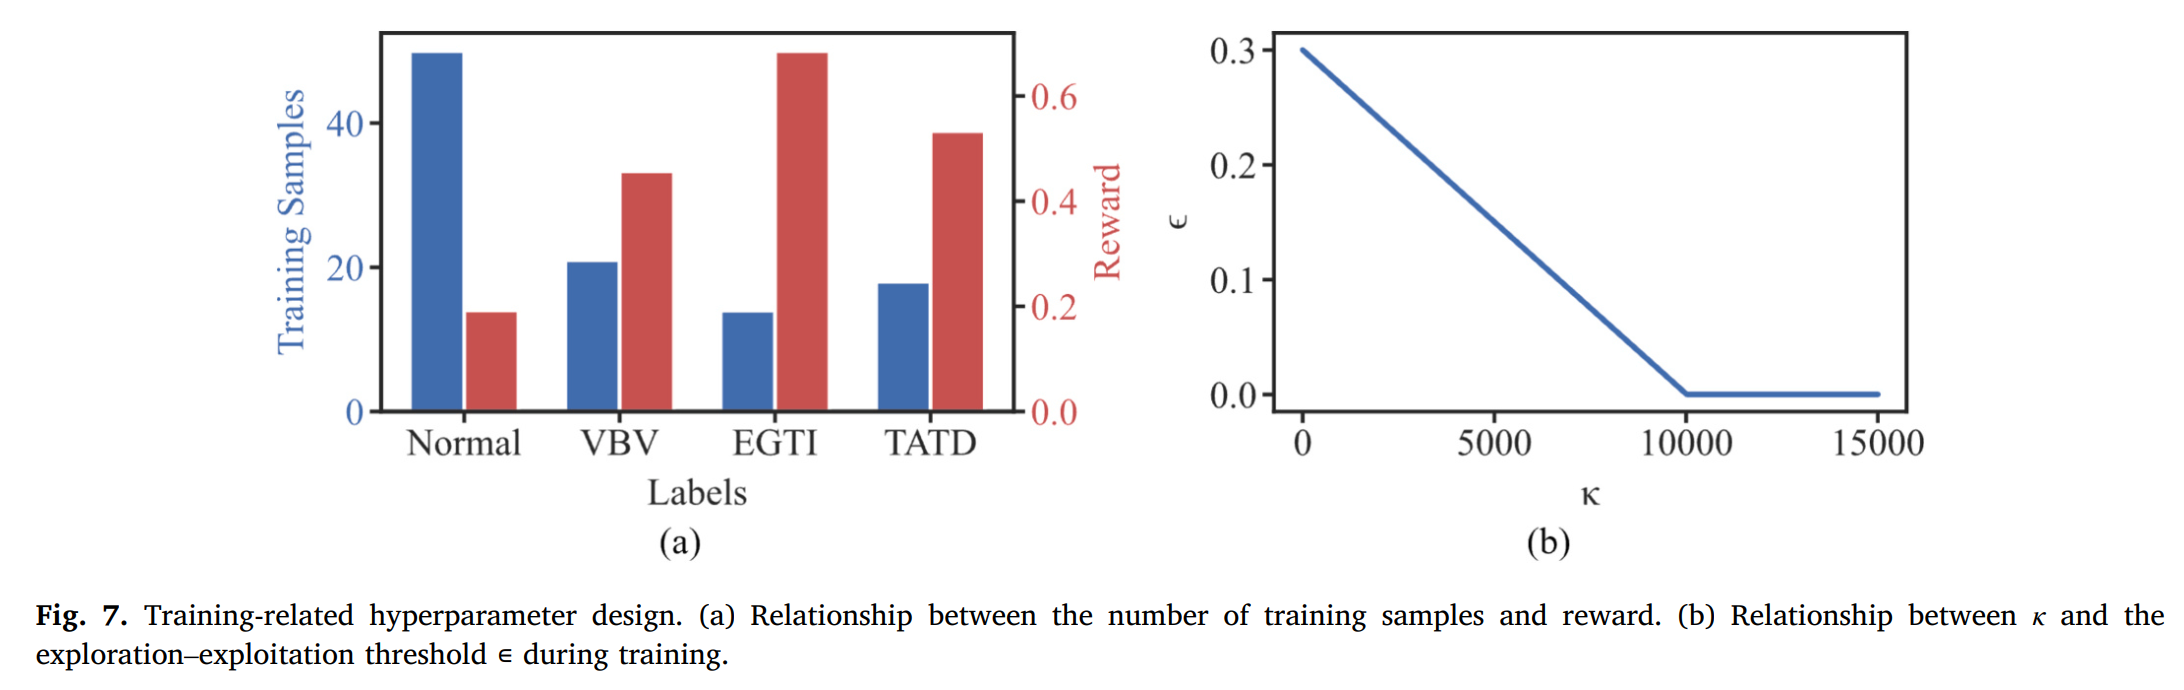
动态奖励机制的基础在于根据各类别在训练集中的出现频率实施反比例加权设计。对于样本数量极为稀少的故障类型,模型为其赋予较高的初始基础权重;而对于样本规模庞大的正常状态类别,则分配较低的基础权重。这种将类别权重与对应样本量倒数直接挂钩的设计逻辑,使得智能体在每次决策时所面临的价值反馈不仅取决于动作的对错,更直接受制于该类别在整体物理分布中的稀缺程度,从机制上提升了算法对罕见故障模式的感知敏感度。
为了防止样本数量极端悬殊引发数值计算不稳定或梯度爆炸,算法对各类别权重实施了平方和归一化处理,据此确定各故障类型的绝对奖励幅值。在环境与智能体的实际交互中,奖励信号采取对称正负反馈的形式输出:当智能体正确识别出某类故障时,环境赋予该类别对应的正向归一化奖励值;反之,若发生误判或漏判,环境则施加同等幅度的负向惩罚。这一规则使得正确识别稀有故障能够产生显著的正向价值驱动,而漏报稀有故障亦会引发巨大的负向损失,从而促使决策网络在梯度更新中优先拟合少数类别的判定边界。
在策略学习过程中,为了避免智能体在初始阶段过早收敛至多数类主导的局部次优策略,系统引入了动态线性退火的探索与利用平衡机制。在训练初期,智能体尚不具备精确评估各状态动作价值的能力,若完全依赖策略网络输出,极易累积历史偏置造成的误导信息。因此,算法在早期设置了较高的随机探索概率,强制智能体在给定的状态空间内以一定概率随机选择诊断动作,从而大幅增加接触并探索稀有故障样本决策空间的机会,保证经验池中样本分布的多样性。
随着训练步数的不断递增,系统通过预设的最大步数阈值对探索概率执行线性衰减退火。随着智能体对各状态动作价值的估计精度逐步提高,随机探索的概率平滑下降,网络逐渐由广泛的状态探索过渡为依据已学得策略进行确定性决策输出。在训练步数达到上限后,探索概率被锁定为一个极小的基准常数而非完全归零,这一微量探索冗余确保了网络在整体收敛后仍保留对潜在状态漂移的适应弹性,避免了模型参数的过早固化。
样本逆频加权奖励函数与动态退火探索策略在智能体内部形成了紧密的协同机制。非均等奖励重塑了贝尔曼时序差分误差的损失曲面,迫使深度Q网络在反向传播中主动调整分类超平面,在一定程度上克服了传统强化学习在小样本高不平衡环境下的学习惰性;而受控的探索衰减过程则保障了特征流形探索与策略利用的平稳过渡,从算法底层为高不平衡气路故障诊断提供了严密、稳定的数学收敛保障。
参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025, 65(C): 103297.

- 点赞
- 收藏
- 关注作者
评论(0)