发动机故障诊断智能体(四):基于决斗双重深度Q网络(D3QN)的诊断决策

在前序模块完成特征自监督压缩与对比空间分离后,系统需要一个具备离散分类裁决能力与环境交互特性的序贯决策引擎。论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》引入了基于决斗双重深度Q网络(D3QN)的类型识别模块作为诊断智能体的决策核心。该模块通过重构状态动作价值评估体系,将多维气路特征映射为具体的故障诊断动作,从决策机制层面克服传统强化学习在复杂多分类任务中常见的价值过估计与学习偏置难题。
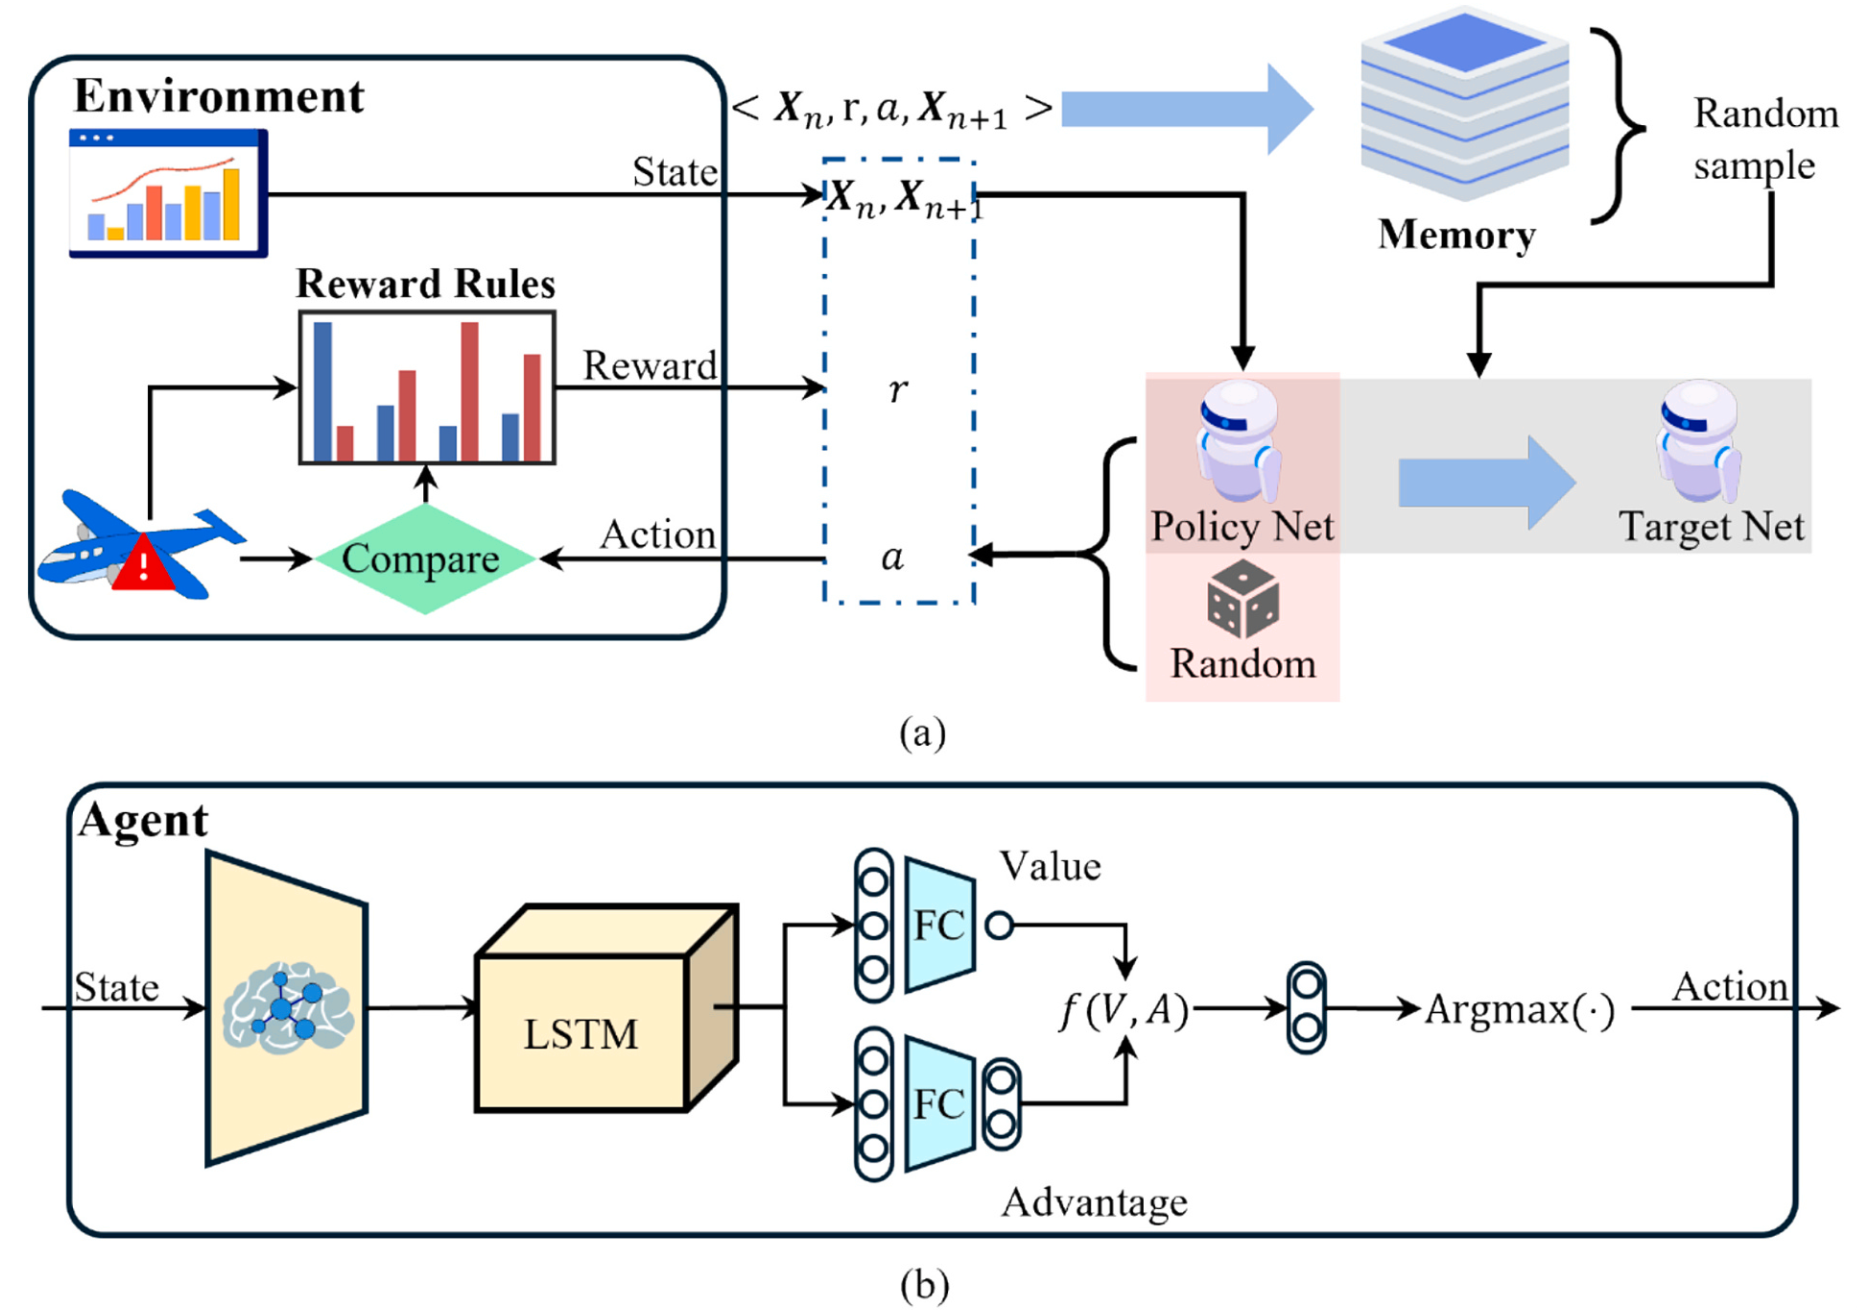
类型识别智能体的内部网络由主干时序层与双支路线性评估层串联构成。前序特征区分模块中经过微调的编码器在此阶段参数被完全冻结,直接作为前端特征提取器,输出的低维隐层特征被送入决策智能体的新建长短期记忆主网络中。主网络负责解析特征在时间维度上的高阶交互信息,并提取最终时间步的隐层向量作为状态的综合表征。然后,该综合表征被同步分发至两个独立的线性全连接分支,分别执行状态全局价值评估与各诊断动作相对优势的解耦计算。
决斗网络架构的核心机理在于状态价值流与动作优势流的结构解耦与聚合重构。其中,状态价值支路输出一个标量,用于客观评估发动机当前处于某种退化状态或健康工况的全局固有价值,而与智能体具体选择何种诊断动作无关;动作优势支路则输出一个维度与故障类别总数相同的向量,分别衡量在当前状态下选择特定故障判别动作相对于其他可选动作的相对优劣程度。在计算最终的动作价值时,网络通过将优势向量减去其内部均值后再与状态价值标量相加,这种中心化聚合机制不仅保证了状态价值与动作优势的数学可辨识性,而且有效避免了某一突发动作评估对整体状态判断的过度干扰。
为了彻底消除标准深度Q学习算法在动作价值更新过程中固有的最大化正向偏差,模型引入了双重Q网络协同更新机制。系统在内存中维护结构完全相同但参数更新频率异步的策略网络与目标网络。在计算状态转移的目标估计值时,策略网络仅负责根据当前状态输出具有最大Q值的候选诊断动作索引,而具体的动作评估价值则由参数相对固定的目标网络计算得出。这种“动作选择与价值评估相互解耦”的双网络协作模式,有效平抑了学习过程中的数值剧烈波动,保障了Q值估计在整个训练周期内的稳定性。
在强化学习的价值迭代过程中,智能体依赖贝尔曼方程与时序差分误差驱动策略网络的参数反向传播。环境反馈的即时奖励与目标网络计算出的未来状态折扣价值共同构成目标Q值,由于连续两次诊断样本之间的物理相关性较为微弱,模型将未来折扣系数设定为较低水平,促使网络更加聚焦于当前飞行序列与即时分类奖励的直接映射。策略网络通过最小化输出Q值与目标Q值之间的均方误差损失函数逐步收敛,持续优化各动作在不同气路状态下的精准评价值。
在完成网络优化后,智能体能够以确定性的方式执行在线故障推断。当新的多航段气路监测序列输入后,经过冻结的编码器和主干决策网络的前向推理,网络输出针对正常状态及各类典型气路故障模式的完整动作价值向量;系统通过提取向量中最大价值对应的索引位置,直接映射为最终的故障诊断类别输出。该架构将状态表征、优势度量与价值修正有机融合,构建起一个兼具抗过拟合能力与严密数学逻辑的发动机状态诊断决策引擎。
参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025, 65(C): 103297.

- 点赞
- 收藏
- 关注作者
评论(0)