聚搜云运维团队:A100 80G GPU服务器多少钱?哪些配置会影响实际费用
#A100 80G GPU服务器多少钱?哪些配置会影响实际费用
聚搜云[JuSouYunClouD -聚搜云(深圳)信息有限公司]可根据企业实际业务需求、模型规模、显存要求、GPU数量及部署场景,提供相关大厂GPU云服务器、GPU算力及企业级计算产品,覆盖:V100、T4、A10、A16、A30、A40、A100、A800、L4、L40、L40S、H100、H800、H200、H200 NVL、B100、B200、B300、GB200、GB300、RTX 6000 Ada、RTX PRO 6000 Blackwell Server Edition、MI100、MI210、MI250、MI250X、MI300A、MI300X、MI325X、MI350X、MI355X、MI430X、MI455X、Ascend 310、Ascend 310P、Ascend 910、Ascend 910B、Ascend 910C、Ascend 950PR、Ascend 950DT等产品。具体可用型号、配置、市场价格及供货情况,以当期实际资源为准。
说明:部分GPU及相关服务器产品可能受到适用法律法规、出口管制、原厂政策及最终用户/最终用途要求影响,实际供应与交付以交易时的合规条件及资源情况为准。
A100 80G GPU服务器没有统一价格。按照2026年9月4日可查询到的公开样本折算,单张A100 80GB云算力大约为8.1—34.4元/小时,连续运行730小时约为5900—25100元/月;8卡企业级云实例则有约8.76万元/月的公开参考。买断整机还要计算CPU、内存、NVMe存储、网络、机房、维保和软件部署,不能只看GPU单卡价格。
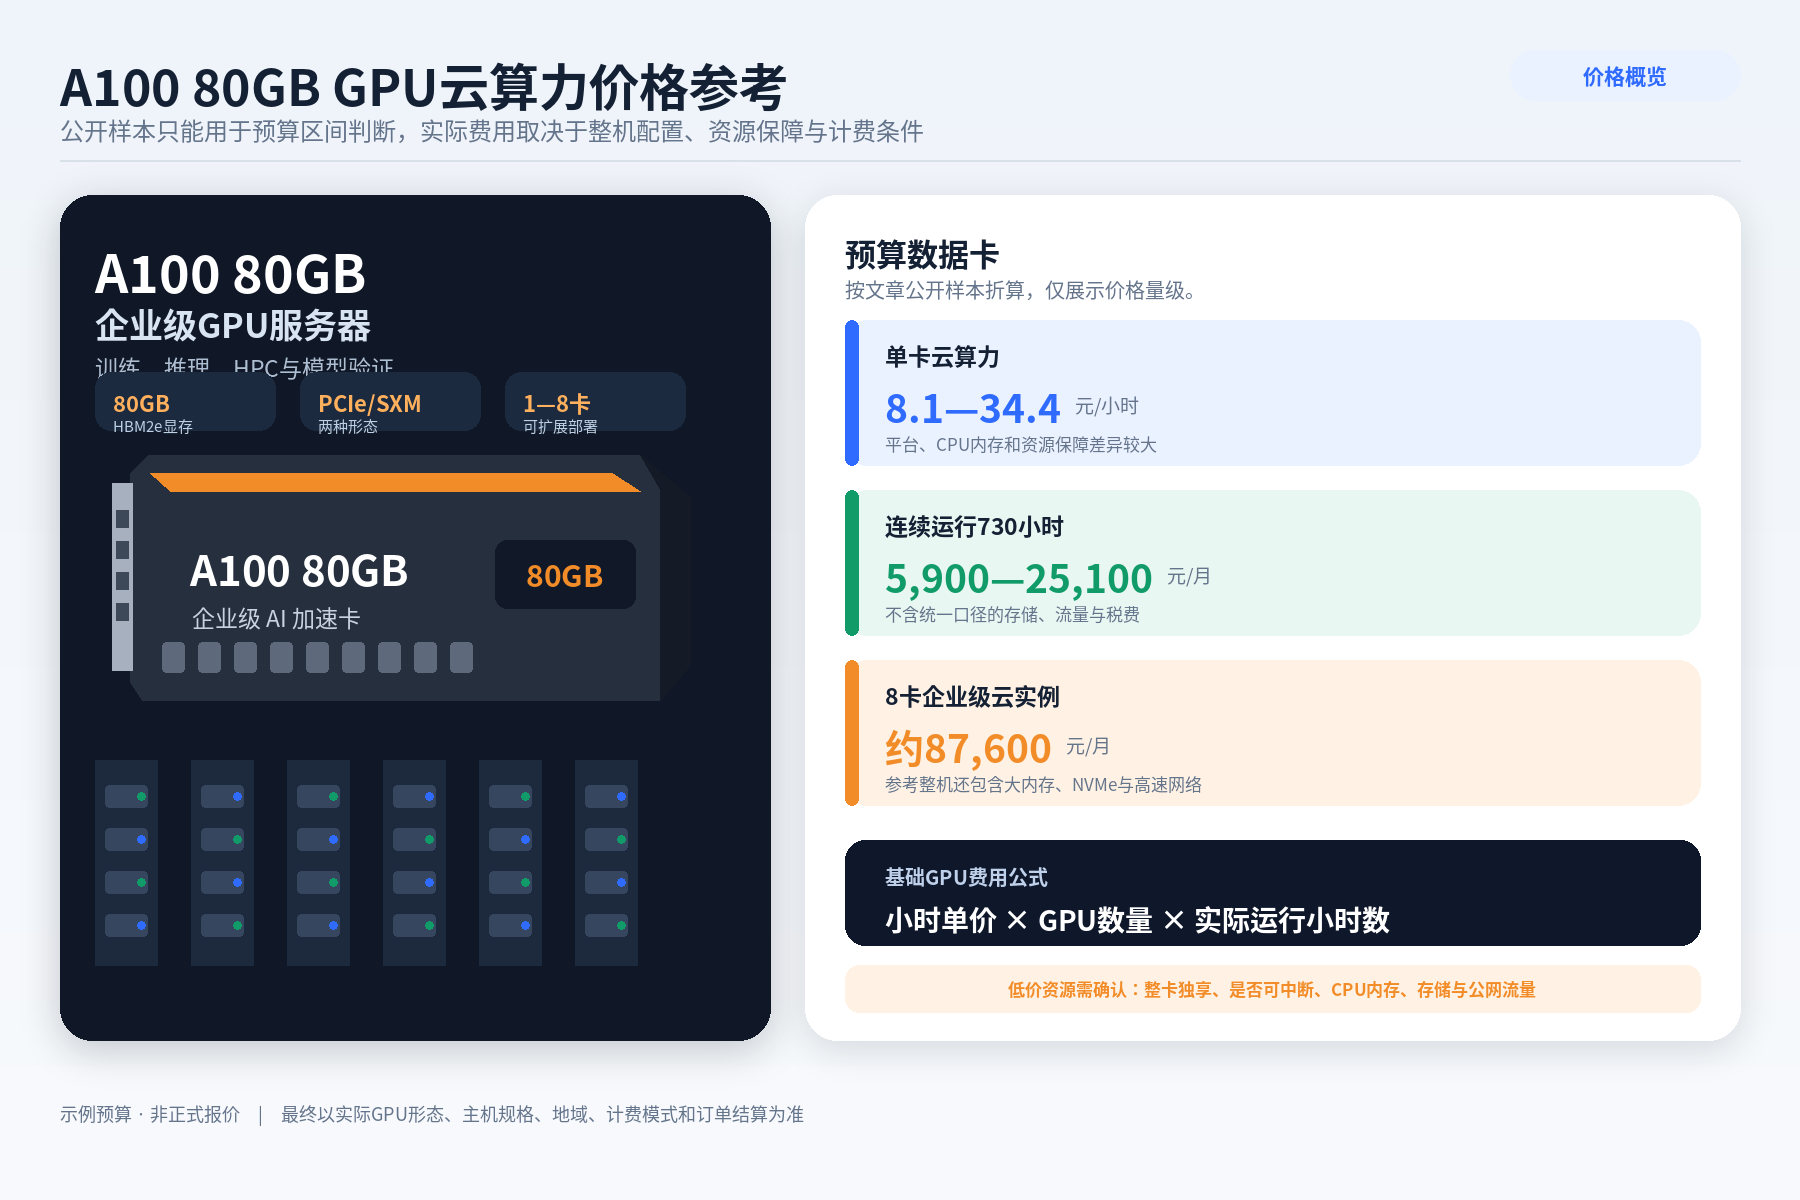
需要先说明的是,标题中的“A100 80G”通常指配备80GB HBM2e显存的NVIDIA A100,并不是服务器只有80GB系统内存。不同供应方式包含的主机资源、服务等级和计费条件差异很大,下面的价格只能作为采购预算参考,最终仍应以实际配置和订单报价为准。
一、A100 80G GPU服务器大概多少钱
(一)按小时租用GPU云服务器多少钱
企业短期进行模型测试、微调、推理验证或阶段性训练时,通常更适合按小时租用。公开报价显示,不同GPU云平台之间的价格跨度较大,而且并非完全相同的产品。
| 公开价格样本 | A10080GB配置与计费方式 | 人民币预算参考 |
|---|---|---|
| 专业GPU云 | A100 PCIe公开起步价约1.19美元/小时,安全云和SXM资源约1.39—1.49美元/小时 | 约8.1—10.1元/小时,连续730小时约5900—7400元/月 |
| AWS容量块 | p4de.24xlarge包含8张A100 80GB,整机17.712美元/小时,折合每张2.214美元/小时 | 整机约120元/小时,连续730小时约8.76万元/月 |
| Google Cloud A2 Ultra | a2-ultragpu-1g包含1张A100 80GB、12个vCPU、170GB内存及本地SSD,公开价格项约5.0688美元/小时 | 约34.4元/小时,连续730小时约2.51万元/月 |
| 专业GPU云的A100公开起步价、AWS容量块价格以及Google Cloud A2 Ultra价格不能直接视为同规格报价,因为它们在CPU、内存、存储、资源独享程度、网络、服务等级、购买承诺和可用地域方面并不相同。 | ||
| 上表按照2026年9月4日人民币汇率中间价粗略折算,当日1美元约合6.7787元人民币。汇率只用于统一预算口径,境外云平台的实际结算还可能受到支付汇率、税费和账单币种影响。 |
(二)购买A100 80GB单卡和整机多少钱
买断A100 80GB时,需要区分“只购买GPU卡”和“购买完整GPU服务器”。第三方市场统计在2026年3月给出的A100 80GB新卡参考区间约为7000—15000美元,二手卡约为4000—9000美元。按照上述汇率粗略折算,新卡约4.7万—10.2万元,二手卡约2.7万—6.1万元,但这并不是NVIDIA官方统一指导价。
另一个公开零售样本中,一张新的A100 80GB PCIe卡标价为8214欧元未税、9939欧元含税,按照2026年9月4日欧元中间价折算,分别约为6.4万元和7.8万元。该价格属于境外零售样本,不能直接等同于国内含服务器、运输、维保和部署的交付价。
完整整机还需要增加服务器主板、双路CPU、ECC内存、NVMe硬盘、网卡、冗余电源、散热系统、机箱以及维保服务。假设仅按上述新卡价格区间计算,4张GPU本体已经约为19万—41万元,8张GPU本体约为38万—81万元,尚未包括HGX平台、主机硬件、网络和实施成本。因此,多卡A100整机进入数十万元预算并不意外,高配8卡平台还可能进一步进入百万元级预算。
(三)为什么网上有些A100价格特别低
低价A100资源不一定存在问题,但必须确认它究竟是什么产品。常见情况包括竞价实例、可中断资源、共享GPU、MIG切分实例、二手卡、拆机卡、较低SLA资源,或者只展示GPU价格而没有计算CPU、内存、硬盘和流量费用。
看到“A100 80GB每小时几元”时,至少要核对四个问题:是否独享整张GPU、是否允许随时中断、是否包含CPU和内存、是否另外收取存储和公网流量费用。只有产品边界一致,价格才有比较价值。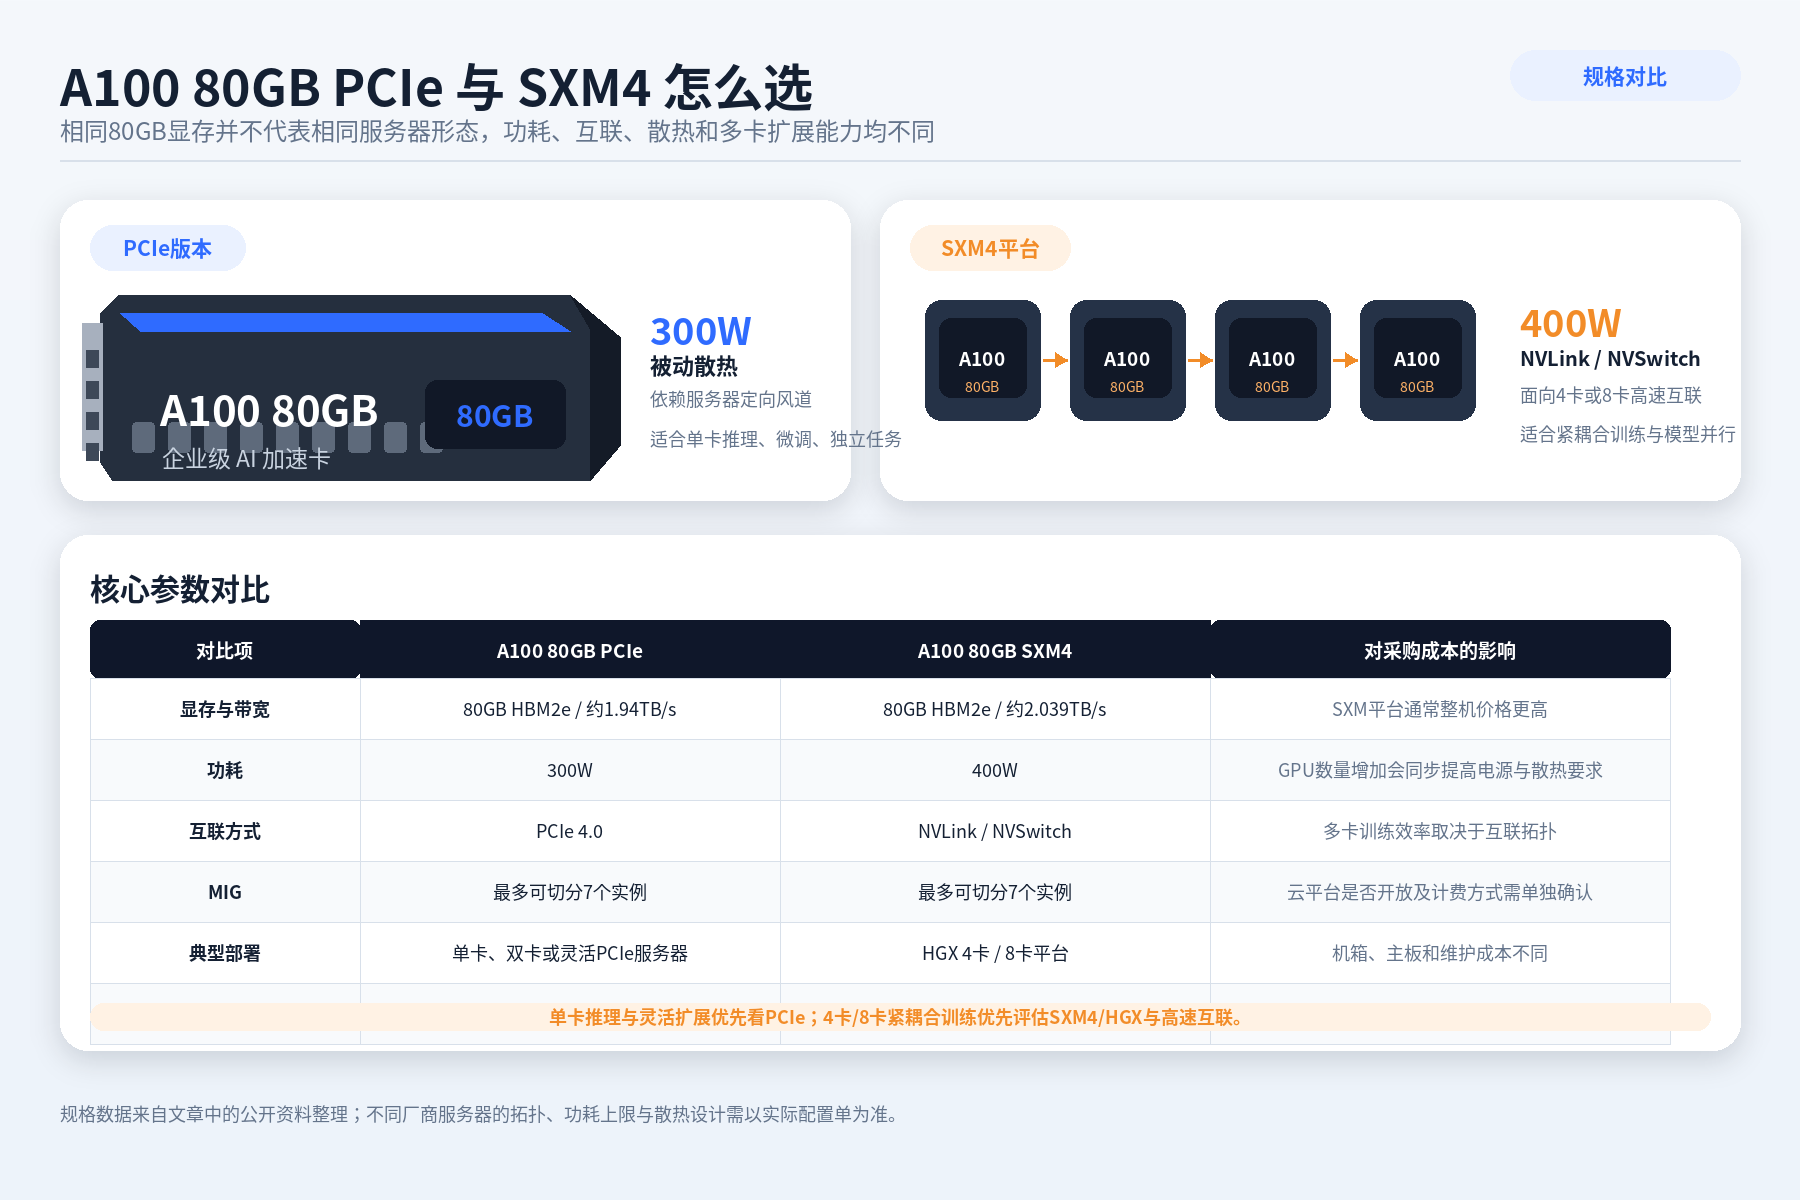
二、哪些配置会影响A100 80G服务器实际费用
(一)PCIe与SXM4不是同一种整机方案
A100 80GB PCIe版本是一张双槽、被动散热的PCIe 4.0服务器卡,默认板卡功耗为300W,显存带宽最高约1.94TB/s,并支持最多7个MIG实例。被动散热意味着它依赖服务器机箱提供足够的定向风道,不能简单按照普通桌面显卡的方式安装。
A100 80GB SXM版本通常部署在HGX平台中,功耗可达到400W,显存带宽约2.039TB/s,并可借助NVLink和NVSwitch构建4卡或8卡高速互联。与PCIe多卡服务器相比,SXM/HGX平台的采购成本、散热要求和整机功耗通常更高,但在模型并行、张量并行和多卡通信频繁的训练任务中更有价值。
如果业务只需要单卡推理、模型微调或独立任务队列,PCIe方案通常更容易控制预算。如果需要4卡、8卡进行紧耦合训练,则不能只比较每张GPU的理论算力,还要检查GPU之间是否具备适合的高速互联拓扑。
(二)GPU数量增加后,费用并不是简单按卡数相乘
1卡、2卡、4卡和8卡服务器不仅GPU数量不同,配套主机也会变化。GPU越多,通常需要更多PCIe通道、更高功率电源、更强散热、更大系统内存以及更复杂的GPU互联。
以AWS p4de.24xlarge为例,8张A100 80GB之外还配有96个vCPU、1152GiB系统内存、8块1TB NVMe SSD、400Gbps实例网络和600GB/s NVSwitch互联。这说明8卡报价中包含的不只是8张GPU,还包含一整套面向分布式训练的主机和网络平台。
企业采购多卡服务器时,还应确认GPU是否位于合理的NUMA和PCIe拓扑下。即使都是8张A100,如果一台服务器采用完整NVSwitch互联,另一台只是多个PCIe设备组合,实际训练效率和跨卡通信表现也可能明显不同。
(三)CPU和系统内存会影响GPU能否跑满
GPU负责矩阵计算,但数据解压、图片预处理、分词、特征工程、数据加载和部分推理调度仍然依赖CPU。CPU核心过少或单核性能不足时,A100可能长时间等待数据,最终出现GPU价格很高、利用率却不高的情况。
系统内存也不能只按照模型文件大小选择。训练任务往往需要缓存数据集、维护数据加载队列和执行CPU侧处理;大模型推理还可能使用CPU内存进行权重卸载。公开云实例中,单张A100 80GB对应的主机配置就存在明显差异,例如Google A2 Ultra单卡实例配有12个vCPU和170GB内存,Azure单卡A100实例则配有24个vCPU和220GB内存,这说明CPU、内存不存在适用于所有项目的固定比例。
(四)显存需求决定一张卡是否够用
模型能否部署不能只看参数量,还要同时考虑权重精度、KV Cache、上下文长度、并发请求、框架开销和显存碎片。
以70B参数模型为例,仅计算4bit量化权重,理论上大约需要35GB显存;但实际运行还需要KV Cache、CUDA上下文、临时计算缓冲区和推理框架空间。上下文越长、并发越高,额外显存占用越大,因此“70B量化模型能放进80GB”并不等于“一张A100一定能满足生产并发”。
训练所需显存通常远高于推理,因为除了模型权重,还要保存梯度、优化器状态和激活值。企业应先通过实际模型进行显存测试,再决定使用单卡、张量并行、流水线并行、ZeRO、CPU Offload还是多机训练,不能只按模型文件大小购买GPU。
(五)存储性能和容量也会进入最终账单
GPU云服务器通常还会产生系统盘、数据盘、对象存储、快照和备份费用。数据集较大时,如果每次开机都从远端重新下载,不仅增加公网或跨区域流量,也会浪费宝贵的GPU计费时间。
训练场景尤其要关注检查点写入。模型越大,保存一次Checkpoint需要写入的数据越多;如果存储吞吐不足,GPU会在保存过程中等待。对于高频训练,通常需要区分本地NVMe高速缓存、共享文件系统和低成本对象存储,而不是把全部数据都放在同一种硬盘中。
(六)网络规格决定多节点扩展效率
单卡推理对网络要求相对简单,多节点分布式训练则完全不同。节点之间需要频繁进行梯度同步和集合通信,普通公网带宽不能替代低延迟、高吞吐的集群网络。
如果准备从8张GPU扩展到16张、32张甚至更多GPU,应确认是否具备适合NCCL通信的高速网络,以及是否支持RDMA或GPUDirect RDMA。AWS的A100 P4实例提供400Gbps网络、EFA和GPUDirect RDMA,就是为了降低跨节点通信对训练效率的影响。
企业不需要盲目购买最高网络配置。只有模型并行或数据并行跨越多台服务器时,高速集群网络才会成为关键成本;单机单卡或单机多卡推理,更应先关注显存、CPU、存储和公网业务流量。
(七)计费模式和服务等级会拉开价格差距
同一张A100 80GB,按量、包月、长期锁定、竞价和可中断实例的价格可能明显不同。低价竞价资源适合可以随时保存进度、失败后能够重新调度的任务,不适合没有Checkpoint机制的长时间训练,也不适合必须持续在线的生产推理服务。
此外,还要确认报价是否包含独享物理GPU、固定公网IP、数据盘、驱动环境、CUDA工具链、容器环境、监控告警、安全隔离、故障迁移和技术支持。企业级资源价格较高,往往不是因为GPU型号发生变化,而是增加了稳定性、资源保障和运维交付。
三、不同业务场景怎么估算A100费用
(一)短期测试和模型验证
如果企业每月只使用200小时,可以按照以下公式计算基础GPU费用:
月度GPU费用=单卡小时价格×GPU数量×实际运行小时数
按照前面的公开样本,单张A100 80GB运行200小时,基础计算费用约为1600—6900元。这个区间还没有统一加入数据盘、镜像、流量、快照和托管服务费用,但已经可以帮助企业判断项目验证阶段是否有必要直接购买整机。
对于使用时间不稳定、模型方案尚未确定的项目,先租用不同规格完成基准测试,通常比一开始就采购多卡服务器更容易控制试错成本。
(二)全年持续运行的推理服务
如果一张A100每天24小时运行,按照730小时/月计算,公开样本对应的月度费用约为5900—25100元,年度线性折算约为7.1万—30.1万元。
这个跨度说明,长期推理不能只比较每小时单价,还要比较请求吞吐量、GPU利用率和单位Token成本。若单张A100大部分时间利用率很低,可以考虑批处理、动态批量、多个模型共卡或MIG切分;A100支持最多7个隔离的MIG实例,但具体云平台是否开放MIG以及如何计费,需要单独确认。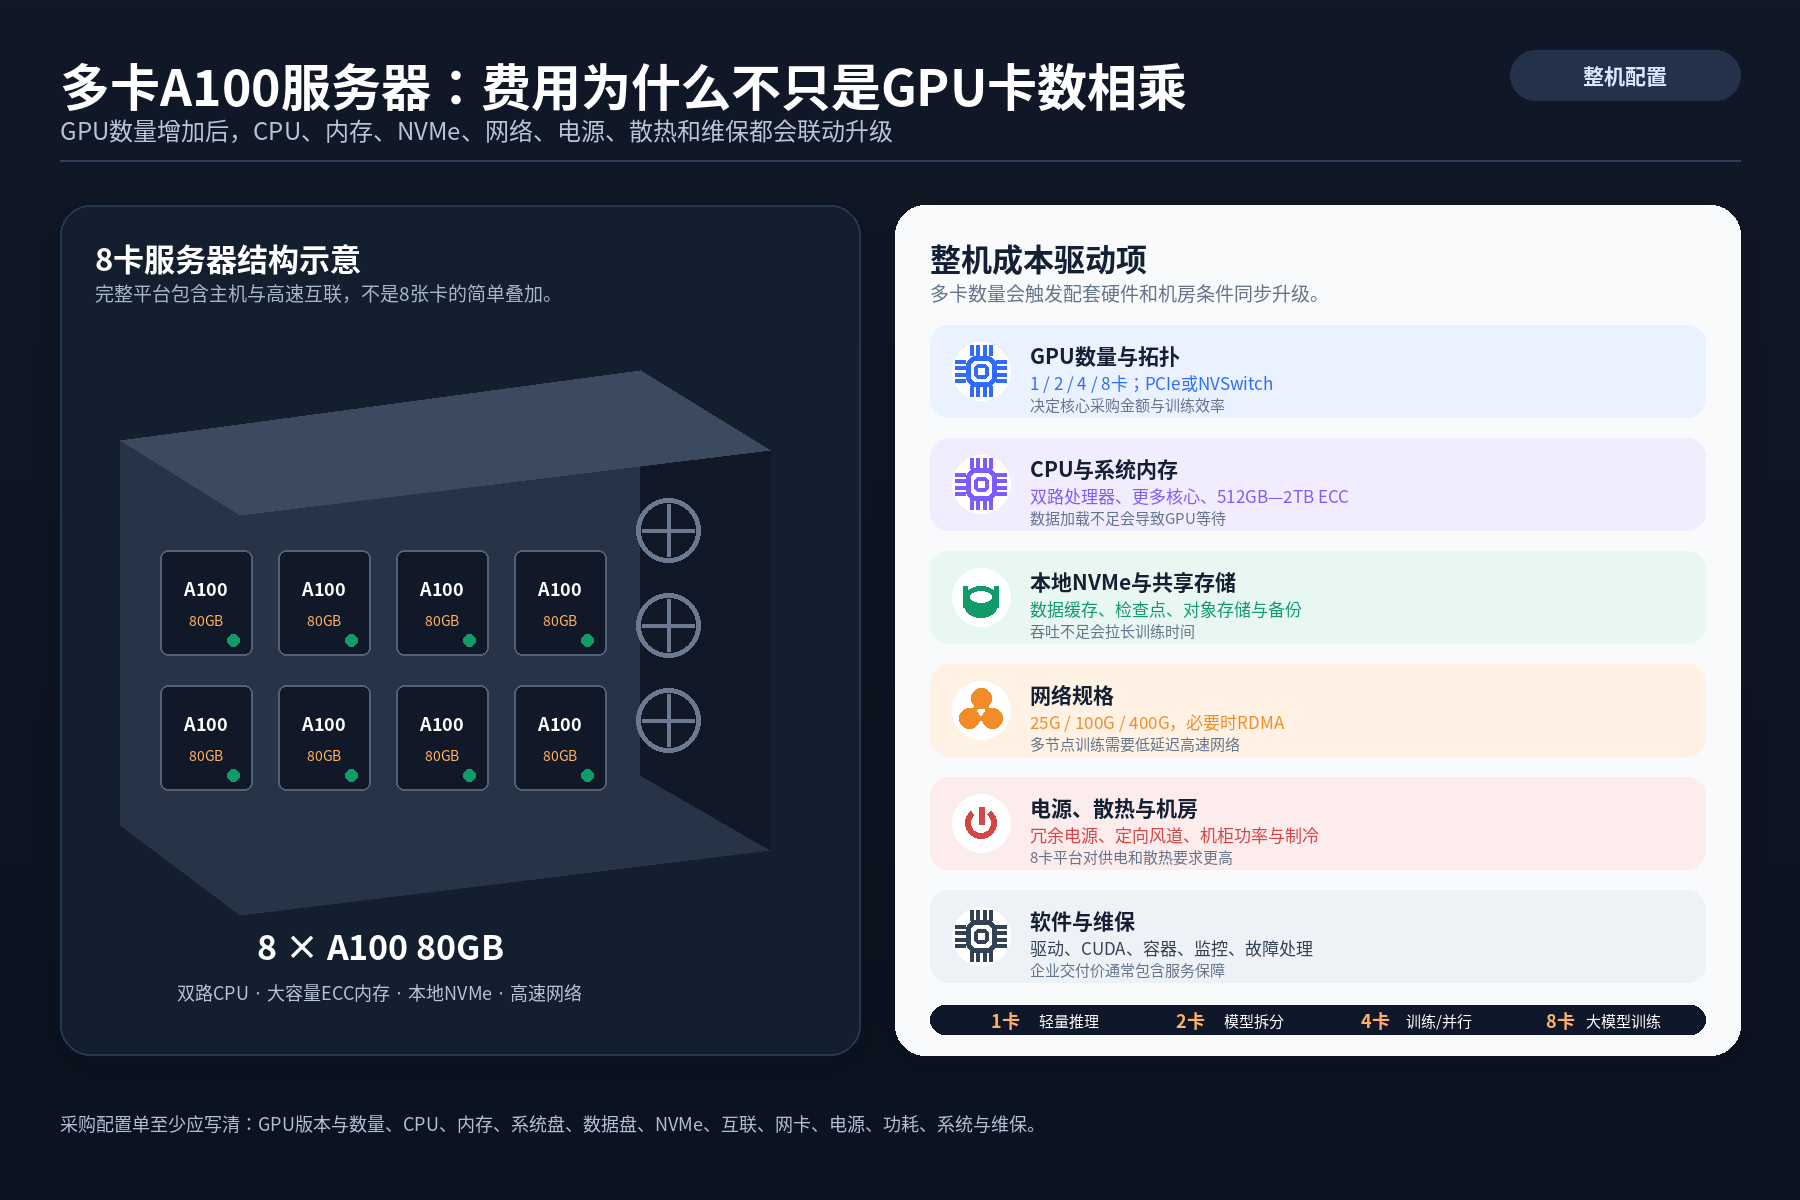
(三)8卡训练服务器
按照AWS容量块公开价格,8张A100 80GB实例约17.712美元/小时,折合约120元/小时。按730小时线性计算约8.76万元/月,按12个月线性计算约105万元/年。该数字只是一种公开配置的预算样本,并不代表所有8卡A100资源都采用相同价格和购买条件。
判断8卡资源应该租还是买,可以使用下面的方式估算:
买断三年总成本=整机采购+机柜电力+网络+维保备件+部署运维+软件费用-残值
云租三年总成本=实例小时价格×实际小时数+存储+流量+托管服务
如果8卡服务器全年高负载运行,并且企业具备机房、电力、网络和运维条件,买断可能值得评估;如果一年只集中训练几次,或者GPU型号可能很快调整,按项目租用通常更灵活。
四、2026年A100 80GB还值得选吗
(一)哪些项目继续选择A100更合理
A100虽然不是最新一代GPU,但其CUDA生态成熟,具备80GB HBM2e显存、较高显存带宽、MIG以及成熟的训练和HPC适配能力。对于已经在A100环境完成验证、迁移成本较高,或者更看重成熟度和资源成本的项目,A100仍然具有实际使用价值。
如果企业现有模型在单张或多张A100上已经能够满足训练周期和推理延迟,没有必要仅因为出现新型号就立即更换。GPU选型应比较“完成一次训练需要多少钱”或“每百万Token成本是多少”,而不是只比较单卡每小时价格。
(二)什么时候应该比较H100、H200或B200
H100更适合关注训练速度、高吞吐推理和新一代Transformer计算能力的项目,其SXM版本拥有80GB显存和3.35TB/s显存带宽。H200进一步提高到141GB HBM3e显存和4.8TB/s带宽,对于受显存容量、KV Cache或内存带宽限制的大模型业务更值得比较。
B200则更偏向新一代大规模AI训练和高吞吐推理平台。企业需要考虑的不只是GPU采购价格,还包括Blackwell整机平台、NVLink网络、功耗、机柜承载和软件适配,不能把B200简单看成一张性能更高的A100替代卡。NVIDIA的DGX B200系统采用8张B200 GPU,体现了这类产品更强的系统级部署属性。
(三)什么时候L40S或L4成本更合适
并非所有AI业务都需要80GB HBM显存。L40S配备48GB显存,同时面向生成式AI、推理、训练、3D图形、渲染和视频工作负载;L4配备24GB显存,采用低矮单槽设计,功耗约72W,更适合视频编解码、视觉AI和中小模型推理。
目前,聚搜云可提供A100、H100、H200、L40S、L4、B200等GPU云服务器、GPU算力及企业级GPU计算资源。实际选型应把不同型号放在相同模型、精度、并发量、GPU数量和使用周期下测试,比较任务完成时间与整体成本,而不是默认最新GPU一定更省钱,也不能因为A100单价较低就忽略训练效率。
五、A100 80G服务器采购前需要确认什么
(一)先提供模型和任务信息
采购前应明确具体模型名称、参数量、训练还是推理、权重精度、上下文长度、并发量、数据集大小和期望完成时间。只提供“要部署大模型”或“需要一台A100”,无法准确计算显存和GPU数量。
(二)明确GPU交付形态
需要确认采购的是A100 80GB PCIe单卡服务器、SXM4/HGX多卡服务器、裸金属GPU服务器、虚拟GPU实例,还是按小时使用的GPU算力。不同交付形态即使显示同一个GPU型号,性能隔离、拓扑和费用结构也可能不同。
(三)确认是否必须独享整卡
生产推理、性能测试和长时间训练通常更关注独享资源;开发测试和多个小模型并行运行,则可以评估MIG或其他切分方式。采购时要确认控制台中显示的80GB是否代表整张物理卡,避免把显存分片资源与独享A100进行价格比较。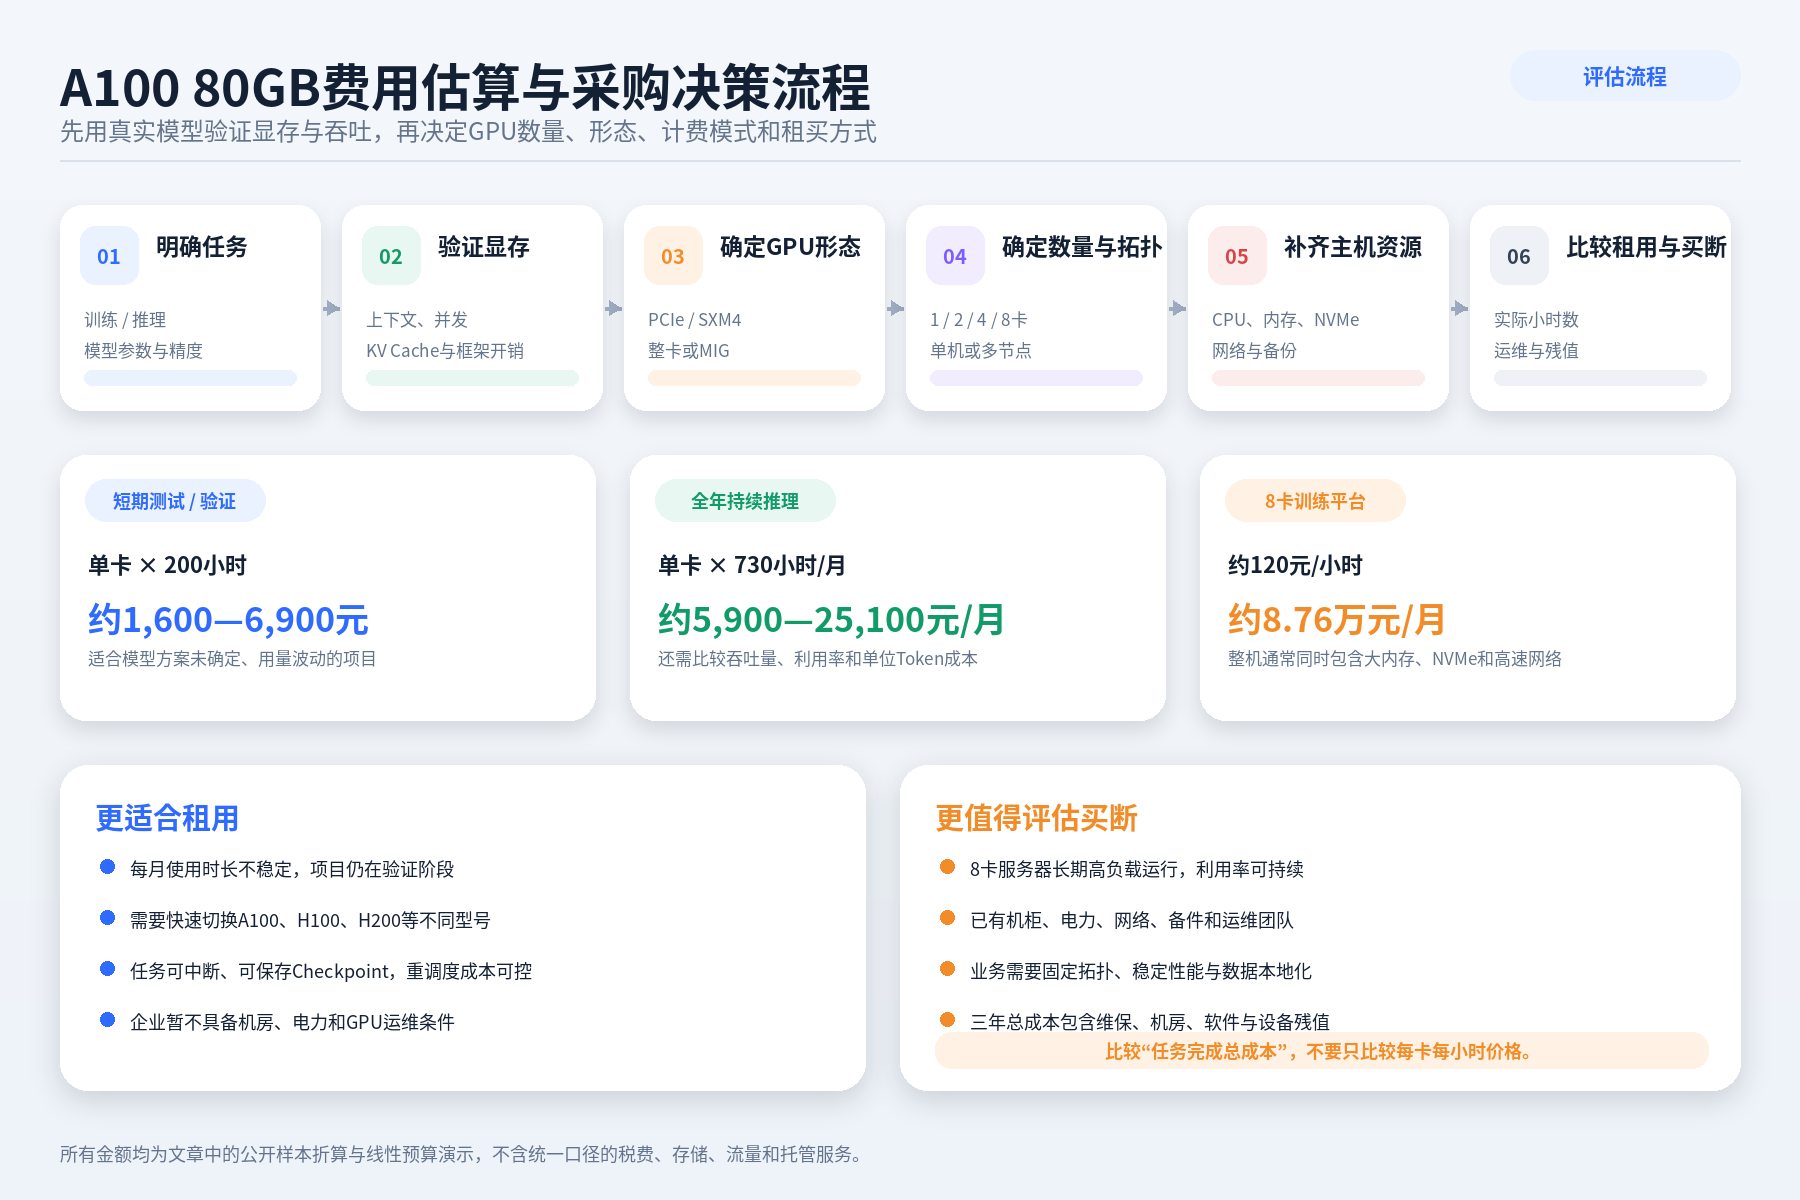
(四)核对整机配套参数
完整配置单至少应包含GPU版本及数量、CPU型号和数量、系统内存、系统盘、数据盘、本地NVMe、GPU互联方式、服务器网卡、冗余电源、功耗、机箱规格、操作系统、驱动版本、CUDA环境和维保期限。
(五)二手卡需要增加检测环节
采购二手或拆机A100时,应核对序列号、固件、显存容量、ECC错误记录、温度、功耗、压力测试结果、板卡外观、维修记录和剩余保修。仅通过nvidia-smi识别到型号,并不能证明板卡适合企业长期高负载运行。
(六)云租赁需要核对隐藏成本
云服务器应重点检查实例关机后是否继续收取磁盘费用、公网出流量如何计费、快照和镜像是否收费、IP是否保留、资源是否会被中断,以及跨区域读取数据是否产生额外费用。很多项目超预算并不是GPU小时单价过高,而是资源没有及时释放或数据传输方式不合理。
六、结语
A100 80G GPU服务器的实际价格,既可能是按小时计算的单卡云资源,也可能是一台包含4张或8张GPU、NVSwitch、高速网络和大容量内存的企业级服务器。以当前公开样本看,单卡云资源连续使用一个月约为5900—25100元,8卡云实例约有8.76万元/月的公开参考;购买GPU卡本体则大致进入数万元级,完整多卡服务器需要根据整套配置单独测算。
企业真正确定方案时,应先明确模型规模、显存占用、GPU数量、训练或推理需求、使用周期和可接受的任务完成时间,再比较PCIe、SXM4、A100、H100、H200及其他型号。聚搜云在企业GPU产品选型与部署中,会把GPU算力、主机配置、存储网络和长期使用成本放在同一套模型中评估,避免只根据一张A100的表面价格作出采购决定。

- 点赞
- 收藏
- 关注作者
评论(0)