云原生技术之kubernetes 组件介绍
01 - kubernetes 组件介绍
什么是容器编排
容器技术的核心概念是容器、镜像、仓库,使用这三大基本要素我们就可以轻松地完成应用的打包、分发工作,实现“一次构建,到处运行”的梦想。
不过,当我们熟练地掌握了容器技术,信心满满地要在服务器集群里大规模实施的时候,却会发现容器技术的创新只是解决了运维部署工作中一个很小的问题。现实生产环境的复杂程度实在是太高了,除了最基本的安装,还会有各式各样的需求,比如服务发现、负载均衡、状态监控、健康检查、扩容缩容、应用迁移、高可用等等。
虽然容器技术开启了云原生时代,但它也只走出了一小步,再继续前进就无能为力了,因为这已经不再是隔离一两个进程的普通问题,而是要隔离数不清的进程,还有它们之间互相通信、互相协作的超级问题,困难程度是指数级别的上升。
这些容器之上的管理、调度工作,就是这些年最流行的词汇:“容器编排”(Container Orchestration)。
容器编排这个词听起来好像挺高大上,但如果你理解了之后就会发现其实也并不神秘。像我们在 Docker 课里使用 Docker Compose 部署 WordPress 网站的时候,就是一种在单机环境下的容器编排。
面对单机上的几个容器,Docker Compose 还可以应付,但如果规模上到几百台服务器、成千上万的容器,处理它们之间的复杂联系就必须要依靠计算机了,而目前计算机用来调度管理的“事实标准”就是 Kubernetes。
什么是 Kubernetes
Kubernetes 背后有 Borg 系统十多年生产环境经验的支持,技术底蕴深厚,理论水平也非常高,一经推出就引起了轰动。然后在 2015 年,Google 又联合 Linux 基金会成立了CNCF(Cloud Native Computing Foundation,云原生基金会),并把 Kubernetes 捐献出来作为种子项目。
有了 Google 和 Linux 这两大家族的保驾护航,再加上宽容开放的社区,作为 CNCF 的“头把交椅”,Kubernetes 旗下很快就汇集了众多行业精英,仅用了两年的时间就打败了同期的竞争对手 Apache Mesos 和 Docker Swarm,成为了这个领域的唯一霸主。
那么,Kubernetes 到底能够为我们做什么呢?
简单来说,Kubernetes 就是一个生产级别的容器编排平台和集群管理系统,不仅能够创建、调度容器,还能够监控、管理服务器,它凝聚了 Google 等大公司和开源社区的集体智慧,从而让中小型公司也可以具备轻松运维海量计算节点——也就是“云计算”的能力。
Kubernetes 的官网(https://kubernetes.io/zh/),里面有非常详细的文档,包括概念解释、入门教程、参考手册等等,最难得的是它有全中文版本,我们阅读起来完全不会有语言障碍,如果你有时间可以多上去看看,及时获取官方第一手知识。
云原生时代的操作系统
Kubernetes 是一个生产级别的容器编排平台和集群管理系统,能够创建、调度容器,监控、管理服务器。
容器是什么?容器是软件,是应用,是进程。服务器是什么?服务器是硬件,是 CPU、内存、硬盘、网卡。那么,既可以管理软件,也可以管理硬件,这样的东西应该是什么?这就是一个操作系统(Operating System)!
没错,从某种角度来看,Kubernetes 可以说是一个集群级别的操作系统,主要功能就是资源管理和作业调度。但 Kubernetes 不是运行在单机上管理单台计算资源和进程,而是运行在多台服务器上管理几百几千台的计算资源,以及在这些资源上运行的上万上百万的进程,规模要大得多。
所以,你可以把 Kubernetes 与 Linux 对比起来学习,而这个新的操作系统里自然会有一系列新名词、新术语,你也需要使用新的思维方式来考虑问题。
Kubernetes 的基本架构
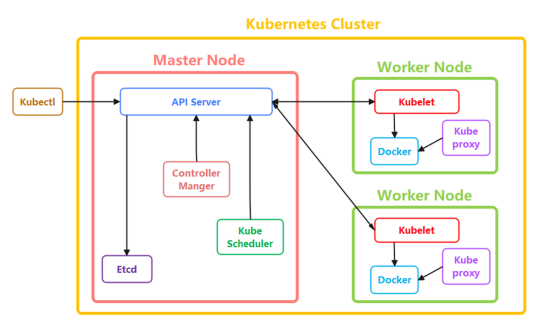
Kubernetes 采用的是 “控制面 / 数据面”(Control Plane / Data Plane)架构,集群里的计算机被称为“节点”(Node),可以是实机也可以是虚机,少量的节点用作控制面来执行集群的管理维护工作,其他的大部分节点都被划归数据面,用来跑业务应用。
控制面的节点在 Kubernetes 里叫做 Master Node,一般简称为 Master,它是整个集群里最重要的部分,可以说是 Kubernetes 的大脑和心脏。
数据面的节点叫做 Worker Node,一般就简称为 Worker 或者 Node,相当于 Kubernetes 的手和脚,在 Master 的指挥下干活 。
Node 的数量非常多,构成了一个资源池,Kubernetes 就在这个池里分配资源,调度应用。因为资源被“池化”了,所以管理也就变得比较简单,可以在集群中任意添加或者删除节点。
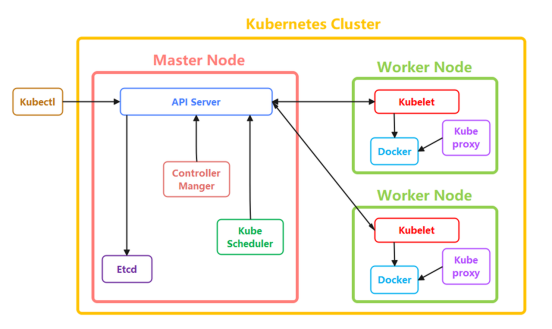
在这张架构图里,我们还可以看到有一个 kubectl,它就是 Kubernetes 的客户端工具,用来操作 Kubernetes,但它位于集群之外,理论上不属于集群。
可以使用命令 kubectl get node 来查看 Kubernetes 的节点状态:
|
YAML |
可以看到当前集群中有一个控制面的 Master 节点和一个数据面的 Worker 节点,如果集群规模较小,也可以把 Master 和 Worker 部署在一个节点上。
节点内部的结构
Kubernetes 的节点内部也具有复杂的结构,是由很多的模块构成的,这些模块又可以分成组件(Component)和插件(Addon)两类。
组件实现了 Kubernetes 的核心功能特性,没有这些组件 Kubernetes 就无法启动,而插件则是 Kubernetes 的一些附加功能,属于“锦上添花”,不安装也不会影响 Kubernetes 的正常运行。
Master 里的组件有哪些
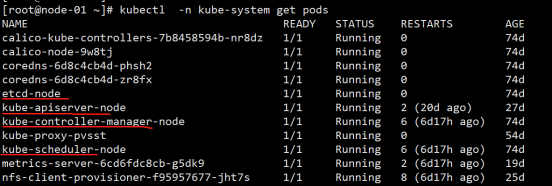
Master 里有 4 个组件,分别是 apiserver、etcd、scheduler、controller-manager。
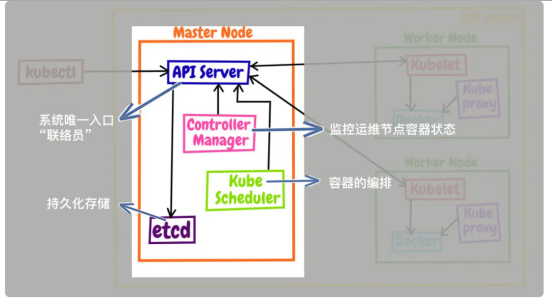
kube-apiserver 是 Master 节点——同时也是整个 Kubernetes 系统的唯一入口,它对外公开了一系列的 RESTful API,并且加上了验证、授权等功能,所有其他组件都只能和它直接通信,可以说是 Kubernetes 里的联络员。
etcd 是一个高可用的分布式 Key-Value 数据库,用来持久化存储系统里的各种资源对象和状态,相当于 Kubernetes 里的配置管理员。注意它只与 apiserver 有直接联系,也就是说任何其他组件想要读写 etcd 里的数据都必须经过 apiserver。
kube-scheduler 负责容器的编排工作,检查节点的资源状态,把 Pod 调度到最适合的节点上运行,相当于部署人员。因为节点状态和 Pod 信息都存储在 etcd 里,所以 scheduler 必须通过apiserver 才能获得。
kube-controller-manager 负责维护容器和节点等资源的状态,实现故障检测、服务迁移、应用伸缩等功能,相当于监控运维人员。同样地,它也必须通过 apiserver 获得存储在 etcd 里的信息,才能够实现对资源的各种操作。
这 4 个组件也都被容器化了,运行在集群的 Pod 里,我们可以用 kubectl 来查看它们的状态,使用命令:
|
YAML |
注意命令行里要用 -n kube-system 参数,表示检查“kube-system”名字空间里的 Pod,至于名字空间是什么,我们后面会讲到。
Node 里的组件有哪些
Master 里的 kube-apiserver、kube-scheduler 等组件需要获取节点的各种信息才能够作出管理决策,那这些信息该怎么来呢?
这就需要 Node 里的 3 个组件了,分别是 kubelet、kube-proxy、container-runtime。
kubelet 是 Node 的代理,负责管理 Node 相关的绝大部分操作,Node 上只有它能够与 kube-apiserver 通信,实现状态报告、命令下发、启停容器等功能,相当于是 Node 上的一个“小管家”。
kube-proxy 的作用有点特别,它是 Node 的网络代理,只负责管理容器的网络通信,简单来说就是为 Pod 转发 TCP/UDP 数据包,相当于是专职的“小邮差”。
第三个组件 container-runtime 我们就比较熟悉了,它是容器和镜像的实际使用者,在 kubelet 的指挥下创建容器,管理 Pod 的生命周期,是真正干活的“苦力”。
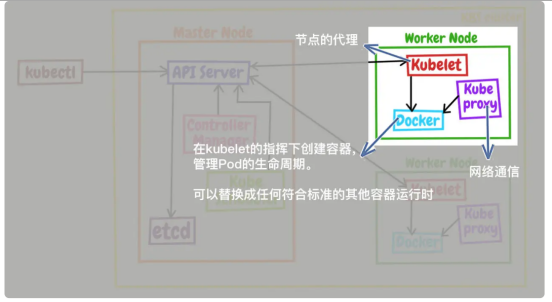
我们一定要注意,因为 Kubernetes 的定位是容器编排平台,所以它没有限定 container runtime 必须是 Docker,完全可以替换成任何符合标准的其他容器运行时,例如 containerd、CRI-O 等等,只不过在这里我们使用的是 Docker。
这 3 个组件中只有 kube-proxy 被容器化了,而 kubelet 因为必须要管理整个节点,容器化会限制它的能力,所以它必须在 container-runtime 之外运行。
现在,我们再把 Node 里的组件和 Master 里的组件放在一起来看,就能够明白 Kubernetes
的大致工作流程了:
- 每个 Node 上的 kubelet 会定期向 kube-apiserver 上报节点状态,kube-apiserver 再存到 etcd 里。
- 每个 Node 上的 kube-proxy 实现了 TCP/UDP 反向代理,让容器对外提供稳定的服务。
- kube-scheduler 通过 kube-apiserver 得到当前的节点状态,调度 Pod,然后 kube-apiserver 下发命令给某
个 Node 上的 kubelet,kubelet 调用 container-runtime 启动容器。 - controller-manager 也通过 kube-apiserver 得到实时的节点状态,监控可能的异常情况,再使用相应的手段去调节恢复。
其实,这和我们在 Kubernetes 出现之前的操作流程也差不了多少,但 Kubernetes 的高明之处就在于把这些都抽象化规范化了。
于是,这些组件就好像是无数个不知疲倦的运维工程师,把原先繁琐低效的人力工作搬进了高效的计算机里,就能够随时发现集群里的变化和异常,再互相协作,维护集群的健康状态。
插件(Addons)有哪些
只要服务器节点上运行了 kube-apiserver、kube-scheduler、kube-controller-manager、etcd、kubelet、kube-proxy、container-runtime 组件,就可以说是一个功能齐全的 Kubernetes 集群了。
由于 Kubernetes 本身的设计非常灵活,所以就有大量的插件用来扩展、增强它对应用和集群的管理能力。
常用的插件有:
- DNS: 负责为整个集群提供DNS服务;
- Ingress Controller:为服务提供外网入口;
- MetricsServer:提供资源监控;
- Dashboard:提供GUI;

- 点赞
- 收藏
- 关注作者
评论(0)