Pony适配GaussDB开源开发任务
1 背景介绍
开源for Huawei(参考:https://developer.huaweicloud.cn/programs/opensource/contributing/)通过和公司、高校、社区的开发者合作,完成鲲鹏、昇腾、欧拉、鸿蒙、高斯、云服务等与开源软件的适配开发,帮助繁荣Huawei的基础生态,同时让开源软件能够更加简单、高效的运行于华为云上。
开始之前,开发者可以下载 开源for Huawei Wiki(参考:https://gitcode.com/HuaweiCloudDeveloper/OpenSourceForHuaweiWiki/overview) 了解详细的开发步骤,技术准备,以及开发过程需要的各种资源。
2 需求分析
2.1 项目影响力
Pony ORM 是一个高级的对象关系映射器(ORM),它允许开发者以 Python 对象的形式处理数据库内容。它以其简洁的 API 和高效的性能著称,设计灵感来自于 SQLAlchemy 和 Django ORM。Pony ORM 支持多种数据库引擎,包括 SQLite, MySQL, PostgreSQL, Oracle 等,并且能够让开发者用面向对象的方式来处理数据,无需直接编写 SQL 语句,从而提高了开发效率和代码可读性。
Pony ORM的主要功能:
1. 对象映射:Pony ORM 允许开发者将 Python 类映射到数据库表,使得可以使用面向对象的方式来处理数据库操作。
2. 自动 SQL 生成:Pony ORM 能够根据 Python 代码自动生成 SQL 语句,这意味着开发者无需手动编写 SQL 代码。
3. 查询构建器:提供了强大的查询构建器,支持复杂的查询操作,包括过滤、排序、分组、聚合等。
4. 事务管理:Pony ORM 提供了自动和手动两种事务管理方式,确保数据的一致性和完整性。
5. 缓存机制:Pony ORM 实现了 Identity Map 模式,自动缓存查询结果,避免重复查询带来的性能问题。
6. 延迟加载:支持延迟加载(Lazy Loading)和即时加载(Eager Loading),可以根据需要优化数据加载策略。
7. 复合主键支持:Pony ORM 支持复合主键,允许在模型中定义由多个字段组成的主键。
8. 关系定义:支持定义模型之间的关系,如一对一、一对多和多对多关系,并自动处理外键。
9. 数据库迁移:虽然 Pony ORM 不提供自动化的数据库迁移工具,但它允许开发者通过编写代码来管理数据库结构的变化。
10. 多种数据库支持:Pony ORM 支持多种数据库后端,包括 SQLite、MySQL、PostgreSQL、Oracle 等。
11. 高级特性:如支持使用 Python 生成器表达式或 lambda 函数编写查询,以及使用事务装饰器来管理事务。
12. 优化的 N+1 查询问题:Pony ORM 提供了优雅的解决方案来处理 N+1 查询问题,这是 ORM 中常见的性能问题。
13. 可扩展性:Pony ORM 允许开发者自定义类型映射和数据库操作,提供了高度的可扩展性。
14. 良好的文档和社区支持:Pony ORM 拥有详尽的官方文档和活跃的社区,为开发者提供了丰富的学习资源和问题解决途径。
所属社区:
Pony ORM 的作者是 Alexey Gaynutdinov,他是一位经验丰富的软件开发者,对数据库和 ORM 技术有深入的研究。Pony ORM 的开发和维护是由其作者和Pony社区共同进行的。
源代码地址:https://github.com/ponyorm/pony/tree/main
官网主页:https://ponyorm.org/
主要开发语言:Python
用户使用情况:
Pony ORM 的用户使用情况广泛,它适用于需要数据库交互的 Python 项目,特别是在 Web 开发、数据分析或任何需要持久化数据的场景。由于其简洁的语法,Pony ORM 也适合初学者快速上手数据库编程。
主要商业价值:
1. 提高开发效率:Pony ORM 提供了简洁直观的 API 设计,使得开发者可以快速上手并进行数据库操作,从而加快开发速度。
2. 强大的查询功能:支持丰富的查询功能,包括过滤、排序、聚合等,能够满足各种复杂的查询需求,帮助开发者高效地处理数据。
3. 多数据库支持:Pony ORM 支持多种常见的数据库后端,如 SQLite、MySQL、PostgreSQL 等,提供了灵活的数据库选择,方便项目迁移与扩展。
4. 自动化数据库迁移:能够自动化处理数据库迁移,简化了数据库结构的变更和管理过程,减少了维护成本。
5. 代码可读性和维护性:通过面向对象的方式处理数据,提高了代码的可读性和易维护性,有利于长期项目的维护和发展。
6. 社区和文档支持:拥有活跃的社区和详尽的官方文档,为开发者提供了丰富的学习资源和问题解决途径,降低了学习和使用的成本。
7. 商业授权:对于商业用途,Pony ORM 提供了多种授权选项,包括个人和公司商业授权,确保了商业使用的合法性和安全性。
8. 适用于多种应用场景:无论是 Web 开发、数据分析还是任务调度等领域,Pony ORM 都展现了其优秀的应用价值,为开发者提供了简单而强大的数据库解决方案。
这些商业价值使得 Pony ORM 成为一个适合企业级应用开发的 ORM 工具,帮助企业提升开发效率、降低成本,并确保项目的长期可维护性。
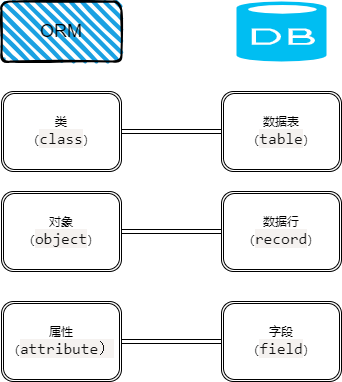
ORM与DB映射关系:
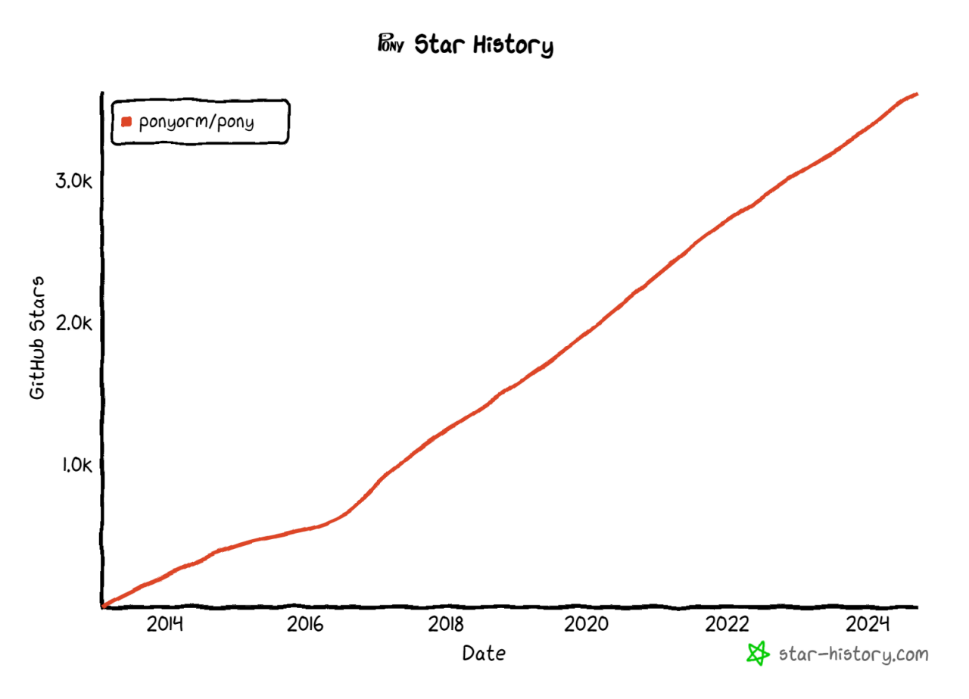
项目数据:Fork 243, Star 3.6K, Contributor 27,最近一次提交:2024-8-27 star历史(https://star-history.com/):
2.2 任务目的和范围
任务的主要目的
本任务的主要目的是让Pony库支持GaussDB数据库,帮助拓展GaussDB的影响力。同时,该任务可以为一些项目迁移打下基础,方便用户使用Pony的时候,可以选择GaussDB作为第三方数据库。
能力要求
完成该任务需要具备微服务开发经验,熟悉Python Web项目的开发(如:Django的ORM用法)。开发过程中主要使用Python语言,演示DEMO会涉及少量的Vue、TypeScirpt等前端知识。
适配任务清单
|
生态 |
生态细类 |
是否需要验证 |
验证逻辑说明 |
是否需要适配 |
适配场景说明 |
|
昇腾生态 |
指令 |
否 |
使用昇腾处理器运行应用。 |
否 |
使用昇腾指令实现适配逻辑。 |
|
CANN |
否 |
应用功能依赖于CANN运行。 |
否 |
使用CANN实现适配逻辑。 |
|
|
MindSpore |
否 |
应用功能依赖于MindSpore运行。 |
否 |
使用MindSpore实现适配逻辑。 |
|
|
鲲鹏生态 |
指令 |
是 |
使用鲲鹏处理器运行应用。 |
否 |
使用鲲鹏指令实现适配逻辑。 |
|
Euler |
是 |
使用Euler系统运行应用。 |
否 |
使用Euler系统调用实现适配逻辑。 |
|
|
数据库生态 |
GaussDB |
是 |
使用GaussDB功能。 |
是 |
使用GaussDB的驱动和SQL实现适配逻辑。 |
|
GaussDB(DWS) |
否 |
使用GaussDB(DWS)功能。 |
否 |
使用GaussDB(DWS)的驱动和SQL实现适配逻辑。 |
|
|
存储生态 |
OBS |
否 |
使用OBS功能。 |
否 |
基于OBS API访问实现适配逻辑。 |
|
鸿蒙生态 |
HarmonyOS |
否 |
使用HarmonyOS系统运行应用。 |
否 |
使用HarmonyOS系统调用实现适配逻辑。 |
3 工作量评估和任务分解
3.1 工作量评估
|
任务 |
人/天 |
|
完成GaussDB数据库适配功能开发 |
2 |
|
完成DEMO设计和功能验证 |
2 |
|
基于CCE容器完成环境搭建和DEMO验证 |
2 |
|
输出开发资料和博客 |
1 |
|
代码推送上游社区和发布版本 |
2 |
|
总计 |
9人天 |
3.2 完成GaussDB数据库适配功能开发
• 可以使用兼容GaussDB的数据库驱动 psycopg2,但可能需要对其进行扩展或定制以支持GaussDB特有的功能。
• 在GitCode完成项目Fork (https://github.com/ponyorm/pony/tree/main/pony/orm/dbproviders),并完成GaussDB数据库引擎的适配开发,然后保证新的数据库引擎被正确导入和注册。
• 在自定义的数据库引擎模块中,实现所有必要的数据库操作方法,并添加特定的方言支持。如果GaussDB有特定的SQL语法或函数,应该在数据库后端实现这些特性。
• 如果GaussDB存在特定的数据类型,可能需要在Pony的模型字段中去更新相对应的字段类型 https://github.com/ponyorm/pony/blob/main/pony/orm/core.py。
Pony默认不支持分布式数据库。这可能需要开发中间件或自定义数据库路由来处理数据分片和查询路由。
3.3 完成GaussDB演示DEMO设计
DEMO的简单部署图如下:
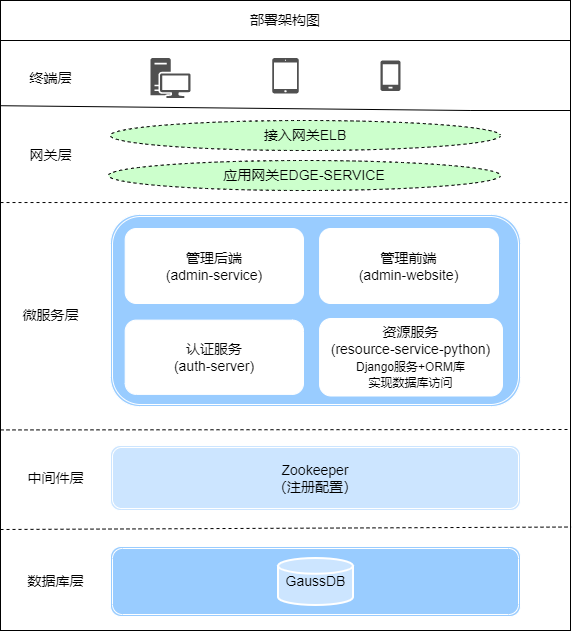
Pony 本身不直接使用DBAPI(数据库API),但是它是建立在DBAPI之上的,最终都需要依赖于DBAPI兼容的数据库驱动来与数据库进行通信。
3.4 DEMO开发、部署和验证
根据DEMO设计,完成演示功能开发和部署。要求使用CCE容器(Euler镜像)进行部署。
为了简化用户开发,提供了一个项目脚手架。开发者可以在脚手架基础上,完成DEMO功能开发。可以参考: https://gitcode.com/HuaweiCloudDeveloper/OpenSourceForHuaweiWiki/blob/main/README.md 提供的指导,可以帮助您在华为云开通资源、编译DEMO和基于DEMO做增量代码开发。
3.5 在华为云开发者论坛输出博客
访问华为云开发者论坛(参考:https://bbs.huaweicloud.cn/blogs)发表博客,介绍完成这些任务的过程和心得。内容包括不限于如下内容:
·开源for Huawei的背景
·开源软件的功能介绍
·开发适配过程及碰到和解决的问题
·DEMO设计、开发、部署过程
·代码推送开源社区及互动过程
博客打上如下标签:
·开源(必选)
·开发者(必选)
·GaussDB数据库(可选)
·云数据库 GaussDB(可选)
· 鲲鹏(可选)
·昇腾(可选)
·鸿蒙(可选)
·对象存储 OBS(可选)
3.6 代码推送上游社区
将代码合并到Pony官网主干代码;更新Pony官网资料,包括版本说明、开发指南等。
Pony仓库地址:https://github.com/ponyorm/pony/blob/main/pony/orm/core.py
4 验收材料
|
验收细则 |
评分说明 |
是否为验收必选项 |
结果(通过/不通过) |
开发者举证 |
|
功能开发:完成与华为三大根技术生态(鲲鹏云、昇腾云、鸿蒙)适配的功能开发 |
完成GaussDB数据库适配功能开发。举证提供PR链接。 |
是 |
|
|
|
代码质量:适配华为三大根技术生态的代码质量经过工具检测达标 |
推送给开源社区的代码符合开源社区关于代码风格、功能、自动化测试等要求。 |
是 |
|
|
|
提供相关文档,比如部署文档、使用文档、配置文档等 |
根据社区要求,完善相关的开发指南和部署指导 |
否 |
|
|
|
合入到开源项目主仓:代码推送上游社区 |
代码合并到当前主干分支。举证提供代码仓库链接。 |
是 |
|
|
|
Deomo设计&开发:完成功能演示Demo的开发 |
举证提供DEMO仓库地址和DEMO开发提交记录。 |
是 |
|
|
|
Demo部署&验证:完成功能演示DEMO基于华为云鲲鹏环境的部署和功能验证 |
提供DEMO部署验证结果的关键截图进行举证。提供DEMO运行环境和资源的规格清单。 |
是 |
|
|
|
发布博客:发布博客介绍适配心得。 |
提供博客的地址。 |
是 |
|
|
|
制作单机版无高危开源镜像。 |
上架云商店。 |
否 |
|
|
|
单机版镜像上架时支持模板部署。 |
|
否 |
|
|
|
制作集群版无高危开源镜像 |
上架云商店。 |
否 |
|
|
|
集群版镜像上架时支持模板部署 |
|
否 |
|
|
5 参考资料
1. 开源for Huawei介绍、环境搭建、示例项目、开发和部署指南:https://gitcode.com/HuaweiCloudDeveloper/OpenSourceForHuaweiWiki/overview

- 点赞
- 收藏
- 关注作者
评论(0)