【数据结构】什么是二叉搜索(排序)树?
🦄个人主页:修修修也
⚙️操作环境:Visual Studio 2022

 编辑
目录
📌二叉搜索(排序)树的概念
我们今天要介绍的树是一种非常适合于搜索/排序的树, 当然二叉搜索(排序)树的前提是它是一颗树,并且是一颗二叉树。因此对于树以及二叉树的定义还有不太了解的朋友建议先移步这两篇博客补充一下数据结构树的相关前置知识:
【数据 结 构】什么是 树 ?  https://blog.csdn.net/weixin_72357342/article/details/134973723?spm=1001.2014.3001.5502
【数据 结 构】什么是二叉 树 ?  https://blog.csdn.net/weixin_72357342/article/details/135162895?sharetype=blogdetail&sharerId=135162895&sharerefer=PC&sharesource=weixin_72357342&spm=1011.2480.3001.8118
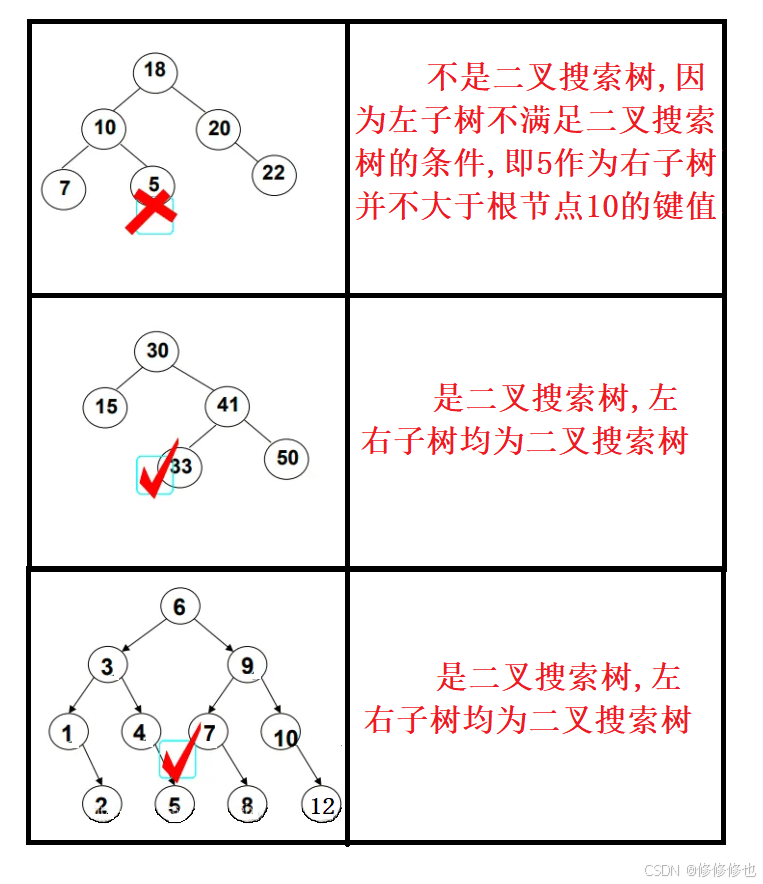
二叉搜索树(BST, Binary Search Tree) 也称二叉排序树或二叉查找树。它或是一颗空树,或是具有下列性质的二叉树:
• 若它的左子树不为空,则左子树上所有结点的值均小于它的根节点的值。
• 若它的右子树不为空,则右子树上所有结点的值均大于它的根节点的值。
• 它的左右子树也分别为二叉搜索树。
下图罗列了部分属于/不属于二叉搜索树的二叉树以供参考:
 编辑
对于二叉搜索树而言,其中序遍历的结果恰好是树中所有结点值的有序排列,因此特性也称其为二叉排序树。构造一棵二叉排序树的目的,其实并不是为了排序,而是为了提高查找和插入删除关键字的速度。不管怎么说,在一个有序数据集上的查找,速度总是要快于无序的数据集的,而二叉排序树这种非线性的结构,同样有利于插入和删除操作的实现。
📌二叉搜索(排序)树的操作
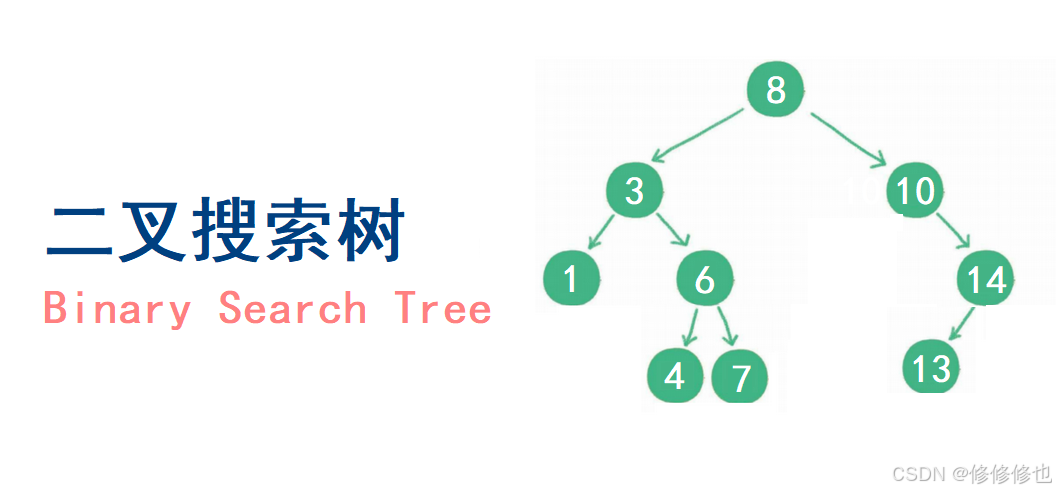
以如下二叉搜索树为例, 分别剖析二叉搜索树的查找,插入和删除操作:
 编辑
int a[] = { 8, 3, 1, 10, 6, 4, 7, 14, 13 };

🎏二叉搜索树的查找
二叉搜索树的查找过程如下:
1. 从根节点开始比较查找, 如果查找值比根结点值大,则往右子树继续查找; 如果查找值比根结点值小,则往左子树继续查找;
2. 最多查找高度次, 即查找到叶子节点, 如果还没找到, 则该值不存在于此树中。

 编辑
🎏二叉搜索树的插入
二叉搜索树的插入过程如下:
1. 树为空,则直接新增节点,赋值给根节点指针
2. 树不为空,则按二叉搜索树性质查找插入位置, 在查找到为空的位置插入新增值, 如果查找到该值已存在, 则返回查找失败(二叉搜索树不允许插入重复值)

 编辑
🎏二叉搜索树的删除
查找元素是否在二叉搜索中,如果不存在,则返回,如果存在,则待删除结点可能存在以下四种情况:
1. 待删除结点无孩子结点
2. 待删除结点只有左孩子结点(不管右孩子)
3. 待删除结点只有右孩子结点(不管左孩子)
4. 待删除结点左,右孩子结点都有
在实际删除操作中,可以将1和2 / 3合并起来,因为我们的逻辑是哪边有孩子就管理,没有孩子就可以不管,因此无孩子结点既可以和不管右孩子结点情况合并又可以和不管左孩子情况合并,合并后实际的删除情况及过程如下三种:
1. 删除该结点且使被删除节点的双亲结点指向被删除节点的左孩子结点--直接删除
2. 删除该结点且使被删除节点的双亲结点指向被删除结点的右孩子结点--直接删除
3. 在它的右子树中寻找中序下的第一个结点(关键码最小),用它的值填补到被删除节点中,再来处理该结点的删除问题--替换法删除

 编辑
📌二叉搜索(排序)树的实现
由于本文偏向理论概念,篇幅有限,因此关于使用C++具体实现二叉搜索(排序)树的详细过程我放在下面这篇文章中了,有需要的朋友可以移步这篇博客,里面有非常详细的使用C++实现二叉搜索(排序)树的详解:【C++】模 拟实现 二叉搜索 (排序) 树  https://blog.csdn.net/weixin_72357342/article/details/142413312?spm=1001.2014.3001.5502 文章目录概览:

 编辑
📌二叉搜索(排序)树的应用
🎏K模型
K模型:K模型即只有key作为关键码,结构中只需要存储Key即可,关键码即为需要搜索到的值。
比如:给一个单词word,判断该单词是否拼写正确,具体方式如下:
• 以词库中所有单词集合中的每个单词作为key,构建一棵二叉搜索树
• 在二叉搜索树中检索该单词是否存在,存在则拼写正确,不存在则拼写错误。
🎏KV模型
KV模型:每一个关键码key,都有与之对应的值Value,即<Key, Value>的键值对。该种方式在现实生活中非常常见:
• 比如英汉词典就是英文与中文的对应关系,通过英文可以快速找到与其对应的中文,英文单词与其对应的中文<word, chinese>就构成一种键值对;
• 再比如统计单词次数,统计成功后,给定单词就可快速找到其出现的次数,单词与其出现次数就是<word, count>就构成一种键值对。
二叉搜索树改key_value模型及其应用代码:
namespace key_value

{

    template<class K,class V>

    struct BSTreeNode

    {

        BSTreeNode<K,V>* _left;

        BSTreeNode<K,V>* _right;

        K _key;

        V _value;

        BSTreeNode(const K& key = K(), const V& value = V())

            :_left(nullptr)

            , _right(nullptr)

            , _key(key)

            , _value(value)

        {}

    };


    template<class K, class V>

    class BSTree

    {

        typedef BSTreeNode<K,V> Node;

    public:

        BSTree()

            :_root(nullptr)

        {}


        BSTree(const BSTree<K,V>& t)

        {

            _root = Copy(t._root);

        }


        BSTree<K,V>& operator=(BSTree<K,V> t)

        {

            swap(_root, t._root);

            return *this;

        }


        ~BSTree()

        {

            Destroy(_root);

        }


        void InOrder()

        {

            _InOrder(_root);

            cout << endl;

        }


        Node* FindR(const K& key)

        {

            return _FindR(_root, key);

        }


        bool InsertR(const K& key, const V& value)

        {

            return _InsertR(_root, key, value);

        }


        bool EraseR(const K& key)

        {

            return _EraseR(_root, key);

        }


    private:

        Node* Copy(Node* root)

        {

            if (root == nullptr)

                return nullptr;

            Node* copynode = new Node(root->_key);

            copynode->_left = Copy(root->_left);

            copynode->_right = Copy(root->_right);

            return copynode;

        }


        void Destroy(Node*& root)

        {

            if (root == nullptr)

                return;

            Destroy(root->_left);

            Destroy(root->_right);

            delete root;

            root == nullptr;

        }


        bool _EraseR(Node*& root, const K& key)

        {

            if (root == nullptr)

            {

                return false;

            }

            if (root->_key < key)

            {

                _EraseR(root->_right, key);

            }

            else if (root->_key > key)

            {

                _EraseR(root->_left, key);

            }

            else

            {

                Node* del = root;

                if (root->_left == nullptr)

                {

                    root = root->_right;

                }

                else if (root->_right == nullptr)

                {

                    root = root->_left;

                }

                else

                {

                    Node* leftMax = root->_left;

                    while (leftMax->_right)

                    {

                        leftMax = leftMax->_right;

                    }

                    swap(root->_key, leftMax->_key);

                    return _EraseR(root->_left, key);

                }

                delete del;

                return true;

            }

        }


        bool _InsertR(Node*& root, const K& key, const V& value)

        {

            if (root == nullptr)

            {

                root = new Node(key,value);

                return true;

            }

            if (root->_key < key)

            {

                _InsertR(root->_right, key, value);

            }

            else if (root->_key > key)

            {

                _InsertR(root->_left, key, value);

            }

            else

            {

                return false;

            }

        }


        Node* _FindR(Node* root, const K& key)

        {

            if (root == nullptr)

            {

                return nullptr;

            }

            if (root->_key < key)

            {

                _FindR(root->_right, key);

            }

            else if (root->_key > key)

            {

                _FindR(root->_left, key);

            }

            else

            {

                return root;

            }

        }


        void _InOrder(Node* root)

        {

            if (root == nullptr)

                return;

            _InOrder(root->_left);

            cout << root->_key << ":" << root->_value << endl;

            _InOrder(root->_right);

        }


        Node* _root;

    };


    void TestBSTree1()//小字典

    {

        BSTree<string, string> dict;

        dict.InsertR("insert", "插入");

        dict.InsertR("sort", "排序");

        dict.InsertR("right", "右边");

        dict.InsertR("date", "日期");


        string str;

        while (cin >> str)    //按Ctrl+Z终止输入

        {

            BSTreeNode<string, string>* ret = dict.FindR(str);

            if (ret)

            {

                cout << ret->_value << endl;

            }

            else

            {

                cout << "无该单词" << endl;

            }

        }

    }


    void TestBSTree2()//统计水果出现次数

    {

        string arr[] = { "苹果", "西瓜", "苹果", "西瓜", "苹果", "苹果", "西瓜","苹果", "香蕉", "苹果", "香蕉" };

        BSTree<string, int> countTree;

        for (const auto& str : arr)

        {

            // 先查找水果在不在搜索树中

            // 1、不在,说明水果第一次出现,则插入<水果, 1>

            // 2、在,则查找到的节点中水果对应的次数++

            BSTreeNode<string, int>* ret = countTree.FindR(str);

            if (ret == NULL)

            {

                countTree.InsertR(str, 1);

            }

            else

            {

                ret->_value++;

            }

        }

        countTree.InOrder();

    }

}📌二叉搜索(排序)树的性能分析
插入和删除操作都必须先查找,查找效率代表了二叉搜索树中各个操作的性能。
对有n个结点的二叉搜索树,若每个元素查找的概率相等,则二叉搜索树平均查找长度是结点在二叉搜索树的深度的函数,即结点越深,则比较次数越多。
但对于同一个关键码集合,如果各关键码插入的次序不同,可能得到不同结构的二叉搜索树:

 编辑
• 最优情况下,二叉搜索树为完全二叉树(或者接近完全二叉树),其平均比较次数为:
• 最差情况下,二叉搜索树退化为单支树(或者类似单支),其平均比较次数为:
结语
希望这篇关于 二叉搜索(排序)树 的博客能对大家有所帮助,欢迎大佬们留言或私信与我交流.
学海漫浩浩,我亦苦作舟!关注我,大家一起学习,一起进步!
相关文章推荐

 编辑

- 点赞
- 收藏
- 关注作者
评论(0)